投出去两个月,邮件回来了,大修。
附件里两位审稿人一共八条意见。第一遍读完的感觉通常不太好:有几条看着像误解,有一条直接质疑研究设计,还有一条让补一组数据,而那组数据现在根本拿不到。
然后就卡住了。不是不想改,是不知道从哪儿下手,也不知道哪些必须让步、哪些可以争。很多人在这一步耗掉两三周,最后交上去一份东一句西一句的回复,审稿人看完更不满意。
问题出在把意见当成一个整体八条意见不是一个难度层级的东西。混在一起看,就会被最难那条卡住全部。
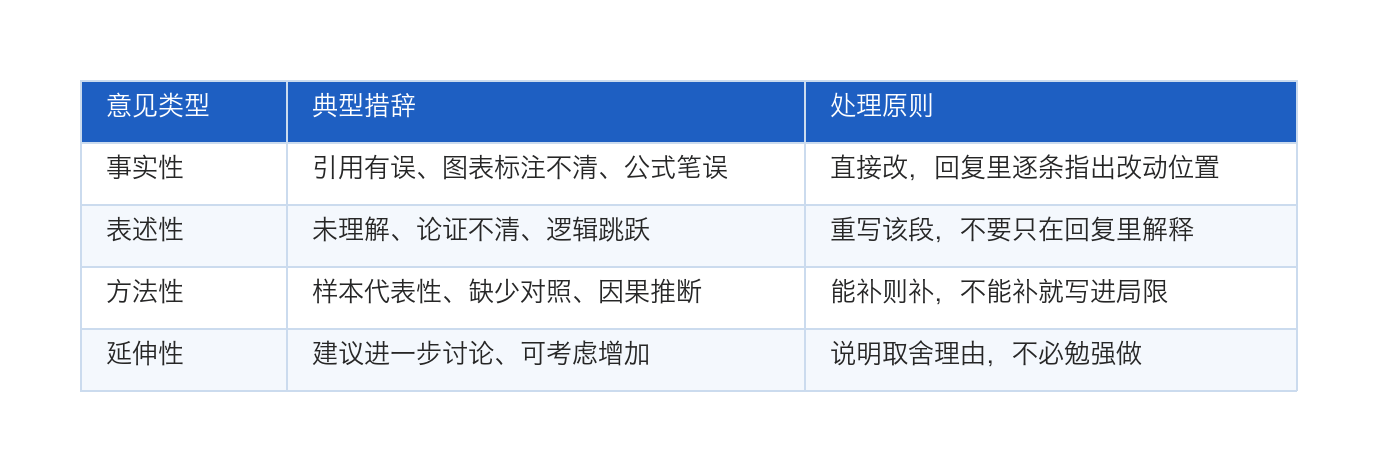
拆开看会清楚很多。审稿意见大致分四类:一类是事实性的,比如引用错了、公式写错、图标注不清,这种直接改,不需要辩论;一类是表述性的,审稿人没看懂你的逻辑,通常不是他的问题,是你没写清,得重写那一段;一类是方法性的,质疑设计或样本,这种要么补证据,要么老实承认局限;最后一类是延伸性的,"建议进一步探讨某某",属于可做可不做,做不到就说明原因。
分完类,动手顺序就出来了:先清事实性的,几个小时能扫完一批,看着进度条动起来,心态也稳一些;再处理表述性的,这类改完往往顺带解决掉一两条方法性质疑,因为审稿人误解的根源就是表述;方法性的留出整块时间单独想;延伸性的放最后统一回。
这件事里有两段是重复劳动,适合交给 AI。
第一段是分类和拆条。把审稿意见原文贴进去,让它按上面四类分好、标出每条对应正文的哪一节、哪几条其实在说同一件事——审稿人经常在不同段落重复同一个关切,合并之后八条可能只剩五个真问题。
第二段是回复函的骨架。学术回复函有相对固定的写法:先谢,再复述审稿人的关切以确认没理解错,然后说明改了什么、改在哪一页哪一段,如果没改要说明为什么。这套结构让 AI 搭,比自己从空白文档开始快得多。
需要说清的是分工。AI 搭骨架、做分类、查一致性——比如你在回复里说"已在第三节补充",它可以核对第三节是不是真的改了,这种交叉检查人做起来最容易出漏。但每一条的实质判断只能自己来:这条质疑是否成立、要不要让步、让到什么程度,这是学术判断,不是文字工作。网梯科技在做科研辅助类工具时,一直把这条线划在这里,工具负责流程和一致性,作者负责判断。
还有个细节值得一提:回复函的用词分寸。审稿人明显误读时,既不能显得对抗,也不能含糊过去装作他说得对。比较稳的写法是先承认表述不够清楚,再说明原意,然后给出改动。这种措辞可以让 AI 出几个版本挑,比自己反复琢磨省心。
改完之后,还得让人看见你改了这一步常被低估。稿子确实改了,回复函也写了,但审稿人第二轮看完还是不满意——因为他找不到改动在哪。
审稿人手上通常只有新旧两个版本和你的回复函。如果回复里只写"已按意见修改",他就得自己去两份稿子里对,对不出来就只能再提一遍。多来一轮,周期就多两个月。
稳妥的做法是让回复函和修订稿严格对应:每一条回复后面标明改在第几页第几段,把改后的句子直接引在回复里,让他不用翻原文就能看到;如果期刊接受标注修订版,一并提交一份带修订痕迹的。有几条意见你选择不改,也要在对应位置写清理由,不要默默跳过——沉默会被当成没看见。
这套对应关系的核对是典型的机械活,容易漏,适合交给工具去查:回复里声称改了的位置,实际是否有改动;引用的句子和正文是否一字一致;有没有哪条意见从头到尾没被回应过。网梯科技做论文流程数字化时处理的就是这类问题,把过程留痕和逐条对应变成系统里的固定环节,而不是靠人最后通读一遍全凭记性。
这套流程会在会上带着做一遍中国学位与研究生教育学会与网梯科技定于 10 月 22 日至 25 日在北京联合举办"AI for Science 探究会",论文写作那一个模块里,审稿意见的结构化应对与回复框架是单独一节。同一模块还包括目标期刊范式分析、引言与综述的人机分工、结果与讨论哪部分必须自己写、摘要与标题的逐轮迭代。
安排是现场实操,参会者用自己手上的稿子和意见当素材,按理工、农医、人文社科分组,各组配对应学科的助教。网梯科技在高校教学与科研信息化领域做了二十多年,也承担过高校论文全流程在线管理的建设,这次讲的是方法怎么落到具体步骤上。
审稿意见回得好不好,很多时候不在学术水平,在有没有一套顺手的流程。这东西能练,也能提前学。