2026年,国产算力领域最火的一个词是超节点。这个技术化的名词正在悄悄改变算力世界的底层逻辑。随着云计算的分布式计算时代过去,AI时代的到来,单颗GPU已经无法满足AI算力需求,将多颗GPU所在的服务器“融合”成一台超级计算机,这正是超节点正在做的事情。
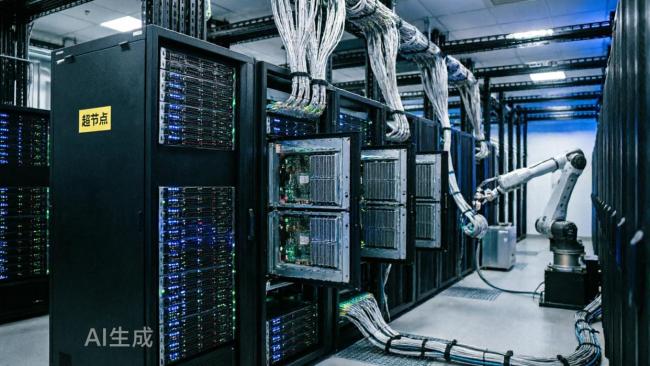
用户对AI算力公司的提问从“你能给我多少卡?”转变为“你每秒能稳定产出多少有效Token?成本是多少?”这背后的原因是大模型从训练为主转向推理为主。过去两年,大模型的参数规模迅速增长,从千亿级到万亿级,MoE架构成为主流。每生成一个Token,模型内部就要触发几十甚至上百次跨卡通信,这种通信量级传统服务器集群难以承受。
业内专家表示,大模型正在进入规模化生产阶段,问题不再是单卡峰值和卡数,而是系统能否稳定承载模型、持续产出有效Token,同时控制时延与总成本。中科曙光高级副总裁李斌也指出,行业衡量算力的标准变了,现在更看重一套系统能持续输出多少有效算力。
这一变化受到两个需求的影响。首先是模型侧的倒逼,MoE混合专家架构驱动大模型参数规模持续膨胀,推理过程对互连带宽和时延提出了近乎苛刻的要求。其次是应用侧的放大,Agent的兴起让一次用户请求可能触发多轮模型调用、工具调用和并发任务,智能体推理需要生成比传统模型多近百倍的数据词元。
供给侧的条件也在成熟,高速互连、液冷、分布式存储和系统管理软件的进步,使得更多计算资源装进一个更紧密的系统成为可能。超节点从概念走向共识,本质上把高速互连域从传统的8卡扩展到几十卡甚至上百卡,使卡间通信变成内存访问级别的低延迟。
以英伟达的NVL72为例,海外研究机构SemiAnalysis的开源推理基准InferenceX做过一组同芯片对照实验:GB200 NVL72与HGX B200使用同一代Blackwell GPU,唯一差异是系统架构。在DeepSeek R1推理中,NVL72凭借72卡NVLink全互连的规模优势,单卡吞吐最高达到B200的4.4倍,峰值达每卡4130 Token/秒,而B200只有941 Token/秒。原因在于,B200服务器只支持8卡NVLink互连,一旦专家并行度超过8,通信就要跨出NVLink域、走上带宽低得多的以太网。
超节点要突破传统服务器集群面临的瓶颈,即通信墙、功耗与散热墙、存储墙、复杂度墙。这些考验的是计算、互连、供电、散热、存储、软件的系统级整合能力。中科曙光采用超节点内部高速互连、浸没式相变液冷等技术,大幅降低PUE,并优化存储系统。联想则通过海神液冷品牌降低冷却环节能耗,整机柜液冷产品一个机柜承重超过3吨,耗电达到数百千瓦。
目前,各家厂商在多大规模才合适的问题上给出了不同答案。某行业专家认为,互连域存在收益收敛的边界,NVIDIA在GH200阶段的研究验证过,互连域规模超过一定程度后,训练性能的边际提升趋于平缓。因此,NVIDIA在GB200、Vera Rubin时代都在控制单一互连域规模,转而专注提升单系统效率。
联想选择单节点40张GPU的规模,理由是真正意义上的一级高速全互联域,既能在节点内获得较高通信效率,又避免超大规模互连在可靠性、运维上的挑战。曙光则选择“大小通吃”,既有十万卡AI超集群曙光8000,也有40卡的scaleX40“箱式超节点”。
尽管路线各异,但共识逐渐浮现:规模是手段而非目的,真正需要优化的是一定规模约束下的系统效率。业内专家批评部分厂商刻意把互连域规模包装成超节点能力的代名词,强调客户应关注真实负载中的Token成本。
超节点要真正规模化落地,工程化挑战不可回避。供应链、标准化和生态墙、可靠性是主要挑战。AI的爆发带动了上下游整体进步,但也抬高了关键物料的压力。此外,国产AI芯片的供给约束也直接影响超节点放量的节奏。
破局路径自然是开放。浪潮信息围绕OAM架构推出多款开放加速系统,完成多种主流加速芯片的兼容适配。曙光通过“AI计算开放架构”推动分层解耦。联想在通用超节点方面坚持开放路线,定制化超节点则与头部客户深度协同。
未来,超节点的形态可能会继续分层,内部追求高带宽低时延,之间通过开放的Scale-out网络扩展。细分场景的差异化架构会成为演进方向,预训练、后训练、推理的需求结构差异很大。供电、光互联、浸没式液冷等前沿技术也在储备中。竞争的终局不在硬件参数表上,而在谁能构建开放、协同、可持续演进的生态。