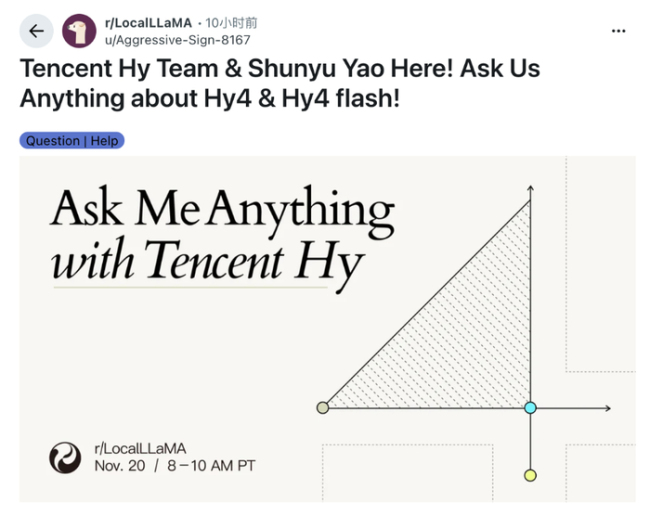
11月21日凌晨,腾讯首席AI科学家、混元大模型负责人姚顺雨及其团队在Reddit进行了长达120分钟的AMA活动,回答了全球开发者关于混元大模型的各种问题。这是混元团队首次在开发者社区公开问答,讨论了如何在有限算力下提升模型能力,以及开源生态、架构选择、评测体系等问题。
不到一个月前,混元接连发布了两款新模型。11月4日发布的Hy4在第三方评测机构Artificial Analysis的智能指数榜单上位列中国模型第二,在Agent Arena榜单上居开源模型首位。随后发布的Hy4 flash定位为“日常工作的极致性价比模型”,并在11月20日开源。根据腾讯的数据,在自建日常工作任务评测WorkIndex中,Hy4 flash的单任务成本仅为Hy4的1/20。在涉及85名内部用户、259项工作任务的盲测中,其单任务成本约为0.26元。
在11月18日腾讯三季度业绩电话会上,腾讯总裁刘炽平表示,新一代混元Hy4已达到中国基础模型的顶尖能力水平,并在实际生产力应用中展现出较强实用性。公司对Hy4的能力及提升速度感到满意,近期已将多模态研发统一至混元团队,大幅扩大了Hy4的预训练和后训练规模,并加入了视觉及计算机操作能力。面对字节跳动等公司在推进更大参数模型的情况,混元团队表示,小尺寸模型成本更低且能积累更多经验。
对于下一代Hy4.5模型参数规模是否会扩至1.5万亿—2万亿参数的问题,混元团队确认下一代Hy模型的规模肯定会进一步显著扩大。此外,Hy4仍有很多提升空间,特别是在后训练方面。团队正在大力投入大规模强化学习(RL),持续改善用户体验和模型安全性,并计划训练更大的模型。针对小尺寸模型,Hy4-mini已经在开发路线图中,未来还将推出更多小型模型。对于24B—31B规模的稠密模型,团队也在考虑;但对于更小规模的稠密模型,目前可能不会专门开发100B参数以下、针对编程任务优化的模型。
在数据集质量方面,腾讯混元团队强调高质量训练数据的重要性,指出不同领域和任务的标准各不相同,设计和清洗数据需要大量精力。验证数据质量最好的办法是做实验,最终看实证结果。关于模型架构,团队认为过于稀疏的MoE架构对推理不太友好,占用大量GPU显存却没有充分利用算力。在总参数量相同的情况下,可以提高激活参数量,保持相同的推理吞吐量。激活参数量本质上决定了计算预算,提高稀疏度虽然能挽回一部分效率损失,但无法完全弥补,削减激活参数意味着更少的计算量,导致模型能力变弱。
在评测体系方面,团队建议不要迷信单一榜单,要参考各种不同的评测,包括内部基准测试、公开评测、第三方评测,以及真实用户反馈。对于大模型写作越来越像套话的现象,团队表示这可能与模型的训练目标有关,创意写作和可读性非常重要,已在改进,但仍需努力。腾讯混元团队将继续走开源路线。
自今年2月重建混元的预训练与强化学习基础设施以来,混元迭代路线清晰可见。4月开源Hy3 preview,7月发布Hy3正式版,8月开源Hy4 preview,11月发布Hy4正式版并扩展预训练与后训练规模,引入视觉理解与电脑操作能力。一周后,主打性价比的Hy4 flash跟进。自重建以来,混元保持平均每两个月迭代一次大版本的节奏。
在三季度业绩电话会上,管理层对混元的迭代给予正面反馈。马化腾提到,混元Hy4已达中国顶尖大模型水平,Hy4 flash显著降低推理成本。云服务收入增速因WorkBuddy增长和公司向模型即服务(MaaS)和GPU租赁分配更多算力而提升。刘炽平表示,公司大幅扩大了Hy4的预训练和后训练规模,并加入视觉及计算机操作能力。相较此前模型,Hy4在指令遵循、长上下文理解、长程任务和深度研究等方面均实现显著提升。
高投入的同时,资本开支也大幅增加。三季度腾讯单季资本开支创纪录达到814亿元,同比增长527%;前三季度累计1661.53亿元,同比增长179%。管理层预计,随着2026年、2027年建成的基础设施在后续年份发挥作用,到2028年经营压力有望逐步缓解。在算力约束问题上,腾讯高管坦言,最新收紧的限制对中国所有参与者都会产生影响,短期内下一代模型的推出可能需要更长时间,但国内供应链将逐步补上。推理方面,当前构建的模型效率较高,国内供应链应能满足相关需求。在算力约束与成本压力之下,下一代Hy模型的迭代仍受到市场关注。腾讯混元团队表示,正在尽可能充分地利用现有资源,以追赶前沿水平。