原文刊载于《中国科学院院刊》2026年第2期"学科发展”
周杨理理1,2 汪卫华1 赵紫威1,2*
1 中国科学院东莞材料科学与技术研究所
2 松山湖材料实验室
人工智能驱动的材料科学(artificial intelligence-driven materials science,AIMS)带来了材料研发范式革命,有望从根本上突破材料传统研发周期与效率瓶颈。从历史看,材料科学研究范式从经验试错、理论建模、计算模拟演进至数据驱动的新阶段,是由认知工具和方法革新带来的。当下,人工智能(AI)作为颠覆性的认知工具,更是从根本上重构了材料科学核心要素及其互动逻辑:科研过程实现智能迭代与全流程闭环;科研人员能力重塑与团队有组织化;科研对象深度广度拓展与需求精准锁定,从而形成了材料研发新模式和新范式,这正是新质生产力在材料科学领域孕育发展的体现。然而,当前我国在AIMS领域仍面临多尺度建模、多模态数据融合、模型泛化等瓶颈,需通过夯实数据底座、攻关核心技术、完善生态保障等路径突破。文章综述了材料科学研究范式的演进历程与现状,构建了AI驱动材料科学要素变革的理论框架,分析了AIMS面临的困难瓶颈,提出了推进我国AIMS发展的战略路径和策略,以期为加速AIMS范式体系形成、培育材料新质生产力提供理论与实践参考。
材料科学作为支撑现代工业体系的基石,其核心价值在于将基础科学原理转化为解决实际工程问题的物质载体。然而,长期以来,材料研发依赖经验试错与理论推演,呈现出显著的偶发性特征,这种“炒菜式”研发模式周期漫长且成本不可控,导致材料科学的前沿研究成果难以转化为满足市场需求的切实解决方案,核心应用价值无法充分体现。而人工智能(AI)凭借其在高维特征表征、海量多模态数据处理与智能优化决策等方面的独特优势,有望从根本上破解材料科学发展面临的难题。基于此,发展人工智能驱动的材料科学(artificial intelligence-driven materials science,AIMS),已成为材料科学创新发展的关键。
一、材料科学研究范式的演进历程与现状
1.1 经验试错阶段
这一阶段的材料研发主要依赖经验积累和反复试错,本质上是通过大量实验寻找偶然出现的性能突破,试错过程缺乏理论指导,实验数据难以系统化积累,导致新材料发现具有极大的偶发性,研发周期以10年甚至100年为单位。如钢铁冶炼,铸铁工艺改进靠经验调炉温、配料比例,从铁器时代到现代钢铁时代跨越数千年。
1.2 理论建模阶段
随着经典物理学和化学的发展,材料科学研究进入理论指导阶段。19世纪,固体物理学的建立为材料性能预测提供了理论基础;20世纪,海森堡提出量子力学矩阵形式,泡利提出不相容原理,为理解材料电子结构奠定了理论框架;鲍林将量子力学应用于分子结构研究,推动了材料理论建模的发展。理论建模使材料研发从经验试错转向定向设计,但受限于理论简化假设和计算能力,难以处理复杂多组元材料体系。
1.3 计算模拟阶段
计算机技术的发展催生了计算材料科学。20世纪70年代密度泛函理论(DFT)的实用化,20世纪80年代分子动力学模拟方法的成熟,Materials Project数据库的建立,推动了计算材料学的普及。计算模拟使材料研发转向“计算—实验”结合模式,但其仍面临“维度灾难”挑战。
1.4 数据密集型阶段
伴随着大数据和AI技术的发展和突破,对材料创新及其高效研制的迫切需求推动材料科学进入数据驱动的新阶段,其核心逻辑是通过整合多源数据与智能算法,实现材料“成分—结构—工艺—性能”关联规律的高效挖掘。
① 数据标准化积累与基础工具搭建阶段。2011年,美国启动“材料基因组计划”成为这一时期重要标志。该阶段的核心突破在于确立“数据标准化采集—结构化存储—开放共享”的基础逻辑,为AI技术介入筑牢数据基座。
② 机器学习深度介入与预测模型落地阶段。随着数据规模扩大与算法精度提升,AI技术从辅助工具升级为性能预测的核心手段。2016年Nature封面文章,证实了机器学习可通过挖掘历史失败数据中的隐性规律,降低新材料筛选的试错成本。
③ 全流程闭环与自动研制阶段。AI与自动实验系统的深度融合,推动研发模式从预测辅助迈向自主决策,形成“数据生成—模型优化—实验反馈”的闭环,是数据驱动材料研发的又一里程碑。国际上,美国DeepMind公司开发的GNoME模型发现38万余个热力学稳定晶体材料。美国劳伦斯伯克利国家实验室开发的自主实验系统(A-Lab),实现无机粉末材料无人值守合成与表征。国内方面,清华大学DeepH算法、复旦大学HamGNN算法通过深度学习预测材料哈密顿量,加速电子结构分析。中国科学技术大学系统构建了集理论计算、机器学习、自动化实验与云端基础设施于一体的智能化学实验室系统,引入大语言模型驱动的多智能体协作架构完成从自然语言指令解析到跨设备任务调度的全流程自主操作。中国科学院东莞材料科学与技术研究所携手松山湖材料实验室,建成了具备自主知识产权的材料科学数据库、描述原子间相互作用的通用AI模型、机器人自动化实验室、Matchat材料科学垂类智能体等信息化工具体系,实现材料研发过程中“设计—筛选—合成—表征”全流程闭环。这一阶段的突破在于多尺度建模与实验自动化的深度耦合,AI从性能预测工具进化为自主研发主体,材料科学向精准设计与高效迭代的新纪元迈出了重要一步。
1.5 中美发展现状对比
当前,中美两国在技术体系构建、数据资源整合、研发范式革新等方面形成差异化竞争优势。
美国在政策层面:启动“创世纪计划”(Genesis Mission),旨在通过项目驱动和集中突破等方式整合国家科研资源,利用AI加速抢占在先进制造业、生物技术、关键材料等核心领域的科技制高点。技术层面:1. 第一性原理计算、分子动力学及宏观有限元模拟等软件成熟完善,集成化程度高,能实现不同尺度计算的有效衔接;2. 拥有以Materials Project、OQMD、AFLOW等为代表的、规模庞大且标准统一的通用材料数据库;3. 高通量计算基础设施成熟,实现材料计算从单点作业向协同化、集成化转变。
1.6 中国聚焦自主数据库建设,在特色模型研发等领域持续发力。
① 构建全国性架构体系,推动多源异构数据融合。如苏州国家实验室、北京科技大学与中国钢研科技集团共建国家新材料大数据中心,构建 “1+N” 架构,整合超 30 个数据节点,解决材料数据碎片化问题。
② 重点研发特色材料大模型与专用预测工具,聚焦细分领域打造技术优势,强化材料性能预测、制备工艺优化等能力,形成自主特色技术路径。
③ 推动高通量计算与实验平台协同,搭建智能化实验设施,建立材料研发全流程数据采集、筛选与验证协同机制,提升研发效能。
二、知识生产视域下AI驱动材料科学要素变革的理论框架
知识生产是对知识的创造、组织、验证与应用(图1)。材料科学研究围绕“成分—工艺—结构—性能”内在关联,将对物质世界的理解转化为新材料,实现“科学发现—技术突破—产业应用”的知识生产过程。AIMS驱动材料知识生产范式革新,智能化工具链使知识生产从经验驱动转向数据驱动的动态循环,实现高效创造与迭代;科研人员能力结构向“人机协同”重塑,跨学科团队有组织协作成为常态,拓宽知识创造广度与深度;研究对象拓展到跨尺度耦合系统和全生命周期,精准对接实际需求,提升知识应用价值与转化效率。
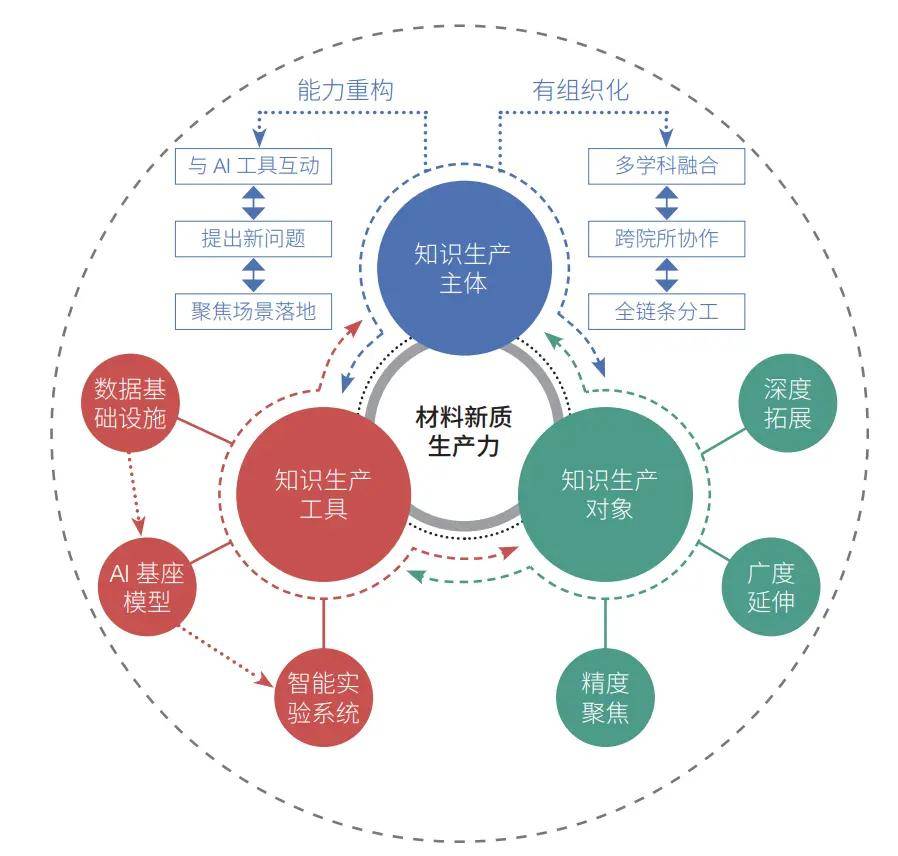
图1 人工智能驱动材料科学要素变革的理论框架
2.1 智能化工具链变革知识生产逻辑
科研工具的智能化升级是知识生产范式转型的物质基础。AIMS凭借“数据—模型—实验”闭环迭代的智能化工具链,重构材料知识生产的核心逻辑,实现知识从生成、验证到优化的全链条革新。
材料数据基础设施是知识生产的“核心底座”。整合高通量计算、自动化实验、文献知识数据与经典书籍语料,建立跨尺度映射规则与质量校验机制破解“数据孤岛”问题,形成标准化、动态更新的材料知识原料库。该底座既为 AI 模型提供初始训练数据,又接收实验反馈新数据以丰富数据维度,实现知识生产原料的动态供给。
材料AI基座模型是知识生产的“智能中枢”。融合科学机理与深度学习技术,构建具有跨时空尺度预测能力的通用模型体系。围绕“数据学习—规律挖掘—决策输出—反馈优化”全链条,从高维数据中提取材料“成分—工艺—结构—性能”关联规律。该模型为实验系统提供精准指令,通过误差反馈优化参数,确保知识输出与实际需求动态适配,解决传统材料创制和知识生产中理论实践脱节问题。
智能实验系统是知识生产的“验证与反哺终端”。打造多智能体协同自动化平台,集成机器人制备、智能表征与性能测试模块,将模型决策转化为实物实验,验证新知识。实验结果一则验证模型预测有效性,二则将新数据反哺至数据基础设施,注入新变量,形成“数据喂养模型—模型指导实验—实验丰富数据”知识生产闭环,推动研发链条迭代加速。
2.2 科研人员能力重构与组织模式优化提升知识生产效能
AIMS范式下知识生产主体从人类独立主导向人机协同共创演变,通过重构科研人员能力体系与优化科研团队的科研组织模式,实现人类创造性思维与机器高效算力的深度融合。
知识生产主体能力的范式迁移是核心支撑。AIMS范式下,材料AI模型与智能实验系统替代成分筛选、样品制备等重复性工作,要求科研人员掌握人机协作技能。科研人员可从烦琐实验中解放,将核心价值转向提出关键问题、设计研究框架等,聚焦高价值知识生产环节,形成人机协同格局。
科研团队的有组织化是知识生产效率的保障。面对材料知识生产向复杂化、极端化、深层次拓展的发展趋势,个别科研团队“单打独斗”难催生重大突破,尤其难解决AIMS在组织层面的复杂工程性问题。因此,需组建跨领域、跨学科、跨研究方向的科研队伍,采用分工明确且协作紧密的科研组织模式,既保障个体科研团队专业化效率,又以知识互补与资源共享激活创新动能。
目前,国内外积极探索与AIMS适配的科研组织模式革新。如中国科学技术大学精准智能化学全国重点实验室探索工程化管理提升科研效能,构建精细化管理体系,分解科研目标,明确责任人等,实现全流程可视化管控。同时,强化跨领域团队接口化管理,推动各环节通过标准化平台对接,确保“理论推导—实验验证—数据反馈”高效运转,以有组织科研破解传统研究碎片化问题。
2.2 研究对象拓展丰富知识生产维度
科研对象的边界决定了知识生产的范围与价值。AIMS范式下的科研对象从孤立样本向系统关联、从实验室静态向全生命周期动态拓展,实现知识生产深度、广度和精度的跃升,将极大提升新材料等科技成果的应用转化和产业化效率。
知识生产深度向多维度耦合系统突破。传统材料研究难触及多因素非线性耦合本质规律,AIMS通过高维参数空间建模,将原子尺度的键能、电子态密度,介观尺度的晶粒分布、缺陷演化,宏观尺度的工艺参数、服役环境等多维度变量纳入研究,构建跨尺度构效关系网络。这一转变让科研对象从“孤立的材料样本”升级为“动态关联的系统参数集合”,为揭示材料性能本质规律提供新视角,解决传统知识生产中局部认知局限问题。
知识生产广度向全生命周期场景延伸。传统研究以实验室标准样品为对象,侧重短时间、单一工况测试,难以覆盖材料全生命周期演化。AIMS整合自动化实验、工业生产、服役监测多源数据,构建材料数字孪生体,将研究对象拓展至真实应用场景的动态性能变化。这一拓展使科研对象从静态实验室样本转变为动态全生命周期性能演化过程,提升知识生产与实际应用需求贴合度,便于研究成果放大、量产和应用。
知识生产精准度向战略需求导向聚焦。AIMS通过挖掘国家战略领域需求痛点,将科研对象精准锁定于关键材料体系。这种“需求牵引—智能设计—应用验证”的知识生产链条显著提升科研资源配置效率,实现知识生产价值与国家战略需求的深度绑定。
三、AIMS面临的困难瓶颈
3.1 多尺度知识建模存在割裂
(1)跨尺度物理机制耦合困难
材料性能由原子/电子层面的微观结构、介观组织特征到宏观服役行为的多尺度演化共同决定,但现有算法难以精准刻画不同空间和时间尺度间的动态关联。
(2)跨尺度数据对齐与融合不足
不同尺度研究的时间步长、空间分辨率差异巨大,数据难以直接关联。
3.2 多模态数据融合机制缺失
(1)数据格式与标准不统一
材料研发涉及的文献文本数据、实验测试数据、计算模拟数据、微观图像数据等多模态数据缺乏统一存储格式与表达规范,兼容性较差。
(2)跨尺度数据关联断裂
从电子结构计算数据到器件性能测试数据的跨数量级数据缺乏统一表征框架,难以建立有效关联。
(3)数据质量与完整性不足
主要包括多模态数据存在噪声高、标注不一致等问题,且关键场景数据缺失。
3.3 模型泛化能力受限
(1)在新型材料体系中预测精度较低
面对未充分覆盖的新材料体系,模型因训练数据中缺乏同类样本,易出现过拟合或预测偏差。
(2)在复杂工况下预测可靠性不足
针对极端服役环境,因缺乏足够的工况数据训练,模型难以准确捕捉材料性能演化规律。
(3)跨材料体系迁移时性能衰减
AI模型在已知材料体系中表现稳定,但迁移至特性差异较大的新体系时,预测能力则下降。
3.4 模型可解释性与可信度不足
“黑箱”特性导致模型预测逻辑难以追溯,制约AIMS在关键领域的应用渗透。
(1)物理约束嵌入不足
部分模型因缺乏对物理规律的显式嵌入,易导致预测结果违背基本科学原理。
(2)决策路径不可追溯
现有模型因无法充分揭示“成分—工艺—结构—性能”的内在因果关系,导致难以为实验优化提供可操作的机理指导。
(3)评估标准缺失
当前对模型可解释性尚缺乏统一完善的量化评估指标,缺乏对物理一致性、机理吻合度、结果可重复性等核心维度的明确量化标准。
四、推进我国AIMS发展的建议
4.1 围绕标准化、规模化与安全共享,夯实数据底座
(1)构建全生命周期数据治理标准体系
制定覆盖采集、存储、标注、验证全流程的国家级数据标准,统一多模态数据格式和跨尺度映射规则,完善质量评估与伦理审查规范,确保数据可用、可信、可复用。
(2)打造规模化数据供给与协同平台
整合高校、科研院所及大科学装置的高通量同源数据,构建全尺度标准化数据集,强化极端工况下稀缺数据采集能力,确保数据同源性与可复现性,支撑材料AI模型泛化能力提升。
(3)建立安全可控的数据流通与价值释放机制
搭建国家材料可信数据空间,参与国际材料数据标准制定,推动我国材料数据平台与国际主流数据库互通,提升全球材料数据治理话语权,构建开放共享的数据生态。
(4)强化重点领域数据专项布局
针对战略领域的关键材料,启动系统性数据采集专项,构建细分领域专用数据集,支撑材料专用AI模型的训练与迭代,加速从基础研究到产业应用的数据价值转化。
4.2 聚焦跨尺度建模与智能算法突破,攻关核心技术
(1)突破跨尺度融合建模技术
将物理机理作为先验约束嵌入算法,开发融合第一性原理、分子动力学与宏观力学的混合建模框架,精准刻画“原子/电子—介观组织—宏观性能”动态关联,进而破解跨尺度映射难题。
(2)发展多模态数据融合技术
制定覆盖实验数据、计算数据、文献文本、微观图像的统一表征标准,开发跨模态特征对齐算法,建立多源数据关联规则,解决诸如非晶合金热力学参数与宏观性能数据等融合障碍。
(3)创新小样本与迁移学习算法
针对新体系数据稀缺问题,构建基于已知材料体系的预训练模型,通过参数微调实现诸如对高熵非晶、二维磁性材料等新材料体系的快速适配;开发主动学习策略,优先选择信息量大的样本开展实验,提升模型在复杂工况下的泛化能力。
(4)发展数据驱动的数字孪生技术
建立材料全生命周期虚拟模型,通过实时数据交互实现虚拟与实体实验的双向优化,模拟极端工况下的性能演化规律,支撑从微观结构设计到宏观服役性能预测的全链条加速。
4.3 以学科建设、共识凝聚与评价体系建立为抓手,完善生态保障
(1)优化交叉学科布局,夯实人才支撑
加快建设“AI+材料”学科体系,系统培养懂材料机理且掌握AI工具的复合型人才。整合材料、计算机、自动化等学科资源,建设材料AI课程体系。
(2)构建科学共同体,提升协同效能
以形成AIMS统一研发范式为核心,搭建跨领域、多层次学术协作网络。设立联合攻关项目,推动科研单位、高校、企业在AI驱动材料研发方法论和技术路径上形成共识,消除技术壁垒与认知差异。
(3)建立科学规范的材料智能体评价体系,保障AIMS安全可控发展
构建覆盖模型全生命周期的国家标准,明确数据格式、测试方法与评估指标,形成标准化评估链条。建立多维指标框架,配套基准测试套件实现系统化评估。整合多方评估资源,引入企业参与场景设计,建立结果共享反馈机制,参与国际标准制定与互认,提升全球评估话语权。
作者简介
周杨理理 中国科学院东莞材料科学与技术研究所智库办公室助理工程师,广东省前沿新材料产业集群专家。主要研究领域:科技创新范式。
赵紫威 中国科学院东莞材料科学与技术研究所智库办公室负责人,广东省前沿新材料产业集群战略咨询项目负责人。主要研究领域:产业集群治理、科技创新政策、空间统计。
文章来源
周杨理理, 汪卫华, 赵紫威. 人工智能驱动的材料科学:演进、框架、困境与破局. 中国科学院院刊, 2026, 41(2): 405-417.
DOI: 10.3724/j.issn.1000-3045.20250827001.
本刊发表的所有文章,除另有说明外,文责自负,不代表本刊观点。