iPhone 18 Pro 发布之后,绝大多数报道的第一句话都是「2nm」。这没错,A20 Pro 是苹果第一款用在 iPhone 上的 2nm 芯片,值得写。但看完这场发布会,我想聊的是另一件事:苹果把内存从 SoC 的正上方搬到了旁边。
苹果在台上的说法很克制:
"A20 Pro introduces custom packaging, inspired by our M-series chips, with a silicon die now placed side-by-side with memory. This removes the memory from the thermal path of the SoC and lets us connect the silicon directly to the vapor chamber for dramatically improved thermal performance."
翻成中文就三句:A20 Pro 用了一种受 M 系列启发的定制封装,硅裸片与内存并排放置;内存因此不再挡在 SoC 的热通路上;芯片可以直连均热板。
这几句的分量在于,它结束了一条 iPhone 走了十年的封装路线。而在这十年里,苹果从没在发布会上把「封装」当成卖点讲过。
一、先把官方说了什么、没说什么钉死
这个题目的信息环境很脏。发布会同期流出的所谓「技术细节」,有一大半是三年前就在传的旧料,加上一层新包装。所以先划边界。
官方明确确认的只有五件事:
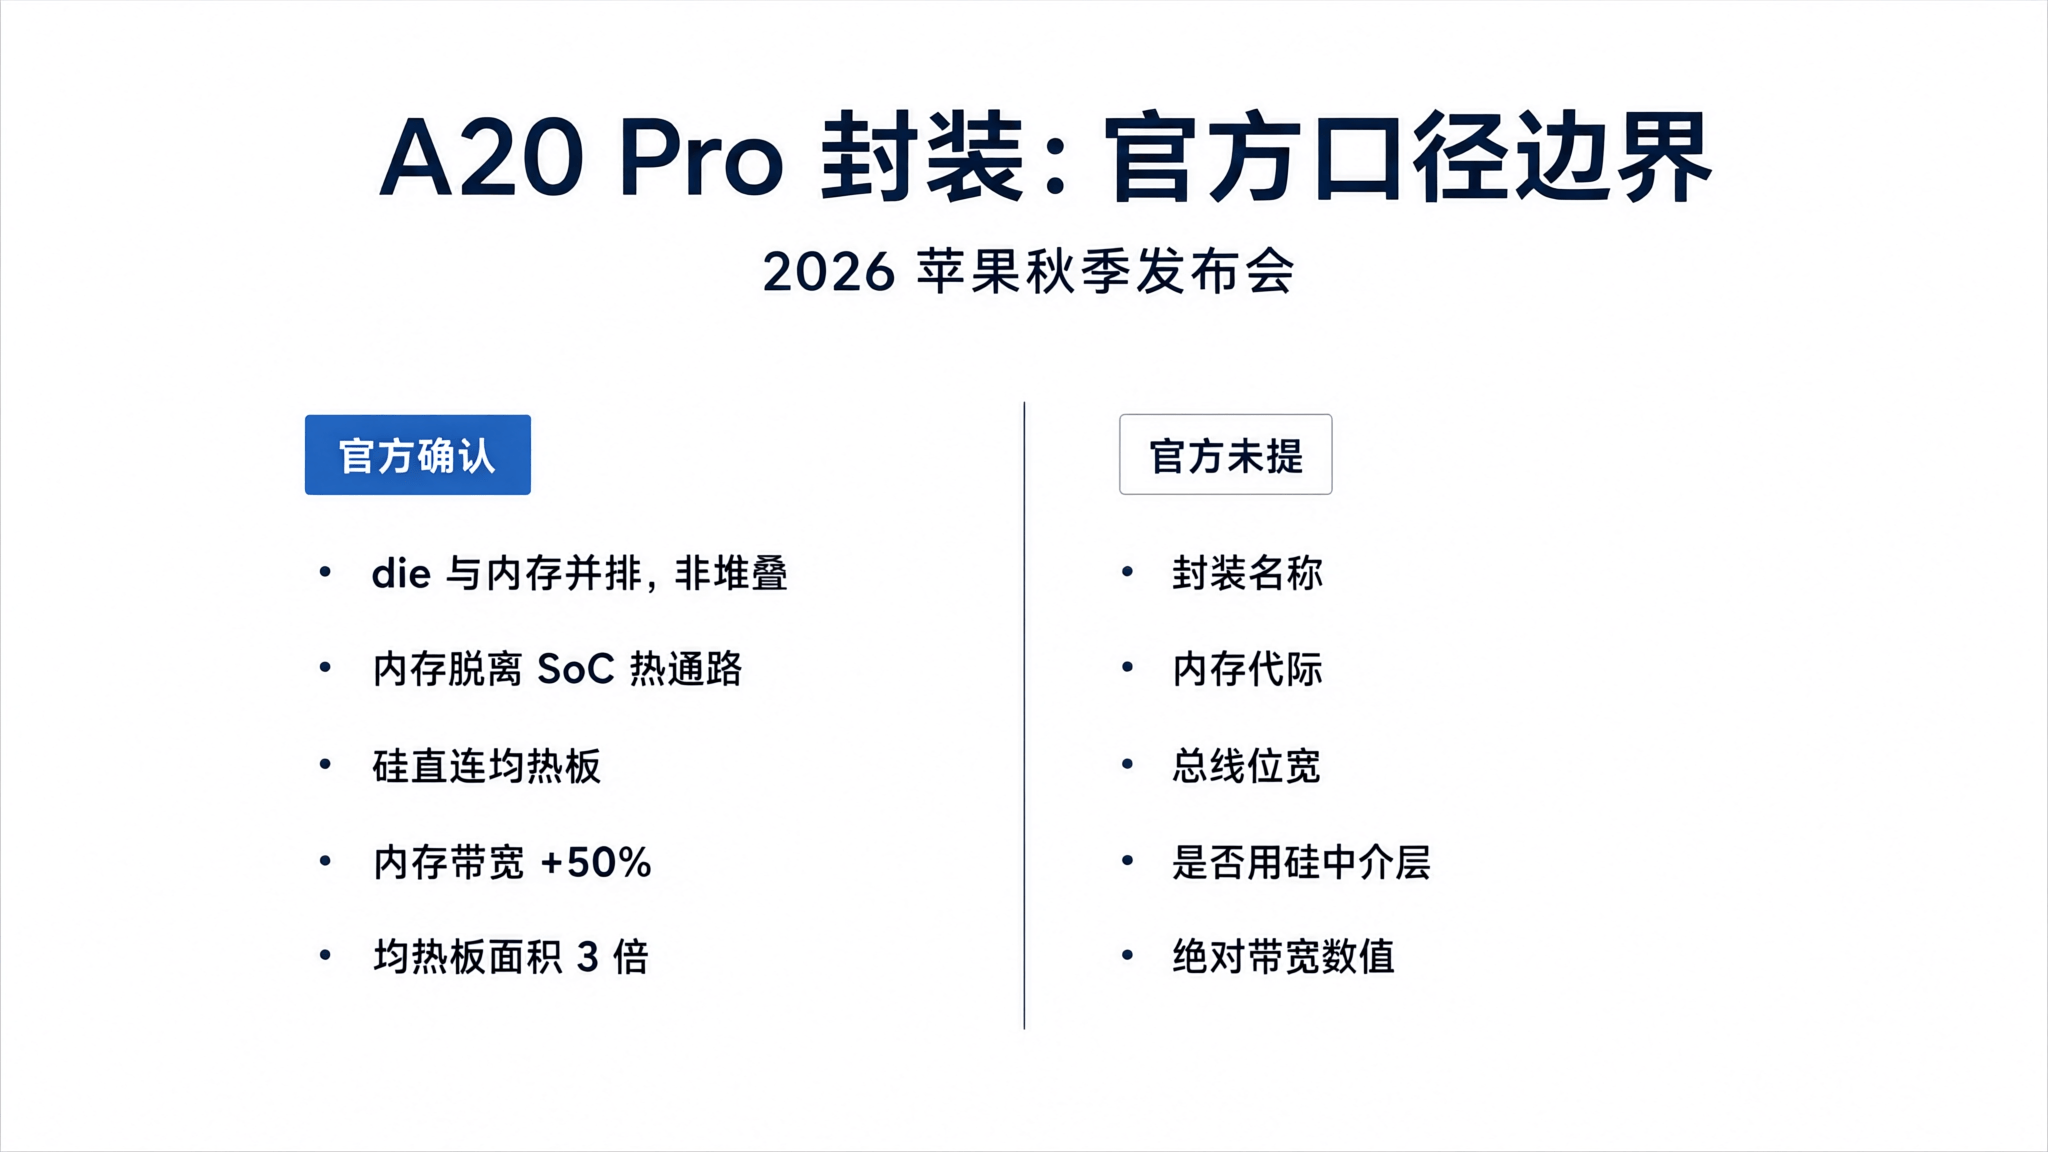
官方一个字没提的是:这套封装叫什么名字、内存是 LPDDR5X 还是 LPDDR6、总线位宽多少、有没有用硅中介层、绝对带宽是多少 GB/s。
媒体现在普遍管它叫 WMCM(Wafer-Level Multi-Chip Module,晶圆级多芯片模组),并顺带给出了 96-bit、6 通道、12GB LPDDR5X、产线在台积电嘉义 AP7 厂这一整套参数。这套说法内部还打架:说 LPDDR5X 的和说 LPDDR6 的同时存在,供应商份额也有 37%/33%/30% 和 60-70% 两个版本。
我的处理办法是:把「并排」当事实,把「WMCM」及其工艺细节当行业解读。后面凡是引用到它们,都会标出来。
二、PoP 撑了十年,为什么这次撑不住了
从 2016 年的 iPhone 7(A10)开始,苹果用的是台积电的 InFO-PoP:内存封装直接叠在 SoC 封装正上方,靠一圈焊球或铜柱做垂直互连。A11 换成了第二代 InFO,用铜柱取代通模孔,之后 A12 到 A19 Pro 一直是这套骨架。
它当年是正解,而且正解得不像话。内存离 SoC 只有 0.3 到 0.5 毫米,走线短、寄生小,高频 LPDDR 跑起来又稳又省电;SoC 和内存可以分开采购、分开测试、自由搭配容量组合;两层各自测好了再叠,坏了换一层就行。对一台要卖几千万台、每一分钱都要算的手机来说,这些优点没有替代品。
代价藏在三个地方,而且十年里一直在恶化。
第一个是散热。SoC 和内存是整机最烫的两颗东西,PoP 把它们垂直摞在一起,等于把两个热源压成一个热点。更要命的是,SoC 裸片散热最好的那个面,被内存封装盖住了。热量要出去,得穿过塑封料、界面焊球、内存基板、内存裸片,一层层往外挪。三星在自己的技术博客里把这件事讲得很直白:手机越做越薄,封装越做越薄,裸片越磨越薄,散热扩散的通道也就越来越窄。
第二个是带宽。die 和 DRAM 之间能走多少根线,取决于顶部那圈界面焊球的颗数和间距,业界大概是 100 到 600 颗、0.35 到 0.5 毫米。这个物理上限把手机内存总线钉在了 64-bit 上。苹果从 2012 年的 A6 起就没动过这个数,十多年里只能靠提高单引脚速率来补,而单引脚速率的边际收益一年比一年小。
第三个是厚度。想加容量就得往上多叠内存层,可机身厚度不允许。
单独看,这三点都只是「能用但有瑕疵」。问题在于端侧大模型成了手机的常态负载。一台要连续跑十几分钟推理、还要维持帧率的设备,热和带宽就从瑕疵变成了天花板。到了这一步,封装不改不行了。
三、并排之后,两笔收益是怎么来的
把内存从 SoC 上方平移到旁边,结构上只是换了个位置,收益却是两条线。
先说散热。堆叠方案里,SoC 的热流路径是这样的:
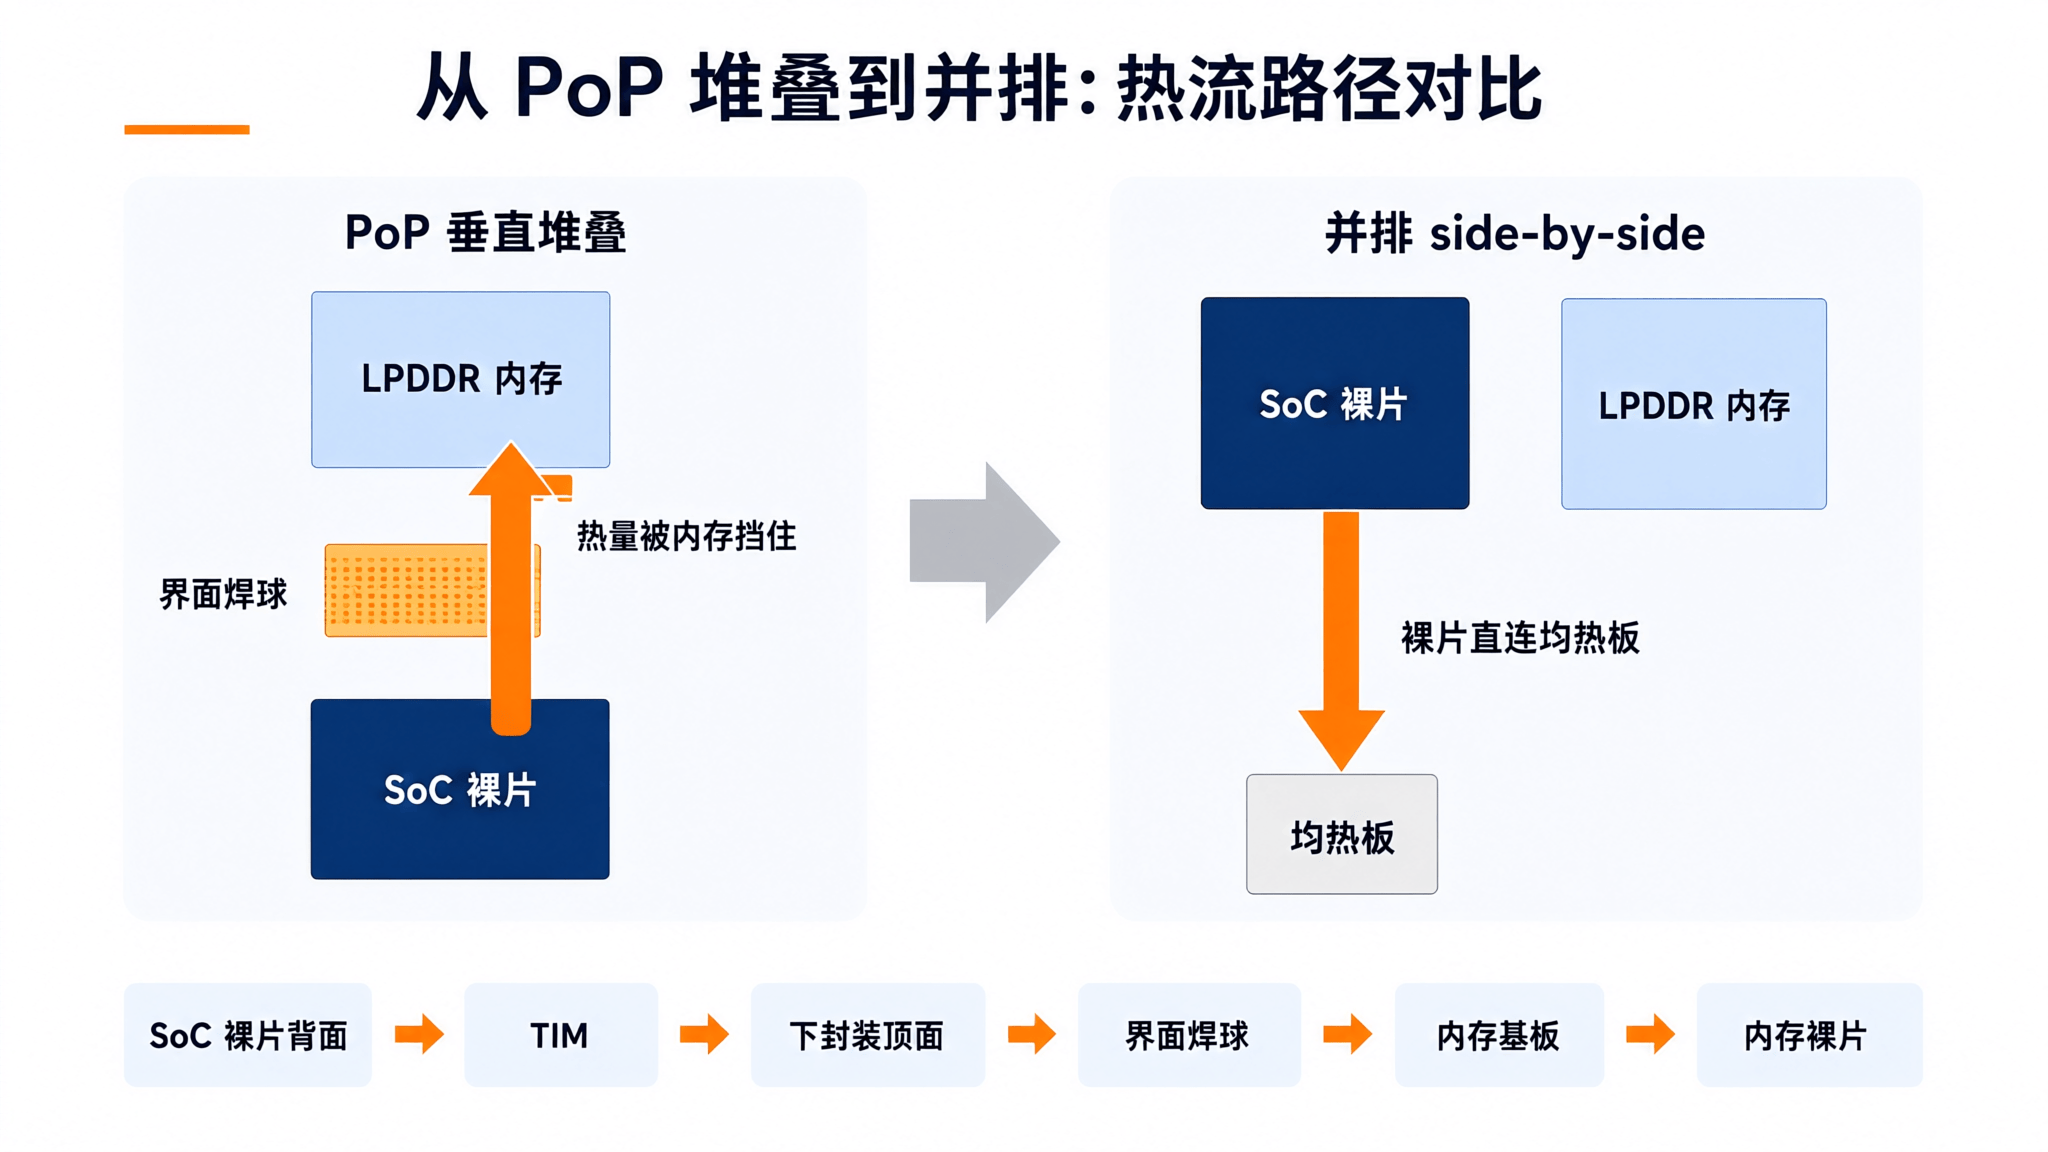
并排之后,裸片背面正上方没有东西了,热量可以经一层薄 TIM 直接送到均热板。热阻的层数少了,传热距离短了,而且内存不再被动地泡在 SoC 的热场里,自身温度降下来,也就不会反过来烤 SoC。
这就是「硅直接连接均热板」的物理含义。它是封装侧改动和整机侧散热设计合起来才成立的一件事:并排让出位置,均热板才有机会贴上去;均热板面积做到 17 Pro 的三倍,再把这个收益放大一遍。苹果说持续性能比 17 Pro 最高提升 40%,比 16 Pro 及更早的机型最高翻倍,这套数字要成立,靠的主要是这条链,不是制程。
带宽的增长则是连带的。这个逻辑苹果自己在台上讲得很清楚,先把「史上最宽内存接口」说成所有性能提升的前提,再说「为了释放这些能力,我们必须重新设计物理封装」。因果关系它自己认了。
原理不复杂:并排之后,die 和 DRAM 之间的线走的是精细 RDL,不再受顶部焊球数量和间距的限制,同样的封装面积里能布更多、更密的走线;走线更短,寄生电容电感更小,高频下的信号完整性更好;内存面积也不再受限于底下那块 SoC 有多大,封装层面能塞进更多颗粒和通道。
一句话概括这条路线的价值:PoP 用垂直堆叠换了空间和供应链弹性,代价是散热通道被占、接口被焊球锁死。并排把这些代价还了回去。
四、+50% 的算术,和算术之外的部分
内存带宽的公式是「总线位宽 × 数据率」。苹果只给了 +50% 这个结果,没给算式。
拿 A19 Pro 的量级做基准:64-bit、8533 MT/s,约 68.3 GB/s。在这个基准上试几种组合:
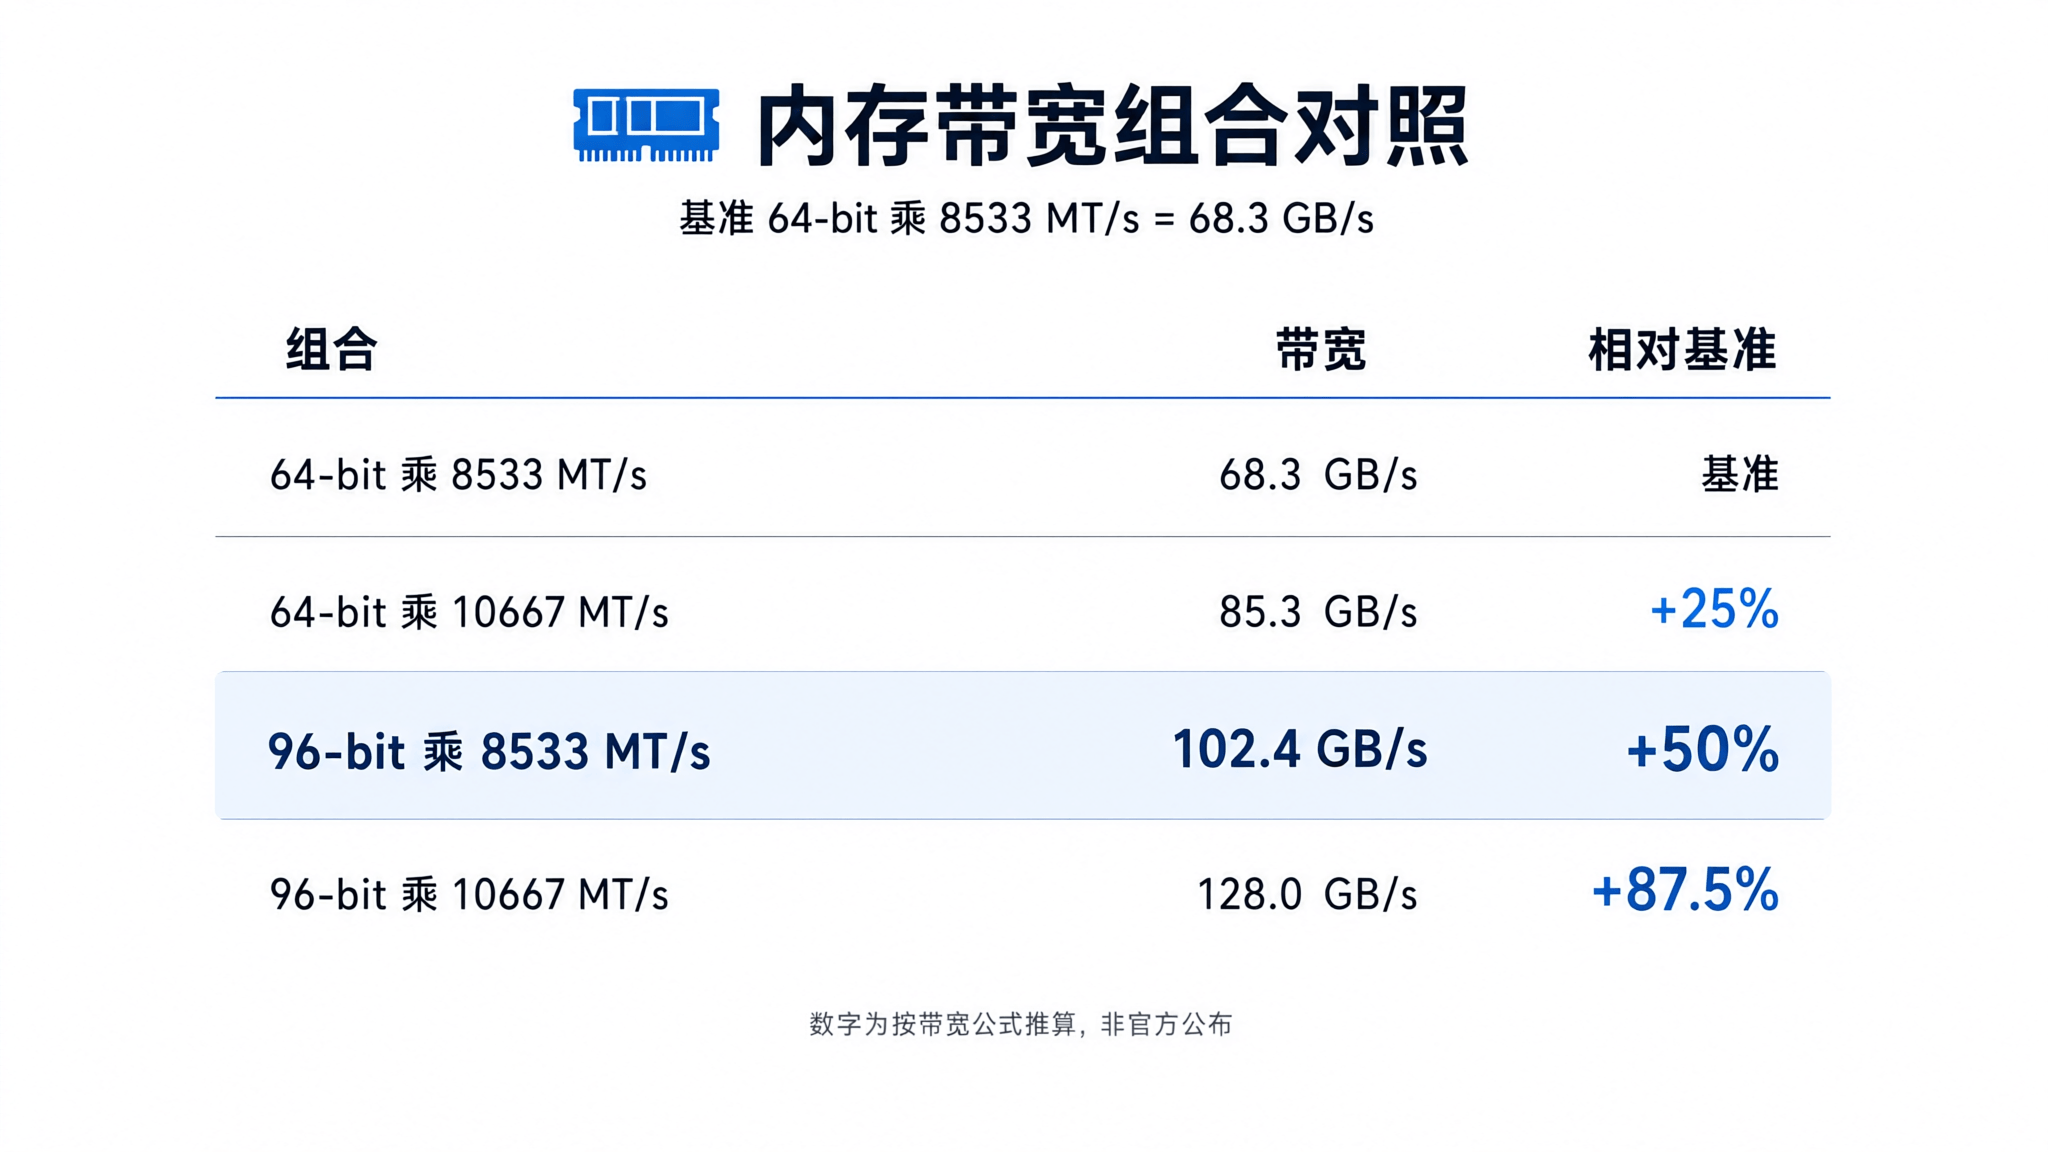
这张图能说明几件事。
只想靠提速率拿 +50% 是做不到的。64-bit 下要翻到 +50%,单引脚得跑到 12800 MT/s 左右,而 LPDDR5X 的 JEDEC 上限是 10667,再往上属于 LPDDR6 的地盘。反过来,位宽从 64 加到 96、速率原地不动,出来的正好是 +50%。这解释了 96-bit 这个说法为什么会传得最广:它是唯一能干净对上官方数字的常见组合。
但「96-bit 且 10667」会算出 +87.5%,和官方口径对不上。两件事不可能同时为真。
有一点必须说清楚:上面的推算全部建立在「基准是 64-bit @ 8533」这个假设上。苹果没公布基准机型。如果基准是 A19 Pro 的 9600 MT/s 档,那 +50% 对应的就是 96-bit @ 9600,结论照样是 96-bit,但速率对不上 8533 那套传闻。基准一变,细节全变。
所以严格的说法应该是:如果 A20 Pro 真的换了 LPDDR5X-10667 而位宽没变,那就不可能是 +50%。至于它到底是 96-bit 还是换了 LPDDR6,在苹果公布规格页或者有拆解之前,谁都不知道。
五、端侧 AI 卡在带宽上,不在算力上
这一节可能是整场发布会最被低估的部分。
自回归解码的吞吐量,大致等于内存带宽除以模型权重字节数。每生成一个 token,都得把全部权重重读一遍。手机在这个公式里受带宽约束,远远早于受算力约束。
粗略算一下:标准 LPDDR5X 约 76.8 GB/s,一个 FP16 的 7B 模型权重约 14GB,理论吞吐只有 6 token/s 上下;换成 Q4 量化(约 3.5GB)能到 22 token/s 左右。而算力这一侧的上限远高于此。换句话说,端侧体验的决定变量是带宽,NPU 的 TOPS 数字排不上第一。
按 +50% 估算,Q4 量化 7B 的理论解码上限大概会从 22 抬到 30 token/s 出头。这个量级的变化,直接决定本地模型「跟不跟得上嘴」。
长上下文是另一个吞噬带宽的场景。KV Cache 的读写随上下文长度线性增长,所以带宽 +50% 对长文档摘要、跨邮件跨信息的个人情境对话这类场景的收益,可能比对单轮短问答更明显。
行业对这件事的共识度比想象中高。三星在 Hot Chips 2026 上展示的 LPDDR5X-PIM,把算力直接放进内存颗粒,跑 Llama-3.1-8B 从 27 token/s 提到 81.3 token/s,差不多三倍。那是「加宽总线」之外的另一条路。苹果选择把总线拓宽,三星同时押注 PIM,两家在解同一道题。
双神经引擎共 32 核是另一把钥匙,但它解决的不是同一个问题。带宽负责喂得快,双 NPU 负责算得动。多模态、图像生成、实时视觉这类要同时跑多路模型的场景,吃的是并行算力密度。两个改动叠在一起,加上并排封装带来的持续性能,才凑成完整的那句话。
六、苹果不是第一个做的,但可能是决定它变成默认的那一个
这一点值得摆正位置。
三星 Exynos 2600 已经量产了 HPB(Heat Path Block)方案,把 DRAM 移出热区,在 AP 上方放一块铜制导热块,热阻降了约 16%。下一代 Exynos 2700 传闻要直接转向 SbS(Side-by-Side),也就是和苹果同一路线的并排。高通的 Snapdragon 8 Elite Gen 6 Pro 也被泄露采用类似横向布局加 HPB。联发科天玑这边暂时没有公开的同类信息。
所以「去 PoP 化」是三条线同时在走的方向,苹果是其中一条。苹果真正的贡献是体量:它把这套方案推到了 iPhone Pro、Pro Max、Duo 加起来数千万级的出货上。三星的 HPB 目前还只能算实验,苹果这一脚踩下去,并排封装才可能从「某家的试验」变成「高端移动 SoC 的默认选项」。
迁移的节奏不取决于技术,取决于两件事。一是高通、联发科能不能拿到台积电这一级的封装产能和材料;二是这块成本能不能被旗舰溢价消化掉。三星有自有晶圆厂和自有内存,垂直整合最顺,阻力最小。高通和联发科要协调 SoC 厂、内存厂、封装厂三方,慢一拍是正常的。
产业链上的收益分配也在变。晶圆级整合把更多工序前移到了晶圆厂,台积电在这个长期由 fan-out 和 PoP 主导的手机 AP 封装领域,拿到一个新的高附加值节点。代价是它和英伟达在先进封装产能上要多抢一份。至于日月光、安靠这些 OSAT,位置变了,但未必是变好或变坏:核心整合做不了,价值会往测试、切割后组装和返修上转。
七、真正的风险在账本上,不在实验室
技术方向是清楚的,难的是经济性。
晶圆级平面集成把 die 和 DRAM 绑在同一道工序里,对位精度、已知良好裸片(KGD)、封装测试、模塑底部填充材料的要求都上了一个台阶。有报道说对位误差要控制在纳米级,偏差会导致电路断路甚至整片报废。这类工序的早期良率从来不好看,传闻说是 70% 出头,我认为这个量级可信,但具体数字没有官方来源。
成本侧的数字更乱。有说 A20 Pro 单颗成本比上代高 60% 以上的,有说整机 BOM 涨约 300 美元的,有说内存成本占整机物料从 10% 涨到 20% 以上的。这些口径互相打架,单位也未必统一,只能当方向看,不能当数用。有一条我建议直接忽略:有来源给出「WMCM 单颗封装成本 3000 至 4000 美元」,这个数字和一颗手机 SoC 的售价完全不在一个数量级上,口径一定有问题。
真正的大头在内存这一侧。AI 数据中心抢走了大量 DRAM 和 HBM 产能,LPDDR 跟着涨,这才是 iPhone 18 Pro 定价承压的主因。封装只是叠加项。
围绕供应的两种说法值得摆在一起看。独立记者 Tim Culpan 称约 10 亿美元的 A20 Pro 晶圆因为 LPDDR 没到货,卡在台积电完不成封装,机制是晶圆级整合没法「先存芯片、后补内存」。郭明錤否认存在大规模积压,说苹果会提前约三个月按内存供给排产。我的判断是取交集:高端 LPDDR 供应紧张、交付节奏偏紧,这个可信;10 亿美元积压的具体规模存疑,不该当既定事实引用。
最后一层证据是价格。苹果最终定价 1,199 和 1,299 美元起,低于发布会前市场一度预期的 1,399 美元。这说明它自己吸收了一部分成本,也可能通过高配大容量版本去分摊。不管怎么算,存储涨价才是压在定价表上的那只手。
八、五个还没有答案的问题
- 内存代际和位宽到底是 LPDDR5X 还是 LPDDR6,是 96-bit 还是别的?官方规格页出来之前,都算传闻。
- 「+50%」的基准机型是哪一台?是 A19 Pro 还是更早?绝对带宽多少 GB/s?
- WMCM 这个命名和「无中介层、用 MUF」的结构描述,会不会被官方或者拆解证实?
- 实际量产良率是多少,单颗封装的成本增量是多少,什么时候有人敢公布?
- 高通和联发科会不会跟进,时间表怎么排?
要检验这件事,不需要等到下一代 iPhone。明年初 TechInsights 或 iFixit 的拆解会给出裸片排布和 DRAM 型号,那是第一个硬证据。台积电接下来几个季度的财报会,则能从 N2 产能、先进封装产能和存货天数里读出另一面。在这两样东西出现之前,苹果讲的这套封装叙事,逻辑上是自洽的,工程上也是合理的,但它仍然只是一个叙事。