论文标题: Learning to Forget: Satiation-Aware Long-Sequence Transducers for Mitigating Post-Purchase Redundancy
论文链接:https://zhuanlan.zhihu.com/p/2082882092019597491
论文作者: Yipin Dai、Ruocong Tang、Xing Fang、Yang Huang、Jing Wang、Zhentao Song、He Guo(Alibaba Group)
一台程序自己设计出来的电路,2005 年拿到了美国专利,编号 6,847,851[1]。发明人那一栏规规矩矩写着三个人类的名字,可真正画出这块电路的,是一套跑在 1000 颗 CPU 上、照着生物进化的样子运转的算法。那三个人做的事,只是把算法进化出来的成品整理干净,递交给了专利局。
前面第 7 篇聊到,德国人在风洞里让算法进化喷管的形状,进化的是一串参数,一组数字。可要是把进化的对象直接换成程序本身呢?一段能跑的代码,能不能像生物那样自己繁殖、自己变异、被一轮轮淘汰,最后长出连专家都想不到的东西?有个人为这件事较真了大半辈子,他给出的答案很干脆:能,而且能拿专利。
这个人叫 John Koza。在他成为这套思路的奠基者之前,他的正经身份,是个搞彩票的。
一个搞彩票的人,后来教机器自己发明
1973 年,Koza 和一位做零售推广的合伙人 Daniel Bower 一起开了家公司,叫 Scientific Games[2]。他们捣鼓出来的产品,你大概率刮过:擦一擦就知道中没中奖的即开型彩票。第一款叫 The Instant Game,1974 年在马萨诸塞州上市,头奖一万美元,上市第一周就卖了 270 万美元。刮刮乐这东西,Koza 是共同发明人,这点得说清楚,合伙人 Bower 同样在发明人之列,不是他一个人的功劳。
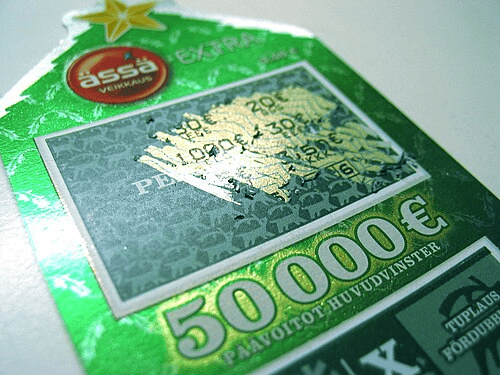
早期擦除式刮刮乐彩票,对应 Koza 1974 年的 The Instant Game
按理说,把刮刮乐生意做大、公司卖给别人,这辈子也算交代得过去了。NPR 的 Planet Money[3] 还专门请他聊过这段往事。倒是 Koza 自己不甘心只当个彩票商人。他更早的来头其实不小:1972 年就在密歇根大学拿了计算机科学博士,导师是 John Holland[4]。这名字前面第 4 篇出现过,遗传算法之父[5]。师承在这儿摆着。
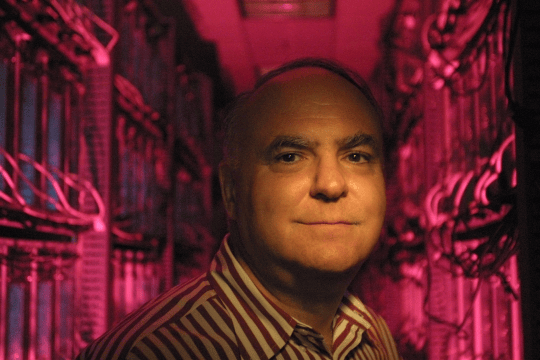
遗传编程奠基者 John Koza
刮刮乐生意脱手之后,Koza 去了斯坦福。这里得拦一个常见的误会:他在斯坦福的身份是顾问教授(consulting professor),不是拿终身教职的正教授[6]。说白了,他更像一个带着自己课题、自己掏钱搞研究的客座专家。从 1988 年起,他在斯坦福断断续续开遗传算法和遗传编程的课,一直开到 2003 年。
他较真的那个问题,顺着 Holland 来:Holland 让一串二进制数字进化,Koza 想得更狠,他要让程序进化。一段代码,自己改自己,改着改着越来越好用。这个念头不算他第一个想到的。早在 1980 年,Stephen Smith 的博士论文就试过用会变长的结构来进化;1985 年,Nichael Cramer 写下了第一篇纯粹的遗传编程论文[7]。Koza 真正的贡献,是把这把火烧成了一个学科:他给它起名 Genetic Programming[8],1992 年出了 那本奠基的大书[9],后来又 一口气写到第四部[10],把这套东西从一个玩具做成了能上专利局的工具。
Koza 1992 年的奠基著作 Genetic Programming
所以麻烦记住一个时间感:遗传编程不是 1992 年凭空蹦出来的,它的火种 1980、1985 年就有了,Koza 是那个把它系统化、命名、并且第一个玩出花样的人。下一个问题来了,让程序进化,听着挺玄,它到底怎么个进化法?
进化一段程序,先得让程序长成一棵树
想让代码繁殖变异,得先解决一个表示问题:一段程序,怎么写成一个能像基因那样被切开、被拼接的东西?
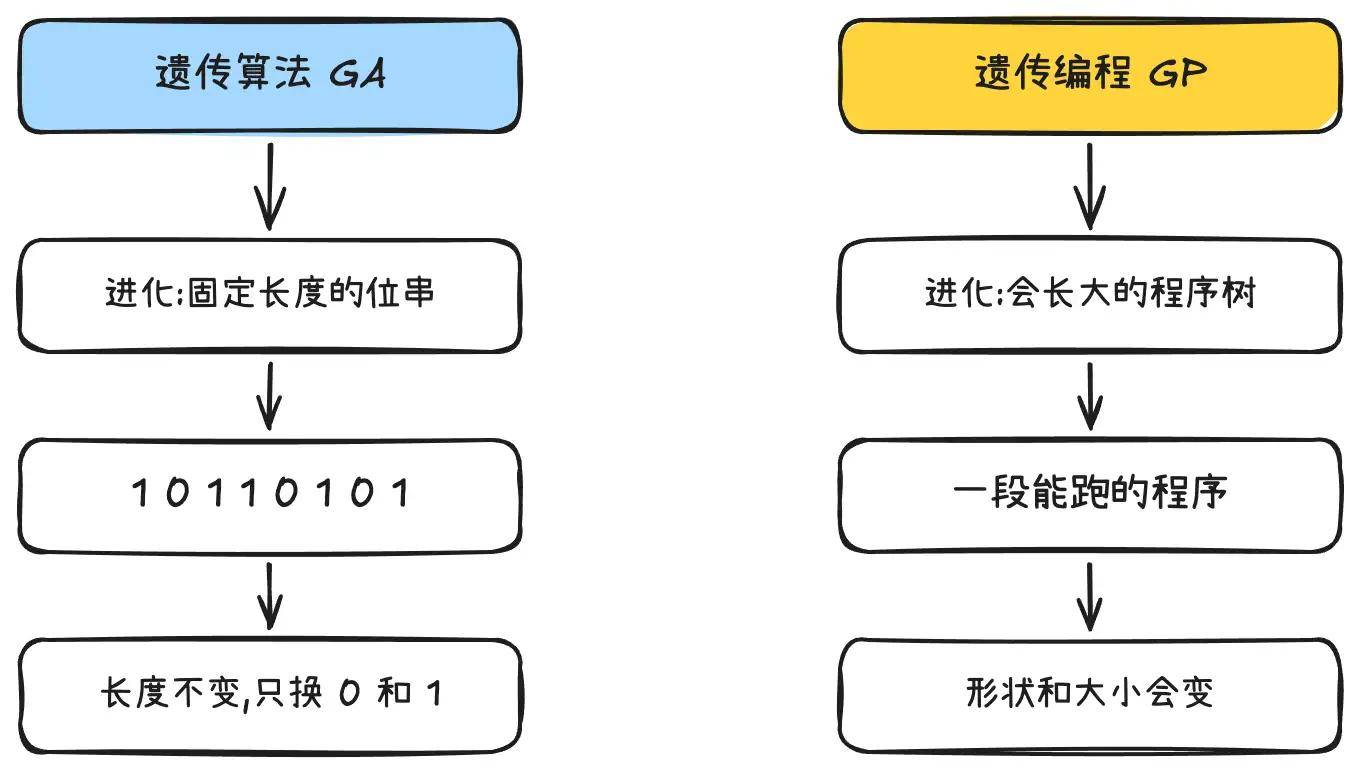
遗传算法那边好办,它进化的就是一串定长的 0 和 1,长度从头到尾不变,变的只是每一位填 0 还是填 1。遗传编程进化的对象不一样,它是一段真能跑的程序,大小和形状事先都不知道,还会在进化过程里越长越大、或者缩回去。这两者的差别,一张图就看明白:
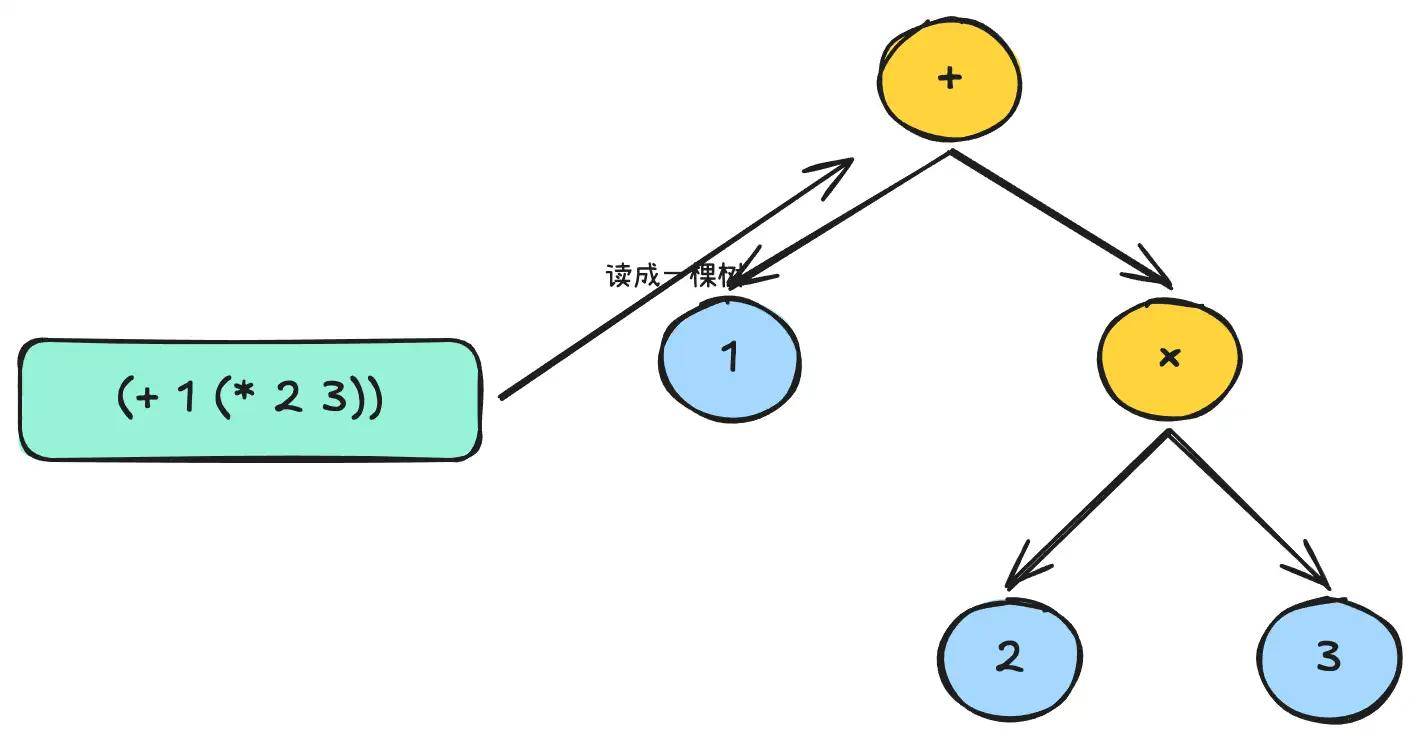
Koza 的解法,是借了一门老语言的光:LISP[11]。LISP 写表达式有个特点,什么都用括号套起来。比如 1 + 2,在 LISP 里写成 (+ 1 2),意思是把加法这个函数,作用到 1 和 2 上。这种写法叫 S 表达式。它最妙的地方在于,一段 S 表达式天生就是一棵树:函数蹲在树的内部节点,数字和变量挂在叶子上。(+ 1 (* 2 3)) 这一串,拆开就是这个样子:
你猜怎么着,程序一旦变成树,前面几篇讲的那套生物把戏就全能套上来了。一棵树就是一个个体,一片森林就是一个种群。怎么繁殖?怎么变异?树这种结构,处理起来反而比一串数字更顺手。这就是 Koza 那本书标题里那句拗口的话的意思:用自然选择的办法,给计算机编程。
那棵树要怎么生孩子,是下一节的事。先记住一点:在遗传编程的世界里,你写的每一行代码,都是一个能繁殖、能变异、随时可能被淘汰的活物。
两棵树交换树枝,就生出了第三棵
生物的交叉,是父母双方各拿出一半染色体,拼成孩子的。程序树的交叉,玩法几乎一模一样,换的是树枝。
具体怎么换?在两棵父代树上,各随机选一个点,然后把这个点以下的整棵子树,整个交换过去。听着简单,这里头藏着遗传编程最优雅的一手。看这张图:
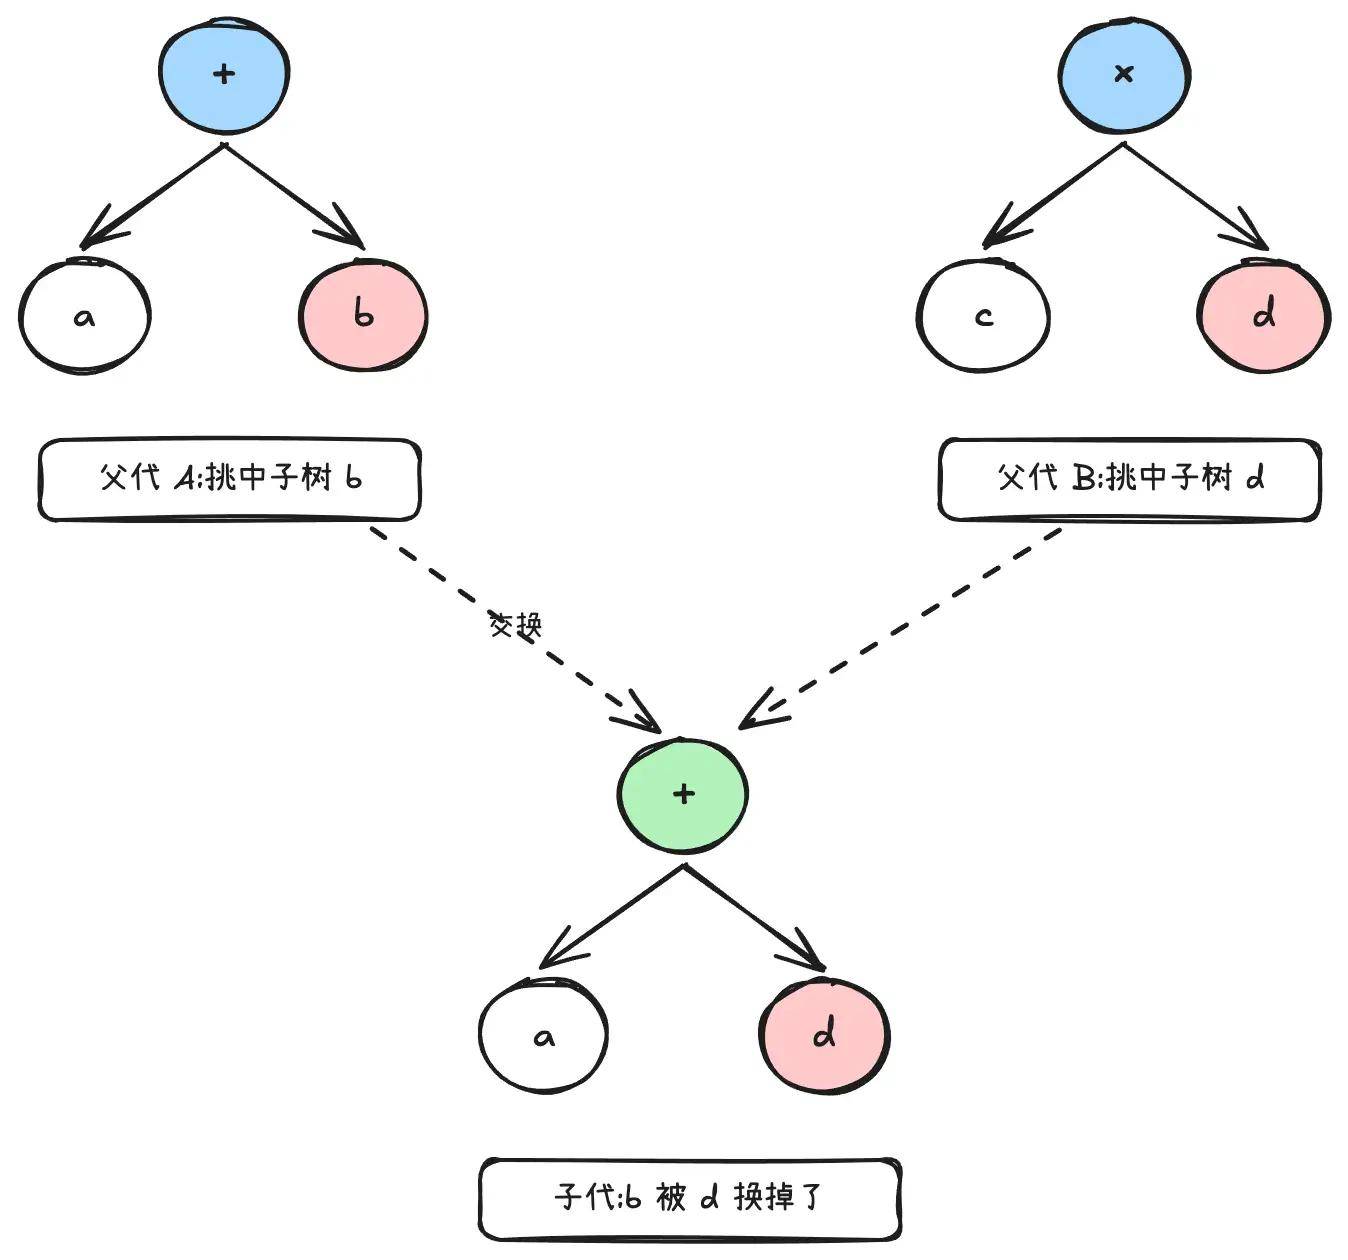
关键就在这:因为换的是一整棵子树,不管你在哪个点上下刀,换完之后得到的,永远还是一段语法上合法、能跑的程序。这是一串二进制位干不到的事。位串做单点交叉,切在半中间很容易切出一段无意义的乱码;程序树换枝,换出来的怎么都还是棵能解析的树。说白了,这套表示法自带一层保险,保证后代不会一生下来就是废的。
变异更直白,随机找棵子树,要么把里头某个函数换成另一个,要么直接长出一段新的随机子树顶上去。交叉负责把好基因重新组合,变异负责往池子里时不时扔点新花样,免得大家近亲繁殖、卡在一个平庸的解上下不来。
把这两步接进前面几篇反复讲的那个进化循环里,一代遗传编程就跑起来了:
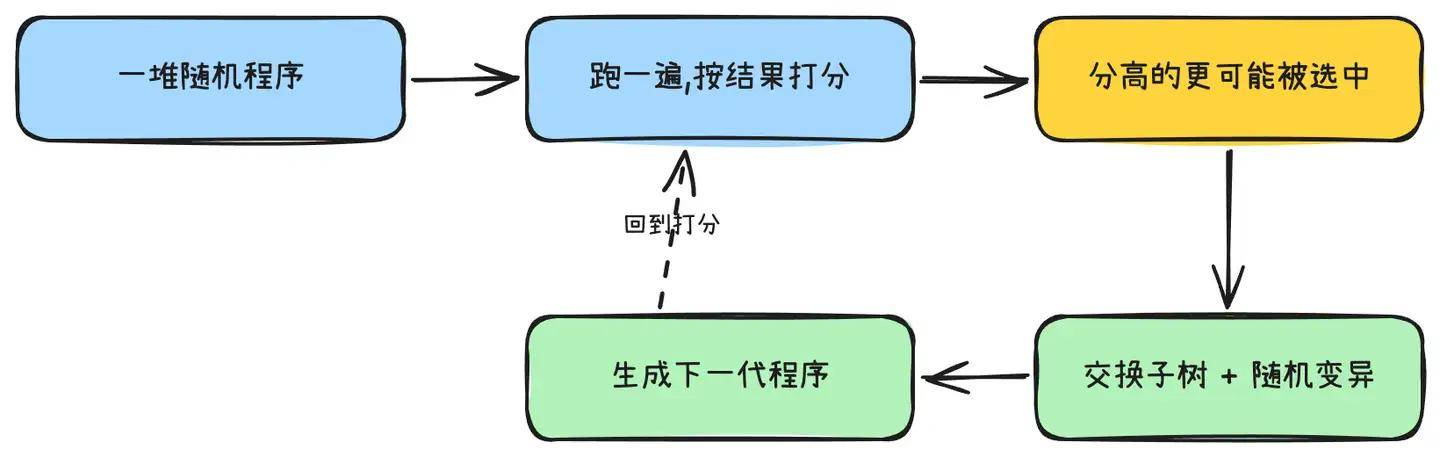
先随机生成一大堆程序,大多数都是垃圾,跑出来的结果离目标差着十万八千里。没关系,挨个跑一遍,按结果好坏打个分,这个分就是适应度。分高的,被选中当父母的概率就大;分低的,大概率绝后。选出来的父母交叉、变异,生出下一代,再打分、再选、再生。一代一代滚下去,整个种群的平均水平会慢慢往上爬。
这个过程,Koza 真不是在小打小闹。1999 年起,他的公司架了一台 1000 颗 Pentium II 处理器[12] 拼起来的并行机器,让上千个程序同时进化。机器这么猛,是有原因的:他要让它去干一件野心很大的事。这台机器进化出来的东西,后来真把专利律师都惊动了。
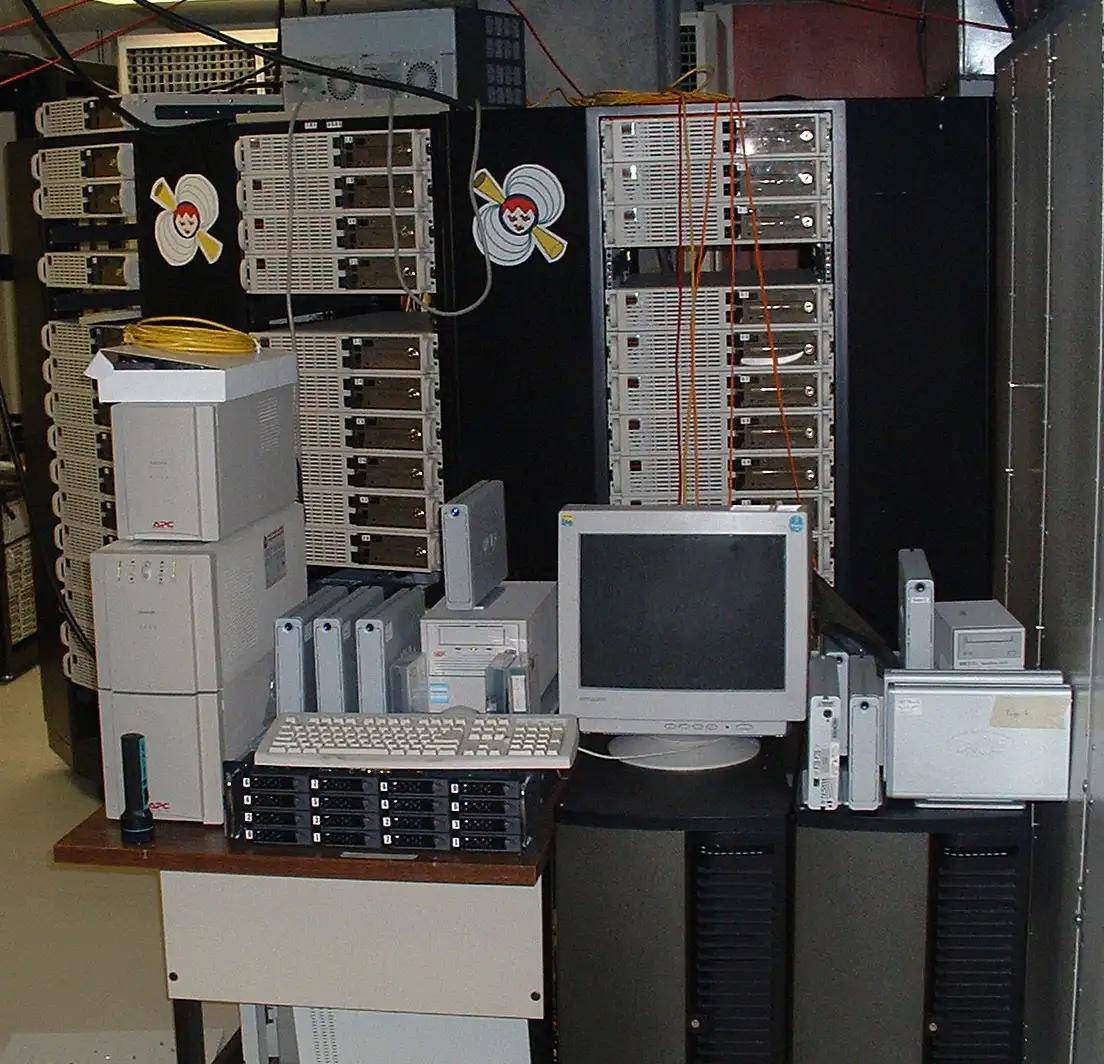
Koza 用来跑进化的 1000 节点并行机器
它重新发明了 1927 年的那个伟大原理
电子工程里有个绕不开的名字,Harold Black。1927 年 8 月的一个早上,他在去上班的渡轮上,把一个困扰了行业很久的难题想通了,发明了 负反馈放大器[13]。这玩意儿有多重要这么说吧,现代几乎所有的音响、通信、控制系统,底层都靠它稳住。Black 为此申请了专利,美国专利 2,003,282 和 2,102,670[14],被这个领域奉为经典。
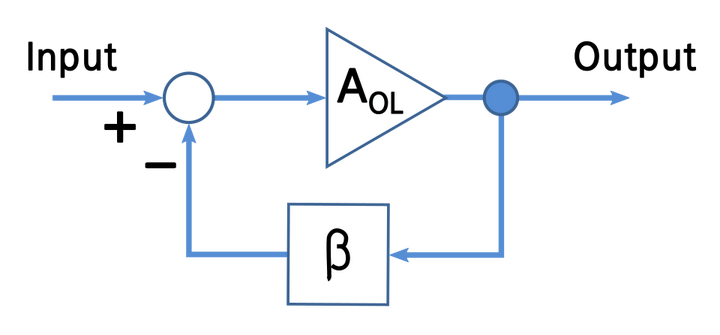
Harold Black 1927 年发明的负反馈放大器
Koza 做了个实验。他没把 Black 的电路图喂给机器,他只告诉机器一个高层目标:我要一个能把失真压下去的放大器,你自己想办法。然后让遗传编程从一堆随机电路开始,一代代进化。
进化的结果,机器自己摸索出了负反馈这个原理。它不知道 Black 是谁,不懂电磁学的来龙去脉,纯靠试错加选择,把人类工程师当年灵光一闪的东西,又独立地走了一遍。这才是真正吓人的地方。它不是照着答案抄,它是在不知道答案的前提下,重新发明了答案。
这件事在学术上有个专门的说法,叫 human-competitive,媲美人类水平。Koza 为它定了 八条判定标准[15],满足任意一条就算数,其中最硬的两条:一是这结果当年是能拿专利的,或者今天拿去申请专利也够格;二是它达到或超过了这个领域里被人类首次发现时公认的成就。负反馈这个案子,两条全占。
到底有多少这样的成果?把数字摆出来,你会发现遗传编程这台机器的产量,远超一个负反馈:

21 项专利、2 项新发明,还有一张真的专利证书
先说复制的部分。到 《遗传编程 IV》[16] 出版时,Koza 团队已经用遗传编程,复制、侵犯或者重新发明了 21 项先前已经授权的专利发明。这 21 项里,15 项是 20 世纪的老专利,6 项是 2000 年以后授权的 21 世纪新专利。换句话说,机器不光能重走前人的路,连最近的专利也照样能独立摸出来。
举个具体的。有一种叫电压电流转换的电路,2000 年由三美电机的两位工程师申请了 美国专利 6,166,529[17]。遗传编程在完全不知情的情况下,把功能等价的电路又进化了出来。还有更绝的,机器合成过一批做数学运算的模拟电路,平方、立方、平方根都有,其中那个 求立方根的电路[18],Koza 翻遍已发表的文献,根本找不到对应的人类设计。机器是凭空造的。
复制专利已经够唬人了,但遗传编程没停在这。它还产出了 2 项全新的、够格申请专利的发明,两个都是控制器,性能超过了 20 世纪那些被广泛使用的经典调参方法。机器开始造人类没造过的东西了。Koza 给遗传编程起了个外号,叫 automated invention machine,自动发明机器[19]。这词儿一点不夸张。
收尾的那张专利证书,就是开头说的那项。2002 年,Keane、Koza、Streeter 三个人,把遗传编程进化出的一个改进型控制器拿去申请专利,2005 年 1 月,美国专利 6,847,851[1] 正式授权。一台机器进化出来的设计,真真切切地走完了人类专利体系的全套流程,拿到了证书。这是演化算法自己设计、又真拿到美国专利的最早一批成果。机器到底能不能算发明人,这几年法学界 一直吵个不停[20]。这里也得诚实补一句,要论史上第一个跟 AI 沾边的专利,时间还能往前推到 1998 年 Stephen Thaler 那台 Creativity Machine[21] 名下,所以遗传编程这项,严谨说法是演化方法里最早拿到专利的那批,而不是绝对的第一个。
这些成果不是孤芳自赏。从 2004 年起,演化计算这个圈子专门设了个奖,叫 Humies[22],全名就是 human-competitive results 奖,每年在 GECCO 大会上颁,奖金一万美元,金奖五千、银奖三千、铜奖两千,全是 Koza 自己掏钱赞助的。一个搞彩票出身的人,最后用奖金去鼓励别人造出更多媲美人类的机器成果,这条线绕得挺有意思。
到 2010 年,Koza 在一篇综述里统计,遗传编程产生的 human-competitive 成果已经 至少 76 项[23]。机器能发明,在那个时候就已经算不上科幻。可故事讲到这儿,有个尴尬的问题绕不过去:深度学习起来之后,神经网络几乎全用梯度下降,这套靠进化造发明的老路子,会不会已经过气了?
七十年过去,这个老梦想突然又活了
实话实说,遗传编程后来确实没站在聚光灯中央。神经网络火遍全球,梯度下降成了绝对主流,进化这条线退到了一些专精的角落。它今天还活着,但活得低调。最有生命力的那个分支,叫符号回归。
符号回归干的事,你一听就懂:给它一堆实验数据,让它直接搜出一个能解释这些数据的数学公式来,而不是给你一个看不懂的黑箱。2009 年,两位研究者用这招,从实验数据里自动重新发现了物理定律[24],做成了一个叫 Eureqa 的工具。今天还有 gplearn[25]、PySR[26] 这些开源库在用。圈子里也有人在认真反省它的效率问题,2024 年就有论文 专门批评遗传编程在符号回归上搜得不够快[27]。一个领域有人这么较真地挑它毛病,恰恰说明它没死。
真正让这条老线焕发第二春的,是它跟大模型撞上了。2025 年 5 月,DeepMind 发布了 AlphaEvolve[28],一个会进化代码的智能体。它的成绩单很硬:在矩阵乘法这个被啃了半个世纪的问题上,它找到了一种用 48 次标量乘法相乘两个 4×4 复数矩阵的新算法,把 Strassen 1969 年保持的纪录[29] 往前推了一步,这是 56 年来头一回[30]。它优化出来的调度方案,在 Google 的数据中心跑了一年多,平均持续帮谷歌省回了大约 0.7% 的全球算力。它还把训练 Gemini 用的一个核心运算加速了 23%。
AlphaEvolve 听着像个全新的东西,可你把它的工作方式拆开看,会发现一股熟悉的味道。它的官方论文里,自己就把话挑明了:
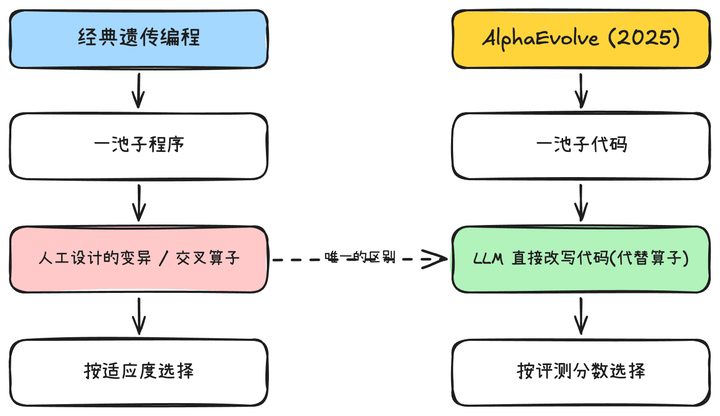
AlphaEvolve extends a long tradition of research on evolutionary or genetic programming. 说白了,AlphaEvolve 接的就是遗传编程这条几十年的老线。再往近了说,它是 2023 年 FunSearch[31] 的升级版。它跟 Koza 那套循环,骨架是同一副。一池子程序、变异、选择、再生,这套流程一模一样。唯一变了的地方,是那个负责改写程序的算子:Koza 当年得靠人工设计变异和交叉怎么操作,AlphaEvolve 直接把这一步交给了大语言模型,让模型凭着自己读过的海量代码,去改写、去试。两边的循环摆在一起,差别就这一处:
这条线的来龙去脉,拉通了看是这样的:
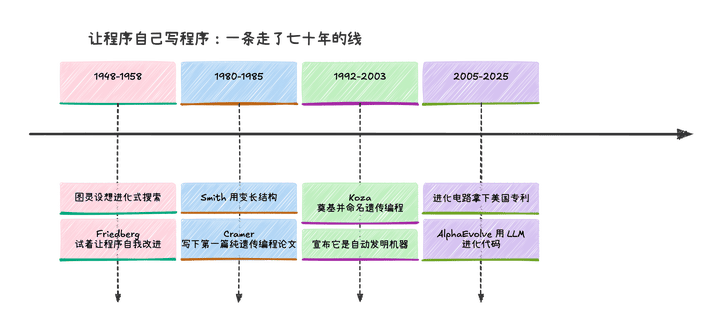
从图灵 1950 年那句被忽略的设想,到 Smith 和 Cramer 的火种,到 Koza 的自动发明机器,再到今天 AlphaEvolve 改写算法,中间隔了七十年,绕了一大圈。这条线的内核从没变过:不靠理解,靠试错加选择,照样能搜出好东西。早些年大家觉得它打不过梯度下降,可在那些根本没有梯度可用、或者人类自己都没想明白的地方,这套又笨又倔的办法,反而还是最优解。它跟大模型一结合,威力被重新放大了。AlphaEvolve 具体怎么和 LLM 缝在一起、它跟梯度下降到底谁吃哪块地盘,后面两篇会专门拆,这里先按下不表。
写到这儿,值钱的是什么,慢慢清楚了。写代码的速度越来越不稀罕,真正稀罕的,是有没有本事去判断一个你没设计、甚至看不懂的方案,到底对不对、好不好。Koza 的机器进化出了立方根电路,可得有人能看懂它确实算对了,才敢拿去申请专利。AlphaEvolve 改写了矩阵乘法,可得有人能验证它确实更快了,才敢部署到数据中心。机器越能发明,人类的角色就越往判断和验证那一端挪。
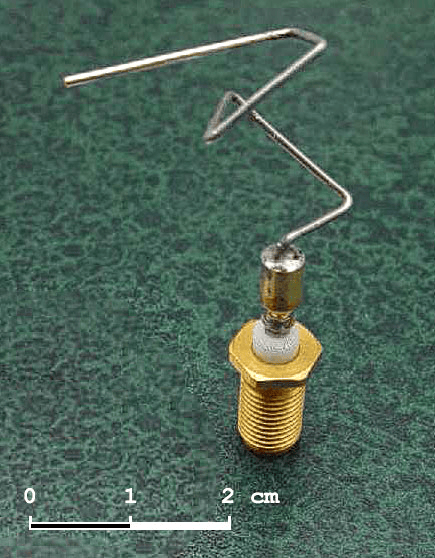
NASA ST5 卫星上那根进化出来的天线
回到开头那张专利证书。编号 6,847,851 的那块电路,真正的设计者不会写代码,不懂电路,也不知道自己造出了能上专利局的东西。它只是被一代代地试、一代代地选,然后某一代,刚好长对了。七十年前图灵就猜到了这条路能走通,只是他没等到机器真把发明这件事干成。而现在,轮到我们这代人,来回答他留下的那个更大的问题:当机器越来越能不理解也造出答案,我们到底该让它学会理解这个世界,还是干脆放手,让它像自然那样,进化出我们想都想不到的东西?这个问题,这个系列会一直追到最后一篇。更早几篇的来龙去脉,都收在 硅基进化论 这个专栏里。