传统T细胞的识别由T细胞受体(TCR)的α链和β链配对共同介导。从受体序列预测靶抗原,反之亦然,具有多种诊断和治疗应用。由于TCR通过随机的基因重排过程产生,其巨大的潜在多样性远远超过任何单个个体中有限的T细胞数量。因此,不同个体针对同一抗原应答时通常使用不同的受体,这使得推导特异性的通用规则变得复杂。即便如此,在针对同一分子靶点的应答中,一条或两条受体链中常观察到共享的序列基序。
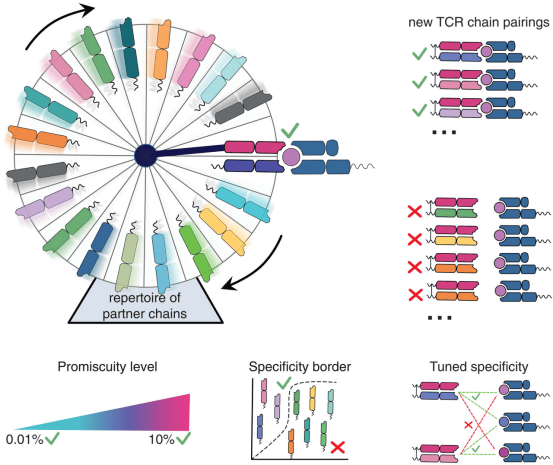
在一项新的研究中,研究人员探讨了每条链在TCR识别中的相对作用,特别是序列基序集中在一链中的情况。他们开发了一种链替换系统,能在大细胞群体中选择性移除内源性TCR链,并用一条携带针对已知靶点的强基序的链进行替换。实际上,固定一条链创造了一个“生物搜索引擎”,扫描健康供体自身的T细胞,以“钓出”与靶标结合兼容的配对伙伴。这使得研究人员能在少数个体中观察到原本需要采样数百万人才能发现的多样性水平。
研究人员发现,几乎所有链组合(>94%)都能在细胞表面形成稳定的受体,但只有一小部分(约0.1%至10%)能够识别预期靶标。在10个抗原靶点中,他们回收了超过70,000个特异性受体,大幅扩展了已知的目录。由于大多数(90%至99.9%)随机候选伴侣链无法维持表位识别,他们的数据突显了仅依赖单链数据来推断特异性的局限性。
这些结果给特异性预测带来了难题,因为他们回收的每一个TCR都包含一条带有强抗原相关基序的链。因此,非结合性受体常被领先的特异性预测算法误判为阳性——这些算法容易被单链匹配所欺骗。用密切相关的但非结合性阴性样本重新训练这些算法,收窄了这些模型的特异性边界。随着该领域向结构模型发展,研究人员发现,相比于选择性链,混杂性链与表位靶标之间往往有更多预测的接触,且预测结构能解析部分(但非全部)特异性边界的特征。
最后,尽管链替换是为了探索识别规则而开发的,但它在调节TCR特异性以区分密切相关的靶标方面具有实际价值。研究人员通过工程化TCR证明了这一点——这些TCR对癌症特异性新抗原的识别得到改善,同时对非突变表位的自身反应性降低。
综上所述,TCR链通过一种不对称的逻辑协作,配对约束与识别兼容性在不同表位靶标上跨越了三个数量级。在序列和结构上绘制这些约束,对于理解链配对如何促进靶标识别至关重要——这是仅从序列预测特异性的先决条件。这些见解将改进计算模型,并推进用于诊断和治疗用途的预测算法。
小贴士
本文内容转载至iNature,仅为学术分享,如涉侵权请联系删除。