机器人学不会折衣服,问题不在脑子,在手感——更准确地说,是没有足够多的“手感样本”。
大模型能火,靠的是互联网上现成的海量文字。可“拧开瓶盖”“叠好一件衬衫”这类动作,网上没有现成语料,机器人想学,就得有人一遍遍做给它看。过去主流的办法是真机遥操:人拿手柄、戴 VR 去操纵机器人,一个动作一个动作地示范。数据质量是高,但慢、贵,还受机器人和场地限制,想凑够训练量,成本高得吓人。
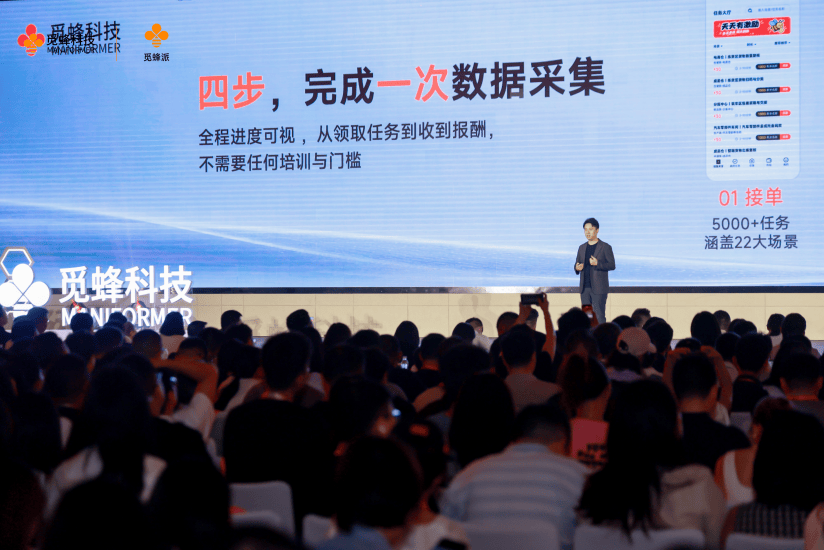
9 月 23 日,觅蜂科技发布“觅蜂派”——一个物理 AI 数据众包平台。逻辑很直白:你下载 App 领个任务,戴上 MEgo 设备,在熟悉的超市、仓库、家里按提示做动作,数据上传、过审,按有效时长拿报酬。这些数据经过治理分级,最终喂给具身模型,让机器人学会干活。因为路子像 Figure 今年 8 月推出的 Index,外界管它叫“中国版 Index”。

但两者其实不是一路。Index 是给 Figure 自家模型供数据,闭环玩;觅蜂派面向的是更广的客户——模型厂商、机器人公司、数据采购方,谁有需求就按谁的标准组织生产,把处理好的数据当成服务卖出去。听着更灵活,实则更难:客户越多,要覆盖的行业、任务、长尾场景就越杂,采集标准、数据治理、稳定交付的压力也成倍上涨。这恰恰是它最值得看的地方——“全品类”和“高质量”这两个词,一个管广度,一个管深度,缺一个都撑不起来。
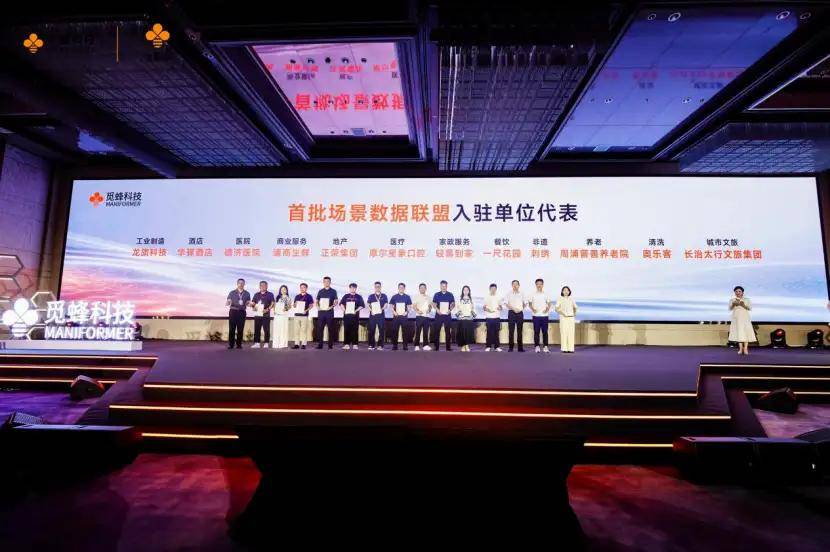
众包这招其实不新鲜,难的是把零散的日常经验,变成能训练模型的标准数据。行业现在的共识是三条腿走路:无本体采集铺规模,真机遥操给贴近本体的数据,真实部署让模型持续纠错。要冲具身 AGI,数据量得从百万小时级蹦到亿级小时,靠老办法线性堆根本堆不出来,必须用众包这种杠杆去撬。
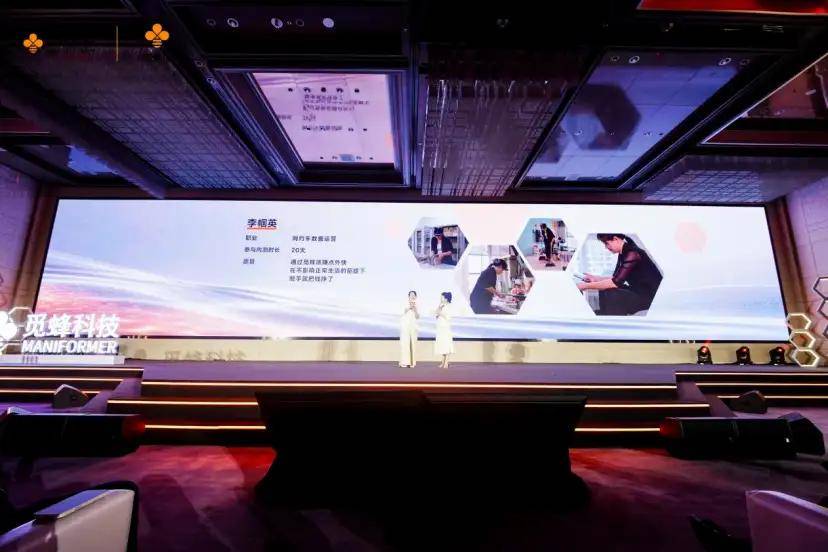
内测一个月,觅蜂派攒下 2 万注册用户、1.3 万份采集任务。参与者挺有意思:42 岁的网约车运营人员李国英,下班后录下浇花、擦玻璃、整理桌面的过程,十几分钟上传一批,过审就有钱,“生活兼顾了,还有份额外收入”。苏州糕点技艺传承人陆小星,则把揉制、包馅、压模的力度和节奏录下来,给非遗留下新的数字载体。这些不是摆拍的演示,而是带着真实生活痕迹的动作——恰恰是模型最难从实验室里获得的。
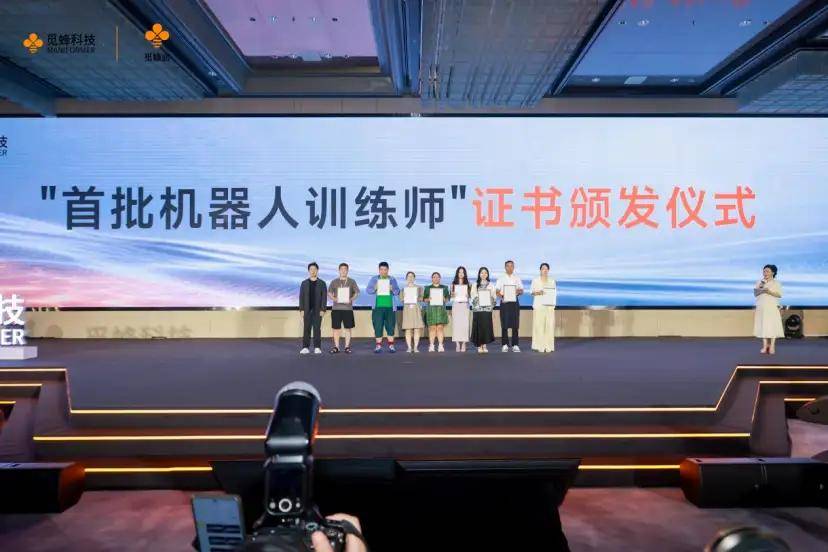
我的看法是:觅蜂派真正的赌注,不在“众包”这个壳,而在两件事——能不能把五花八门的采集场景标准化成可用数据,以及能不能让海量普通人稳定交出高质量样本。Figure 的 Helix 2.5 实验已经证明众包数据有价值:在 30 套陌生住宅里,靠 Index 预训练,零样本成功率从 9% 拉到 56%。方向是对的。
但也别太乐观。人一多,数据质量就参差,审核和治理是硬骨头;用户愿不愿意长期戴着设备干活,也取决于报酬有没有吸引力;再加上隐私、数据归属这些绕不开的问题。觅蜂派想做的,是一张持续生长的物理 AI 数据网络。这张网能不能织起来,考验的不是技术秀,而是耐心和标准。