智猩猩AI整理
编辑:知知
然⽽,这些痕迹很难直接标注,现有⽅法通常只能通过篡改区域的标注间接学习。
这样的监督也给模型留下了⾛捷径的空间:它可能依赖图像内容,⽽⾮篡改痕迹进⾏判断,进⽽影响跨数据集的泛化能⼒。
针对这⼀痛点,四川⼤学吕建成团队提出两阶段训练范式 PAL(Pairwise Artifacts Learning),利⽤成对编辑关系(pairwise edit relations)显式地把 artifacts 从特征中解耦出来,并配套构建了大规模数据集 EditGroup-45K。
在下游定位阶段,PAL 不需要改动模型结构,只需⽤预训练得到的权重初始化 backbone,再进⾏标 准定位训练。论⽂在 6 种 backbone 和 5 个主流 IML ⽅法上都观察到了提升。
其中,ConvNeXt Small 配置下的跨域平均 F1 从 0.5320 提升⾄ 0.5868。
该研究成果已被 NeurIPS 2026 接收为 Oral 报告,是 NeurIPS 历史上第⼀篇 IML ⽅向的 Oral 论⽂。
01
为什么模型容易学到语义捷径
IML 模型接收图⽚x,预测⼆值 masky,逐像素标记篡改位置。
现有⽅法通常通过端到端训练学习 artifacts,也有⽅法在此基础上引⼊⼿⼯特征约束。
(一)端到端学习
⽤篡改区域的 mask 直接监督模型,让模型⾃⾏学习定位所需的特征。
但模型容易学到 semantic shortcut(语义捷径),依赖物体类别、场景内容等线索进⾏判断。
再加 上 label noise(标注噪声)的⼲扰,学到的特征未必能适应其他数据集。
(二)引⼊⼿⼯特征
为了让模型更多地关注篡改痕迹,⼀些⽅法在⽹络中加⼊ SRM 滤波器、 Bayar 卷积等⼈⼯先验。
不过,这些先验通常针对特定的低层信号设计,⾯对不同的篡改⽅ 式,适应能⼒仍然有限
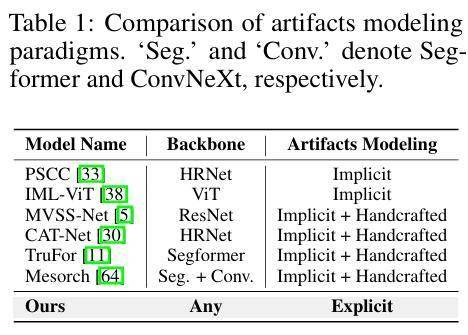
图 1: 隐式建模与显式建模两种范式的对⽐
论⽂由此提出⼀个问题:没有直接标注,能不能给 artifacts 的学习提供更明确的监督?
02
用成对编辑关系解耦 artifacts
论⽂将artifacts 看作潜变量(latent variable)z ,把 IML 重新表述为:
现有⽅法直接学习从图像到 mask 的映射p(y|x) 。
论⽂则将其拆成两步:先学习对 artifacts 敏感的表示p(z|x) ,再学习从这⼀表示到定位结果的映射 p(y|x)。
监督信号来⾃ edit relation,也就是原图与其篡改版本之间的直接编辑关系。
数据集将原图锚点及其编辑版本组织成 Edit Group。
每个 Edit Group 包含⾄少⼀张原图锚点及相关的篡改版本,每张篡 改图都关联其具体的来源原图。
由此可以构造两类图像对:
edit-related 图像对:原图与由它直接⽣成的篡改版本,两者的差异同时包含内容变化和编 辑留下的 artifacts。
non-edit-related 图像对:不存在直接编辑关系的图像对,例如原图与另⼀组的篡改图,或 同组的两个篡改版本。
这为 artifacts 提供了直接的关系监督,有助于减少语义捷径,但并不意味着特征中的语义信息被完全消除
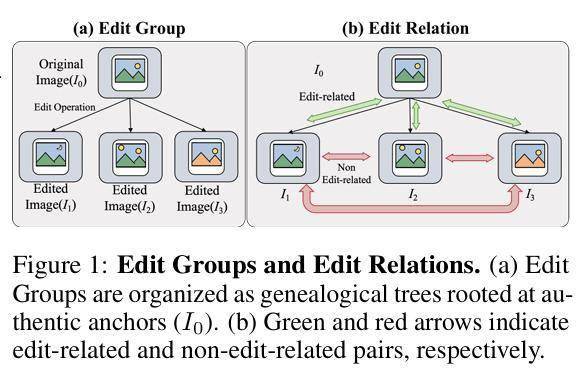
图 2: Edit Group 与 Edit Relation 示意
这两步分别对应 Pairwise Artifacts Learning(PAL)和 Standard Localization(SL),整体流程如下。
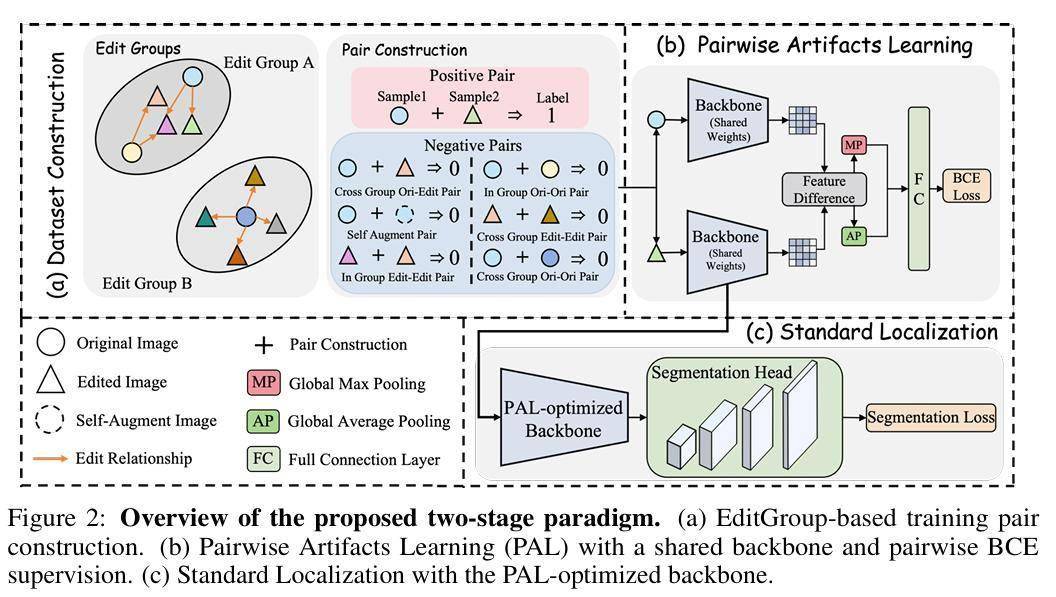
图 3: PAL + SL 两阶段范式总览
(一)第⼀阶段PAL:显式学习p(z|x)
两张图像经过共享权重的 backbone 后,模型计算特征差,将其聚合为关系向量, 再预测这对图像是否存在直接编辑关系,并⽤ BCE 损失训练。
具有直接编辑关系的图像对标为 1, 其余负样本对标为 0。
正负样本还需要尽量满⾜ marginal matching(边缘分布匹配)约束。
直观地说,负样本也要包含篡 改图和多样的图像内容,让模型难以只看其中⼀张图就猜出关系标签。为此,论⽂设计了六类负样本:
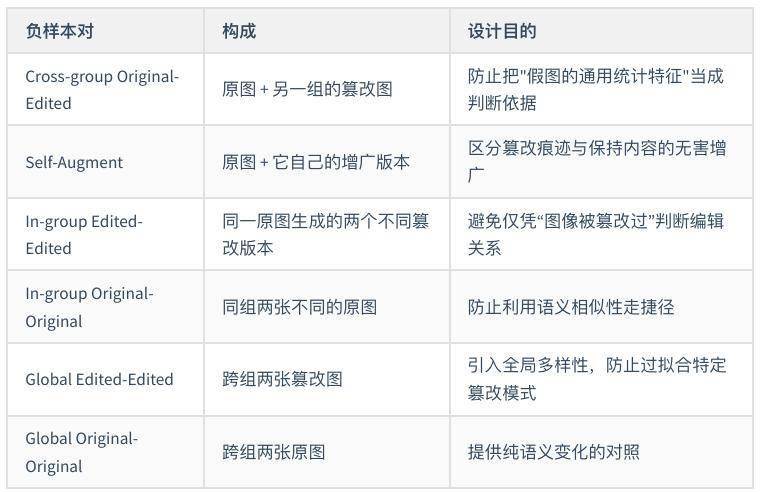
(二)第⼆阶段 SL:学习p(y|z)
⽤ PAL 预训练的权重初始化定位模型,再按对应⽅法的标准协议,⽤像素级 mask 进⾏训练即可, ⽆需增加新的⽹络模块。
成对输⼊只⽤于第⼀阶段:定位训练和实际推理仍输入单张图像,不需要额外提供原图。
(三)EditGroup-45K 数据集
PAL 的训练需要⼤量原图与篡改版本之间具有明确对应关系的图像对,但现有数据集难以满⾜这⼀ 需求。
⼤规模数据集往往缺少对应的原图,保留原图的数据集规模⼜较⼩,⽽且多数只覆盖⼈⼯篡改或 AIGC 篡改,缺少对两类场景的共同覆盖。
为⽀持成对训练,作者构建了 EditGroup-45K,共包含约 4.55 万个 Edit Group、5.21 万张原图和 23.25 万张篡改图像,合计约 28 万张。
其中约六成为人工篡改,覆盖 copy-move、splicing、removal;约四成为 AIGC 篡改,涵盖局部重绘与内容修改。
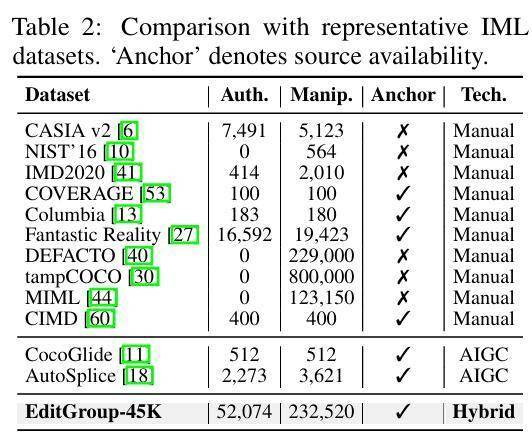
图 4: EditGroup-45K 与代表性 IML 数据集对⽐
03
跨域泛化提升与artifacts解耦验证
定位阶段遵循 Protocol-CAT,使⽤ CASIA v2、IMD2020、FantasticReality 和 Tampered COCO 等数据训练。
实验采⽤ pixel-level F1 作为性能指标,在 CASIA v1、Coverage、NIST16、Columbia、 AutoSplice、CocoGlide 六个测试集上评估。
其中,CASIA v1 ⽤于评估域内表现,其余五个数据集⽤于评估跨域表现。
跨域平均 F1(Cross Avg)是这五个测试集的平均值,整体平均 F1(All-Avg)则是六个测试集的平均值。
(一)效果与迁移性
在 ConvNeXt-Small 配置下,PAL 的跨域平均 F1 从 0.5320 提升⾄ 0.5868,六个测试集的平均 F1 从 0.5661 提升⾄ 0.6266。
PAL 在 6 种 backbone 和 5 个主流 IML ⽅法上均带来提升,覆盖 CNN、Transformer 等不同架构。
下游实验保持模型结构与训练协议不变,仅替换初始化权重;backbone 实验中,六个测试集平均 F1 的相对提升为 5.9%~14.0%。

图 5: PAL 在不同 backbone 和 IML ⽅法上的迁移结果
从论⽂展示的 copy-move、splicing、inpainting 样本看,PAL 初始化后的预测 mask 与真实标注 (GT)更⼀致,误报也更少。
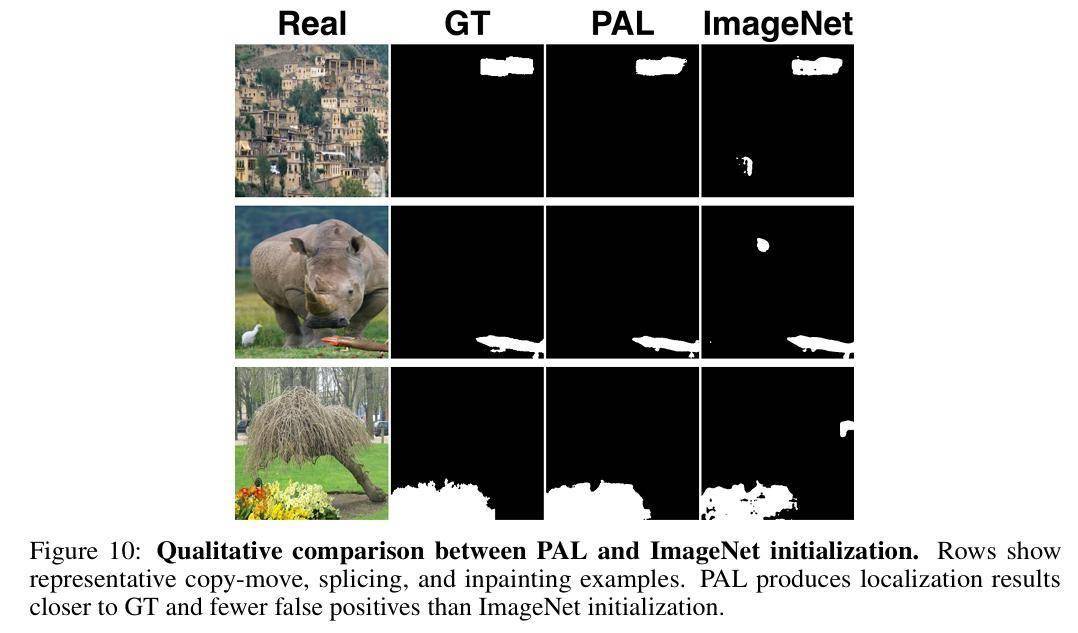
图 6: PAL 与 ImageNet 初始化的定位结果对⽐
(二)消融实验
PAL 的提升主要来⾃更多的预训练数据,还是成对监督本身?
论⽂固定使⽤ ConvNeXt-Small,⽐较 了三种初始化⽅案。
Baseline 直接使⽤ ImageNet 权重。
ABS(absolute binary supervision)在 EditGroup-45K 上进⼀步进⾏单图⼆分类预训练,将原图标为 0、篡改图标为 1。
PAL 则使⽤同⼀数 据集学习图像之间的编辑关系。
三种⽅案随后都进⾏相同的定位训练。
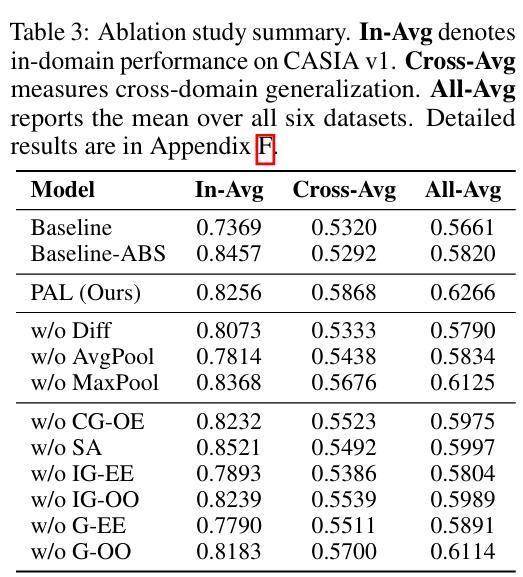
图 7: 监督形式、特征差表示与负样本设计的消融结果
ABS 的跨域平均 F1 为 0.5292,略低于 Baseline 的 0.5320,⽽ PAL 达到 0.5868。
也就是说,同样使 ⽤ EditGroup-45K,单纯学习区分原图与篡改图,并没有带来跨域收益,成对监督才体现出了优 势。
论⽂还⽐较了不同预训练数据⽐例下的表现。
数据⽐例从 10% 增加到 100% 时,PAL 持续受益; ABS 则在约 50% 时趋于饱和,使⽤全量数据后略有下降。
这进⼀步说明,增加数据量能否带来收 益,也取决于监督⽅式。
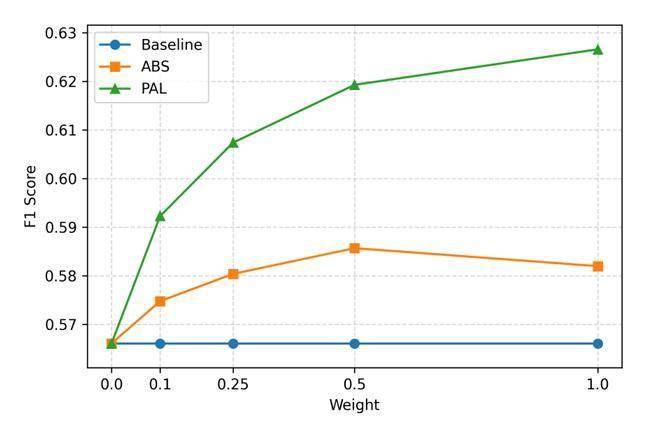
图 8: 不同预训练数据⽐例下的性能对⽐
在六类负样本的消融中,去掉 In-group Edited-Edited 后跨域表现下降最明显,表明同⼀语义内容下不同编辑版本之间的对照尤为重要。
去掉 Self-Augment 后,域内分数最⾼,跨域表现却⼤幅下降,提示模型更容易依赖源域特有的线索。
(三)PAL 真的学到 artifacts 了吗
篡改边界的特征响应可以⽤来观察模型对 artifacts 的敏感程度。
六个测试集上,PAL backbone 的边界激活强度均达到 ImageNet 预训练 backbone 的约 5~7 倍。
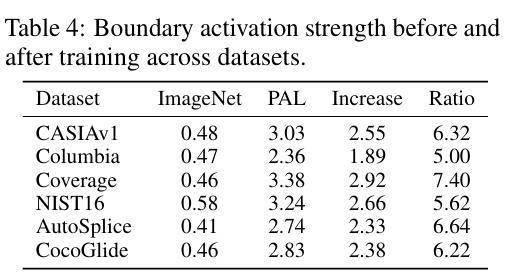
图 9: PAL 训练前后的边界激活强度对⽐
为观察超出语义变化的响应,论⽂⽤固定的 ImageNet 预训练 encoder 估计语义基线,并从 PAL 的成对特征差异中扣除这⼀基线。
⼈⼯局部篡改样本的响应主要集中在篡改边界,AIGC 全图编辑样本的响应则分布更⼴,⽀持模型学到了与篡改⽅式有关的线索。
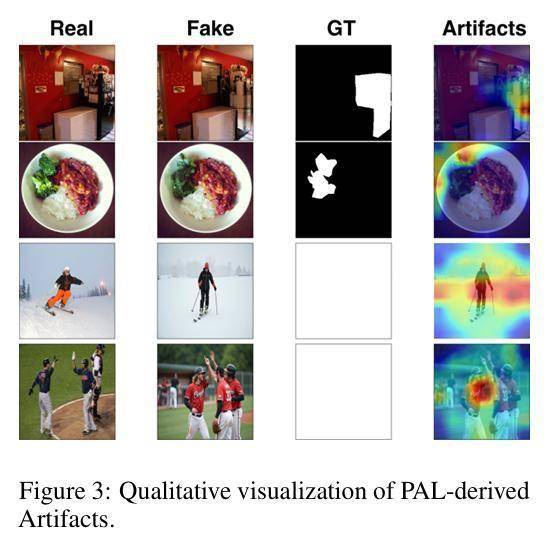
图 10: PAL 解耦出的 artifacts 可视化结果
(四)鲁棒性:经过后处理仍有收益
在 CASIA v1 上施加高斯模糊和 JPEG 压缩后,PAL 在各个测试强度下均保持更⾼的 F1,且随模糊加 重下降更缓。
这类测试也更接近图⽚经过社交平台压缩等后处理的使⽤场景。
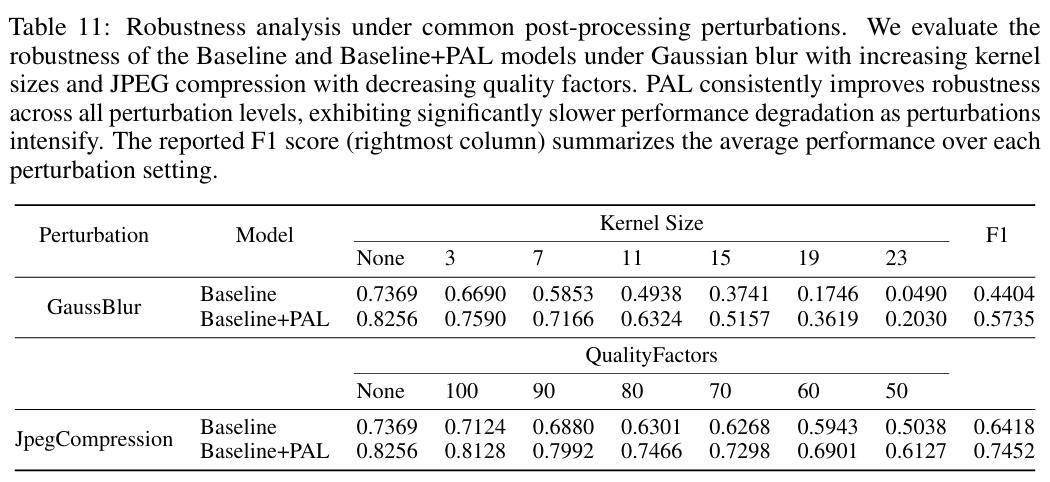
图 11: ⾼斯模糊与 JPEG 压缩下的定位性能