不靠刷分,国产机器人模型拿下全球榜首
10 月 9 日,星动纪元宣布其世界动作模型 VPP2 登顶 RoboDojo 仿真榜:平均成功率 32.26%,平均得分 39.26 分,在泛化、精细操作、记忆三个维度单独第一——RoboDojo 共评估泛化、记忆、精细操作、长程执行、开放语义五个维度,VPP2 拿下了其中三个。超越GPT-6 Astra、Physical Intelligence π0.5、英伟达GR00T-N1.7等模型。
更关键的是,VPP2未使用任何额外数据或Agent RSI,仅仅使用标准数据集就斩获了榜首,更加体现了VPP2模型本身的优越性——性能提升来自预训练,不靠外挂增强策略,不靠扩充数据“刷分”。
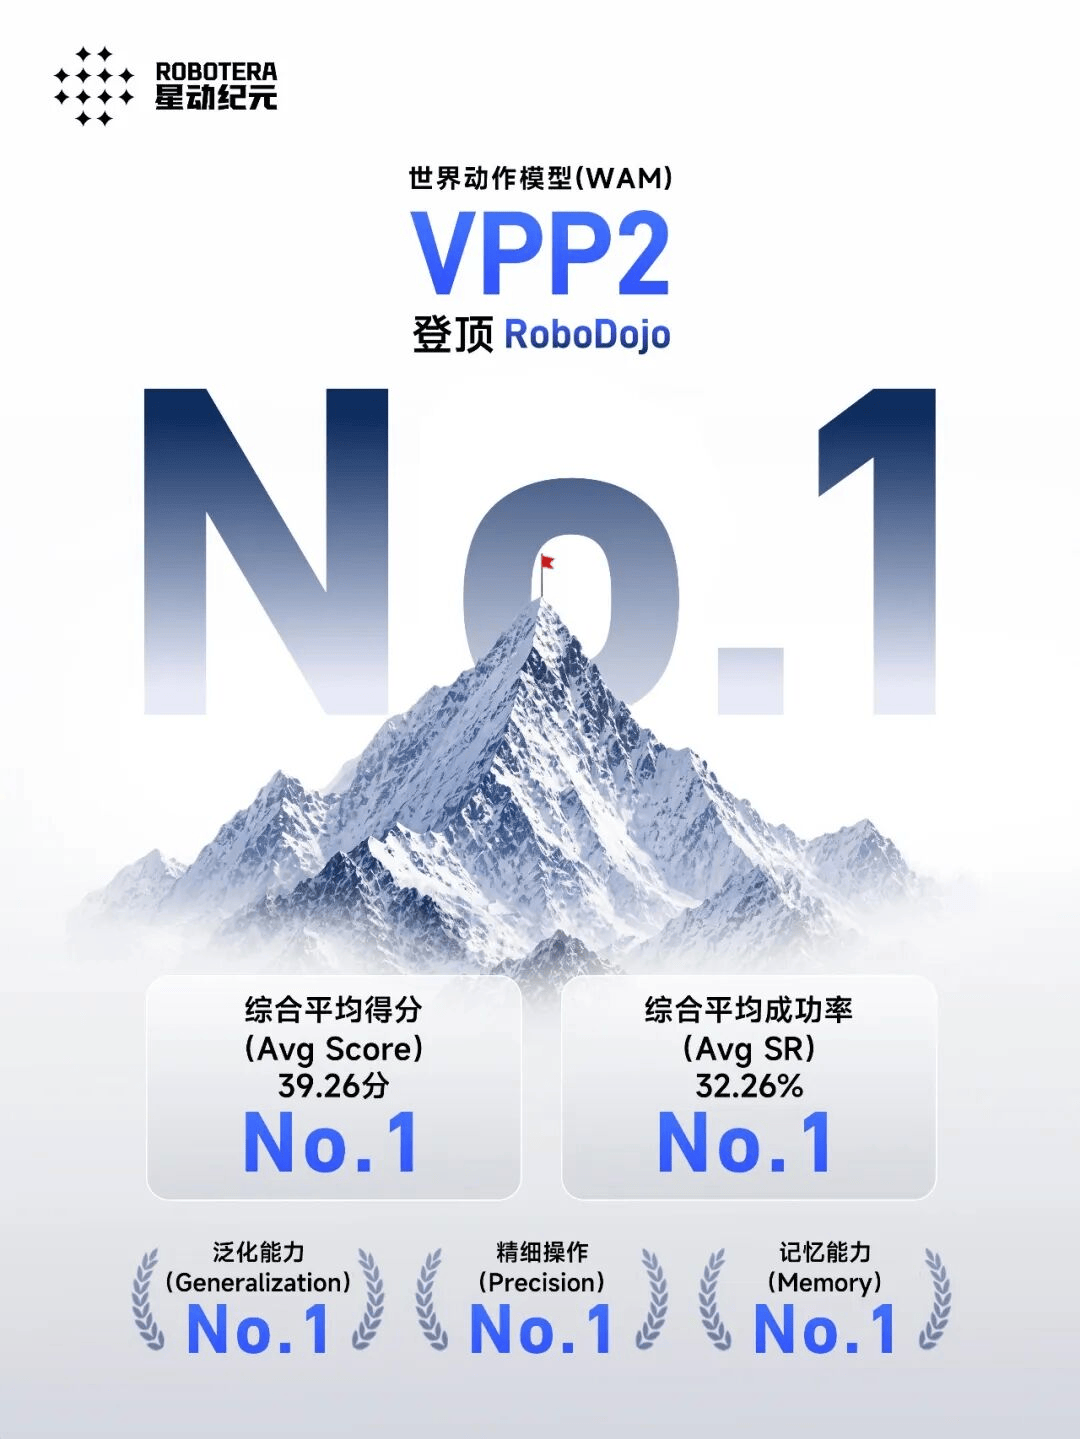
名次压过 GPT-6-Astra、Physical Intelligence 的 π0.5 和英伟达 GR00T-N1.7,同日开源。在真实 ALOHA 平台上,VPP2 的零样本成功率是 58.5%,π0.5 为 40.0%。
星动纪元 2023 年 8 月成立于北京,由清华交叉信息研究院孵化,创始人陈建宇是清华大学助理教授。它也是国内较早把机器人送进物流产线常态化作业的具身公司之一:在中国邮政、顺丰位于全国 5 个省市的 10 余个物流中心运行,公开报道称其在供件环节作业效率达到人工的 95% 以上,最高平均供件量 1200 件/小时。
这次公开的内容里,榜单之外还有一部分:一条数据处理管线,和一套把视频预测与动作生成分开排序的三阶段训练流程。它们要解决的不是分数,是同一个模型换个场景还能不能继续用。
PART 01
泛化这道坎,卡在数据还是卡在模型?
换个场景就要重来一遍,是具身智能交付成本里最难压的一项。训练时的桌面百发百中,换个杯子、挪个位置、换个光照,成功率掉一大截。每接一个新客户、新工位、新品类,往往就要重新采集数据、重新训练、重新调参。
这项成本降不下来,交付就只能停在项目制。项目制的麻烦在于人力跟着项目数走,规模铺得越大,成本涨得越快。
星动纪元给这次泛化能力提升做的归因是:一半来自训练策略,另一半来自数据工程。数据工程那一半,是这次公开材料里细节最多的部分。
VPP2 的数据底座覆盖五类来源的操作数据,不同来源配不同的过滤策略。原始视频进训练前要先过一条处理管线,核心目标是降低未来预测的不确定性:先过滤,只保留末端执行器可见的片段;再分割,按任务边界把长视频切开,由视觉语言模型合并相邻片段、微调起止点;最后由视觉语言模型为每个片段生成一段详细描述。
这几道工序都不涉及模型结构的改动。能否跨场景复用,取决于它们做得有多细。
PART 02
采集来的数据,凭什么能反复用?
描述生成这道工序有个硬性要求:必须无歧义。
星动纪元在图注里给出的写法是"指定左侧的杯子,桌上有两个杯子"、"指定最左侧的黄色盒子,桌上有三个盒子"。桌上摆着不止一个同类物体时,只写"杯子"或"盒子",模型拿不到足够的定位信息。
歧义背后还有一层原因。团队在材料里给出的解释是:给模型的描述质量,决定了它学到的是"虚假相关"还是"任务因果"。一句粗描述,比如"把碗放进箱子",模型只能在画面里做概率猜测,映射关系飘忽不定、出现多个峰值;换成一段详细描述——左侧夹爪拿起左侧白碗、放入透明箱、摄像机视角保持静止——模型就被锁定到唯一且稳定的因果轨迹上。
每条描述被要求包含四个要素:任务说明、活动的末端执行器、无歧义的目标物体、摄像机视角。
近两年行业在数据工厂上投入不小,对外讲的口径多集中在采集小时数和遥操作规模。这条管线的设计把注意力放在了另一处:同一次操作,描述的粗细不同,模型学到的东西也不一样,标注规范是数据能否转化成能力的其中一环。它把"怎么标注"做成了一道固定工序,而不是交给采集人员临场判断。
同一条管线上还有一道工序,解决的是跨本体复用。团队对占总量 80% 以上的第一人称双臂数据做了两次对齐:一次是工作空间对齐,通过世界坐标系变换让不同机器人的工作空间可以比较;一次是末端执行器对齐,通过局部变换统一夹爪的原点与坐标轴方向。
两次对齐之后,"向左""向右"这类动作语义才在所有数据集之间保持一致。多机位数据被编排成 T 形合成图统一输入规格,主视角在左,两个辅助视角在右侧纵向堆叠,不足两个时用黑色占位图补齐。
坐标系不统一,数据就只是一次性消耗品。对齐之后,它才有可能沉淀成可跨机型复用的资产。
PART 03
三阶段训练里,哪几步是冲着产线去的?
数据就位之后,VPP2 构建在预训练的 Wan2.1-I2V-14B 视频模型之上,训练分三步:先在覆盖完整轨迹的事件级数据上做继续预训练,把视频底座练成一个可泛化的未来预测器;再在固定时域的视频块上后训练,并引入一致性蒸馏;最后才接入动作专家。
第二步里的一致性蒸馏,把原本需要多步迭代去噪的生成过程压成单次前向——这一步压缩的是视频预测。按官方给出的数字,8 秒视频预测约 0.1 秒,动作专家总延迟约 0.22 秒,两者合计仍在 0.3 秒量级,可实时闭环。对照物流供件最高 1200 件/小时、平均每件 3 秒的节拍,推理耗时并不构成卡点;蒸馏真正省下的是算力预算,让一条产线上同时跑更多工位,并把留给本体控制与异常处理的余量腾出来。
第三步接入的动作专家只有 0.9B 参数,采用混合 Transformer 架构,以全新初始化的方式接入,全程保留预训练获得的视频表示,学的是根据视频预测结果反推应执行动作的隐式逆动力学模型。它和 14B 的视频底座不在同一个算力量级上。
PART 04
27.6% 到 57.6%,这三十个点是谁给的?
团队在五个任务组上对比是否接入基于视觉语言模型的子任务规划,每组 50 次试验:平均成功率从 27.6% 提高到 57.6%,其中语言条件方块堆叠从 10% 提高到 52%,井字棋从 0% 提高到 38%。
分拣这类任务步骤相对固定,但真实场景里还有不少活儿需要连续多步完成、中途还要记住前面发生过什么。这三十个百分点的增益出现在同一套模型上,变量只有一个——加不加高层规划。增益来自分工方式:视觉语言模型负责把模糊目标拆成一串子任务描述,动作专家负责底层执行。
PART 05
从 5 个省市的物流网点看未来潜力
星动纪元的物流落地,给了这套方法一个可参照的样本:与中国邮政、顺丰合作,在全国5省市10 余个物流中心常态化运营。
十几个网点铺开,如果每个网点都要重新采集一遍数据、重新训一遍模型,交付成本压不住,这个规模跑不出来-通用性不够,规模"铺不开",是所有具身玩家绕不过去的坎。
VPP2 解决的正是这个问题:靠泛化能力,让同一套本领快速复制到新网点 —— 部署更快、分拣更高效、产线通用性再上一个台阶。
而物流只是起点:一旦泛化能力跑通,这套方法的尽头,是千行百业。
VPP2目前已同步开源可复现,价值高于排名本身。
开源代码:https://github.com/roboterax/video-prediction-policy-2
项目主页:https://robert-gyj.github.io/video-prediction-policy-2
参考文章
1、RoboDojo 仿真榜 2026.10.09 榜单数据
2、VPP2 论文《Video Prediction Policy 2: Predict Better, Act Better》
3、星动纪元物流落地公开业务资料
4、RoboDojo 基准论文《RoboDojo: A Unified SimandReal Benchmark for 5、Comprehensive Evaluation of Generalist Robot Manipulation Policies》
5、36 氪行业报道:清华具身模型登顶全球第一!突围 GPT6、英伟达,不靠外挂和额外数据
6、澎湃新闻报道:超越 GPT6 Astra,星动纪元世界动作模型登顶 RoboDojo 榜单并同步开源
7、星动纪元官网新闻板块产品、落地及公开技术演讲材料
8、光明网展会报道:星动纪元物流商业化落地相关公开信息
9、 RoboDojo 官方排行榜网页原始跑分页面数据源
(更多人形机器人赛道深度文章,请关注微信公众号“人形大讲堂”)
----------------END-------------------