芯东西(公众号:aichip001)
编辑 | GACS 2026
9月20-21日,由智一科技旗下智猩猩联合芯东西举办的2026全球AI芯片峰会(GACS 2026)在上海举行,在峰会主论坛上,亿铸科技创始人、董事长兼CEO熊大鹏以《通用存算一体的三大定律》为主题发表演讲分享。
亿铸科技熊大鹏谈道,3D DRAM架构下的存算一体方案,在大模型长文本推理场景展现出商业化落地潜力。
大模型与AI Agent持续落地,算力需求快速增长。传统CPU、GPU架构面临内外存储墙制约,数据搬运带来高额功耗,在长文本解码场景中算力利用率、Token吞吐能力都存在明显短板。存算一体技术提出多年,先后走过模拟、数字两条技术路线,但大算力商用芯片始终难以规模化落地。
亿铸科技选择3D DRAM作为存储介质,探索存算一体产业化路径,并提出通用存算一体三大定律:搬运代价定律、通用边界定律和异构终局定律。
同时该公司把芯片设计从以计算为中心转向以存储为中心,尝试破解芯片内的存储墙难题。现阶段,其商用芯片已完成仿真与验证,对比H200,在吞吐、功耗以及TCO上取得明显改善,在长文本大模型、Agent场景具备优势,目前亿铸科技正规划板卡、工作站等多种硬件产品,提供新的算力方案。
以下为熊大鹏的演讲实录:
业界普遍存在一个疑问:存算一体技术虽已纳入国家“十五五”计划,但迄今为止,大算力、商用级存算一体芯片仍无成熟落地先例。对此,我们可通过存算一体三大核心规律,解析商用存算一体芯片落地所需的必备条件。
一、行业转向数字存算一体,3D DRAM路线成商用关键
存算一体概念最早诞生于上世纪60年代末。2010年前后,密歇根大学科研团队孵化相关创业项目,行业研究与落地主要聚焦模拟存算一体路线。
2018年前后,模拟存算一体的固有缺陷逐渐凸显,行业开始转向数字存算一体技术研发。行业广泛基于SRAM、RRAM、MRAM、PCRAM等存储介质布局数字存算一体方案。这种技术的性能优势真实可落地,相较传统架构,其能效比可实现十倍、数十倍甚至百倍级提升,与各类学术论文披露的理论效果高度契合。

那商业化落地的瓶颈究竟在哪?首先是容量难题。去年年底Groq被英伟达以超200亿美元收购,但该方案仍存在芯片容量不足的短板,这也是其商用落地的一大阻碍。除此之外还有其他技术难题,早期存算一体方案因此难以实现规模化商用。
亿铸科技在2023年10月完成全数字化存算一体验证芯片的研发。测试验证显示,该芯片在矩阵计算场景优势突出。结合大模型未来演进趋势,我们判断,依托SRAM这类容量有限的传统存储介质打造存算一体芯片,难以匹配大模型发展需求。
因此在启动商用芯片研发时,我们选择3D DRAM作为存储介质。存算一体,“存” 居于首位,存储介质选型失误将直接导致项目失败。我们团队多维度评估后选定3D DRAM,其核心优势在于容量大、技术成熟、稳定性好且成本低廉。亿铸成为基于3D DRAM路线研发存算一体芯片的先行者。
二、打破内存墙的核心方案:存算一体
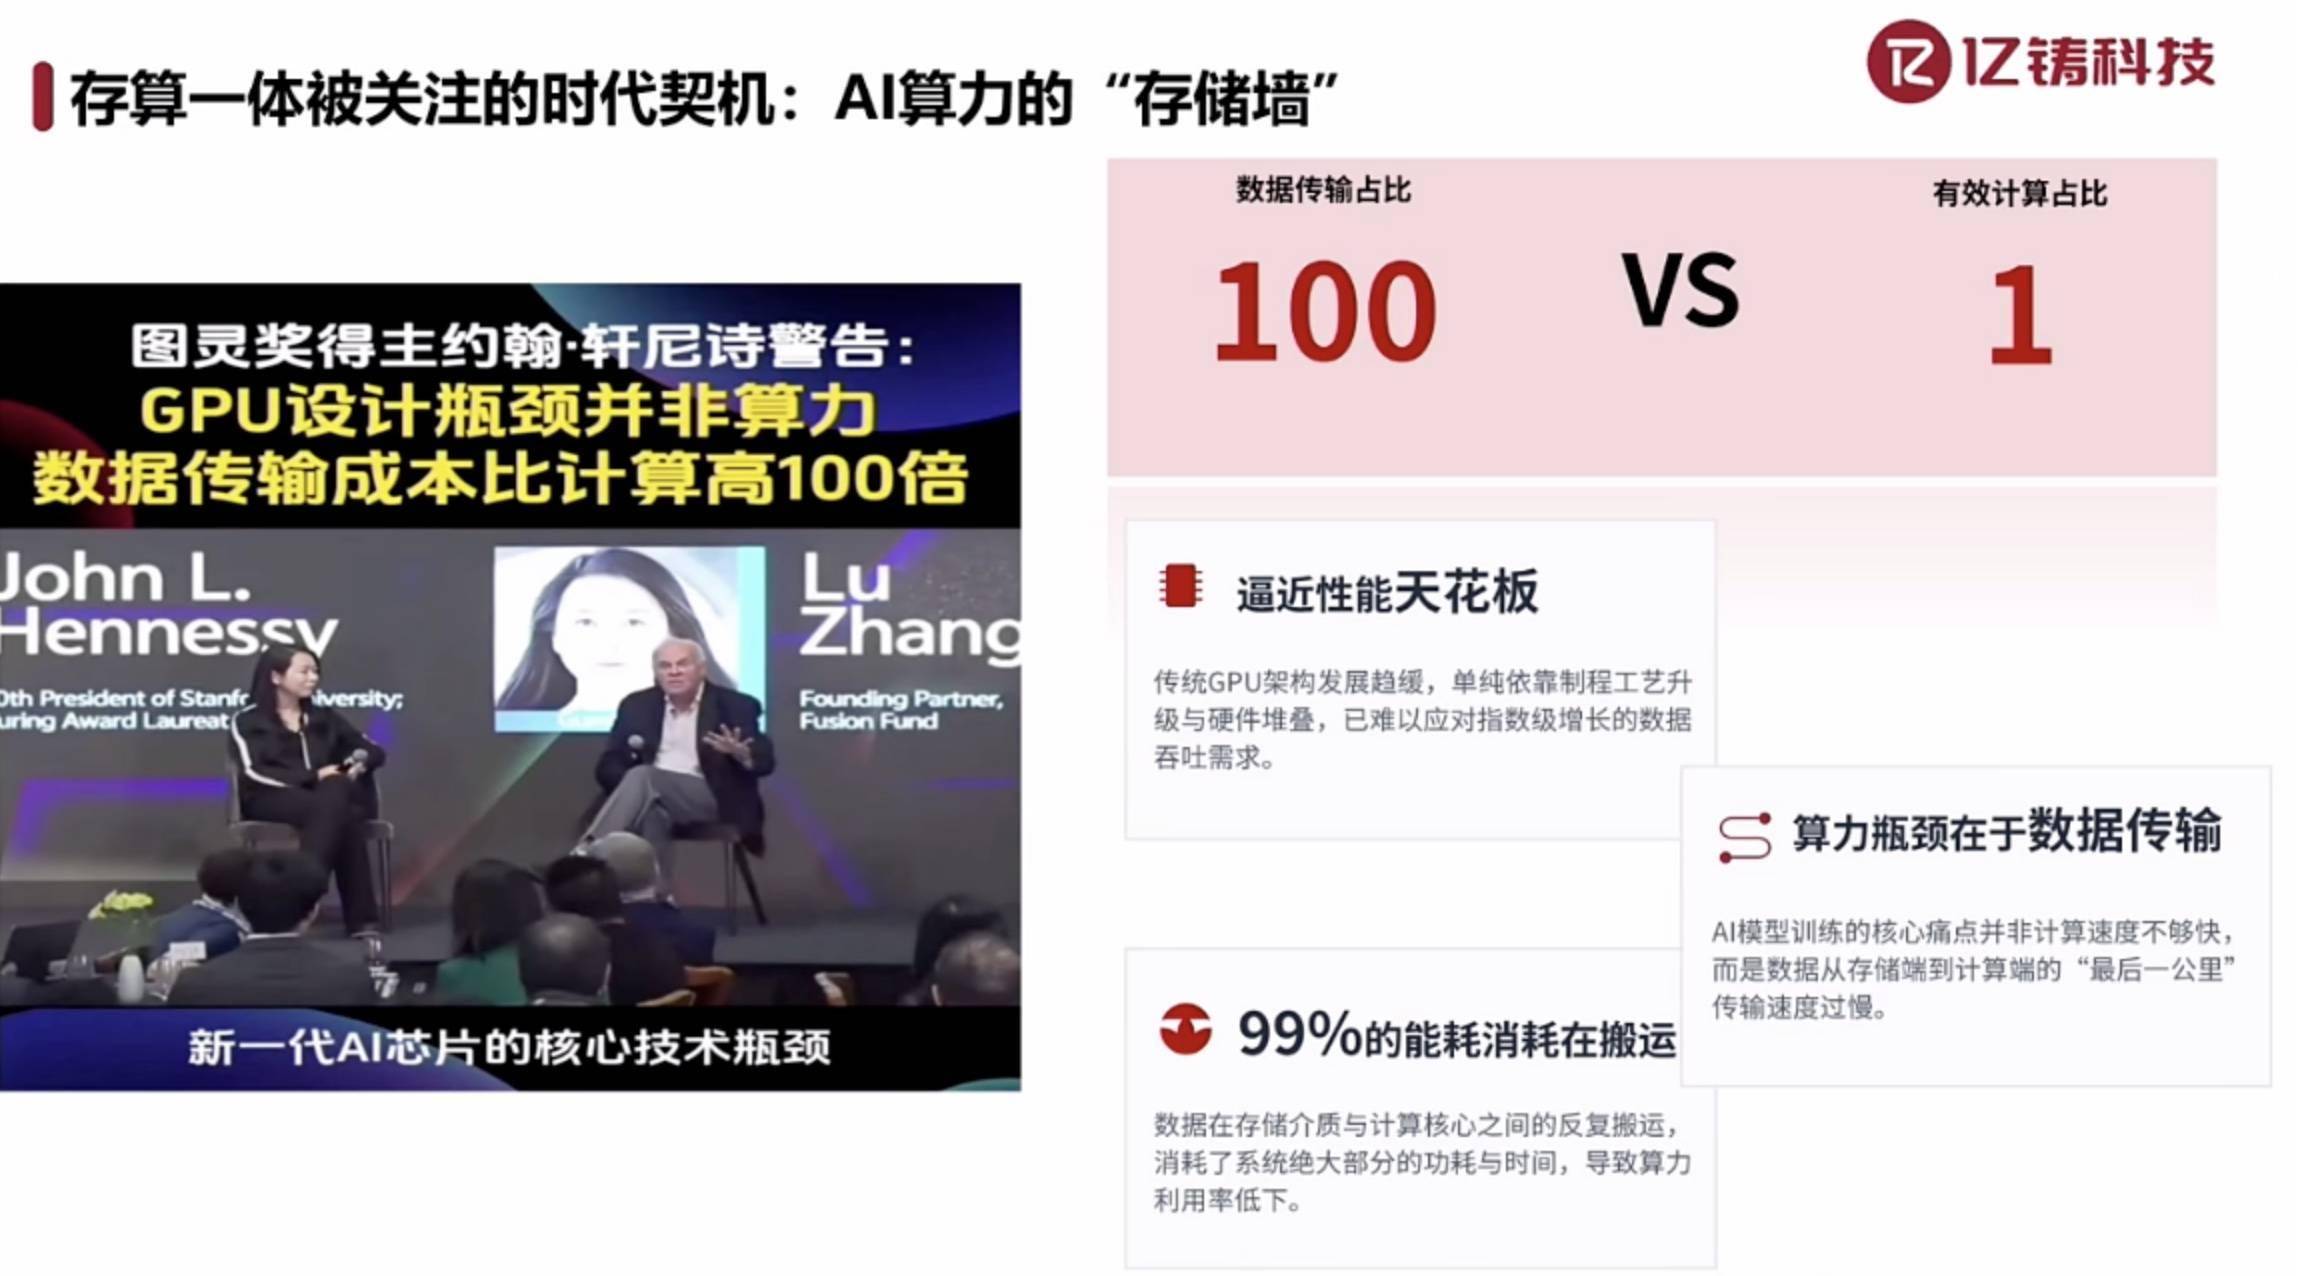
存算一体具备可行性有着底层逻辑:芯片工作过程中,数据搬运所消耗的资源占比超过99%。
图灵奖得主约翰·轩尼诗在演讲中阐述了上述底层逻辑,亿铸已点亮并完成测试的技术验证芯片,与该理论完全契合。这款验证芯片功耗仅数瓦,性能却超过功耗400瓦的4090显卡,实现了理论与工程落地的相互印证。以B300为例,其功耗超过1300瓦,如果采用存算一体架构,功耗可显著降低,技术潜力巨大。我相信,算力的终点是电力。
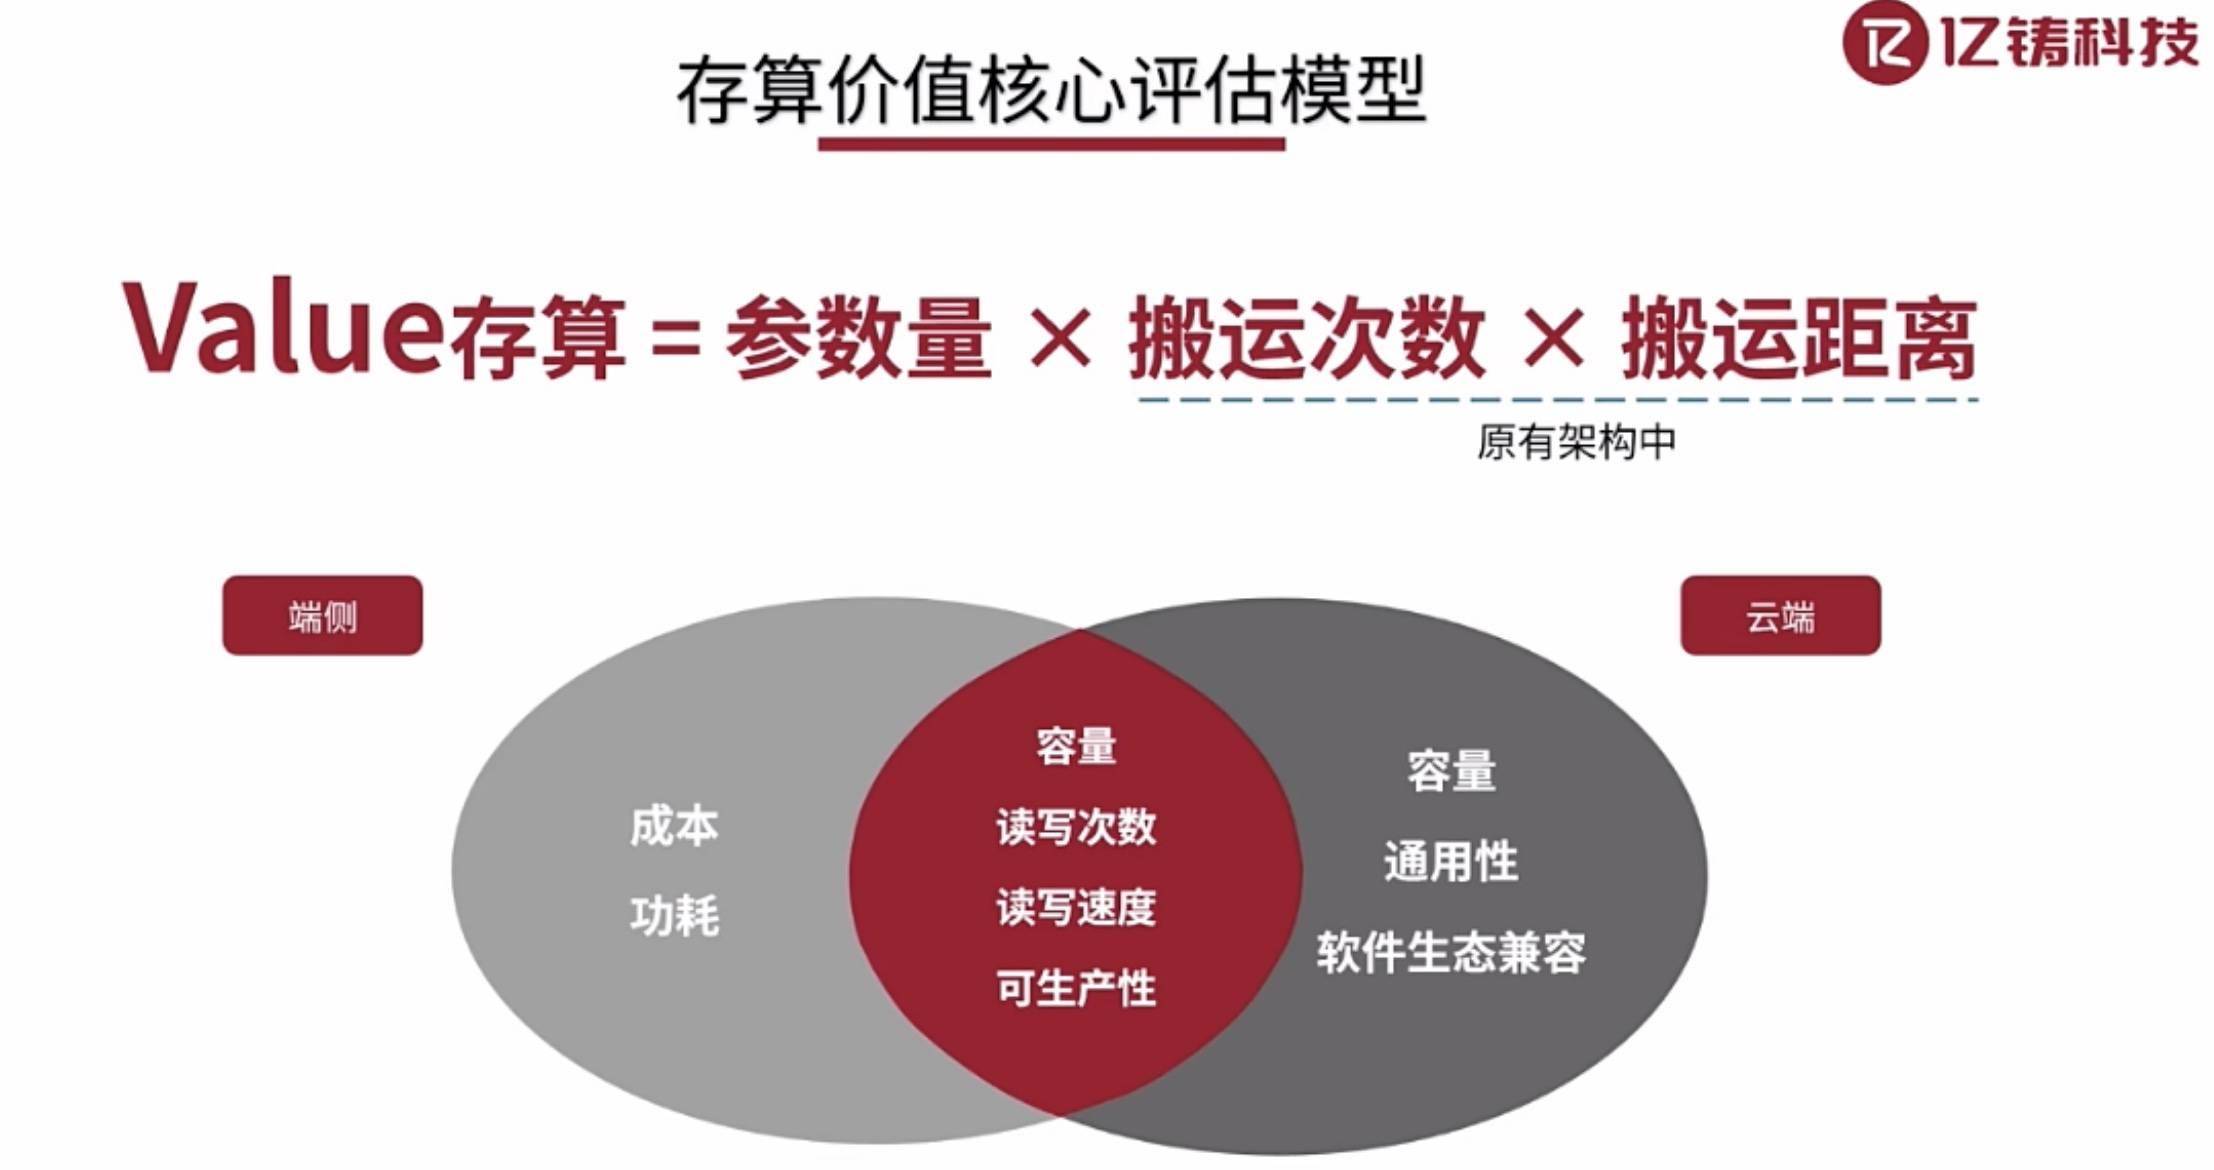
我们认为存算一体的核心评价模型,由参数量、数据搬运次数、搬运距离三项要素构成。三者均与功耗呈线性正相关:参数量越大、搬运次数越多、搬运距离越长,芯片功耗越高。大模型参数量持续增长,该维度难以人为控制;而存算一体可将数据搬运次数压缩至一次甚至零次,同时把搬运距离控制在微米级别,相较传统架构,能够实现数倍的数据搬运功耗削减。
AI算力架构经历了从CPU到GPU的演进。上世纪八九十年代,研究人员就尝试基于CPU搭建神经网络,但受限于算力,网络仅能做到三至五层。后续GPU被用于AI计算,相比CPU实现数十倍算力提升。发展至今,传统芯片架构已触及性能天花板,行业只能依靠先进工艺、优化片内数据带宽与互联链路,或是从系统层面做优化(例如英伟达即将推出的Vera Rubin)。
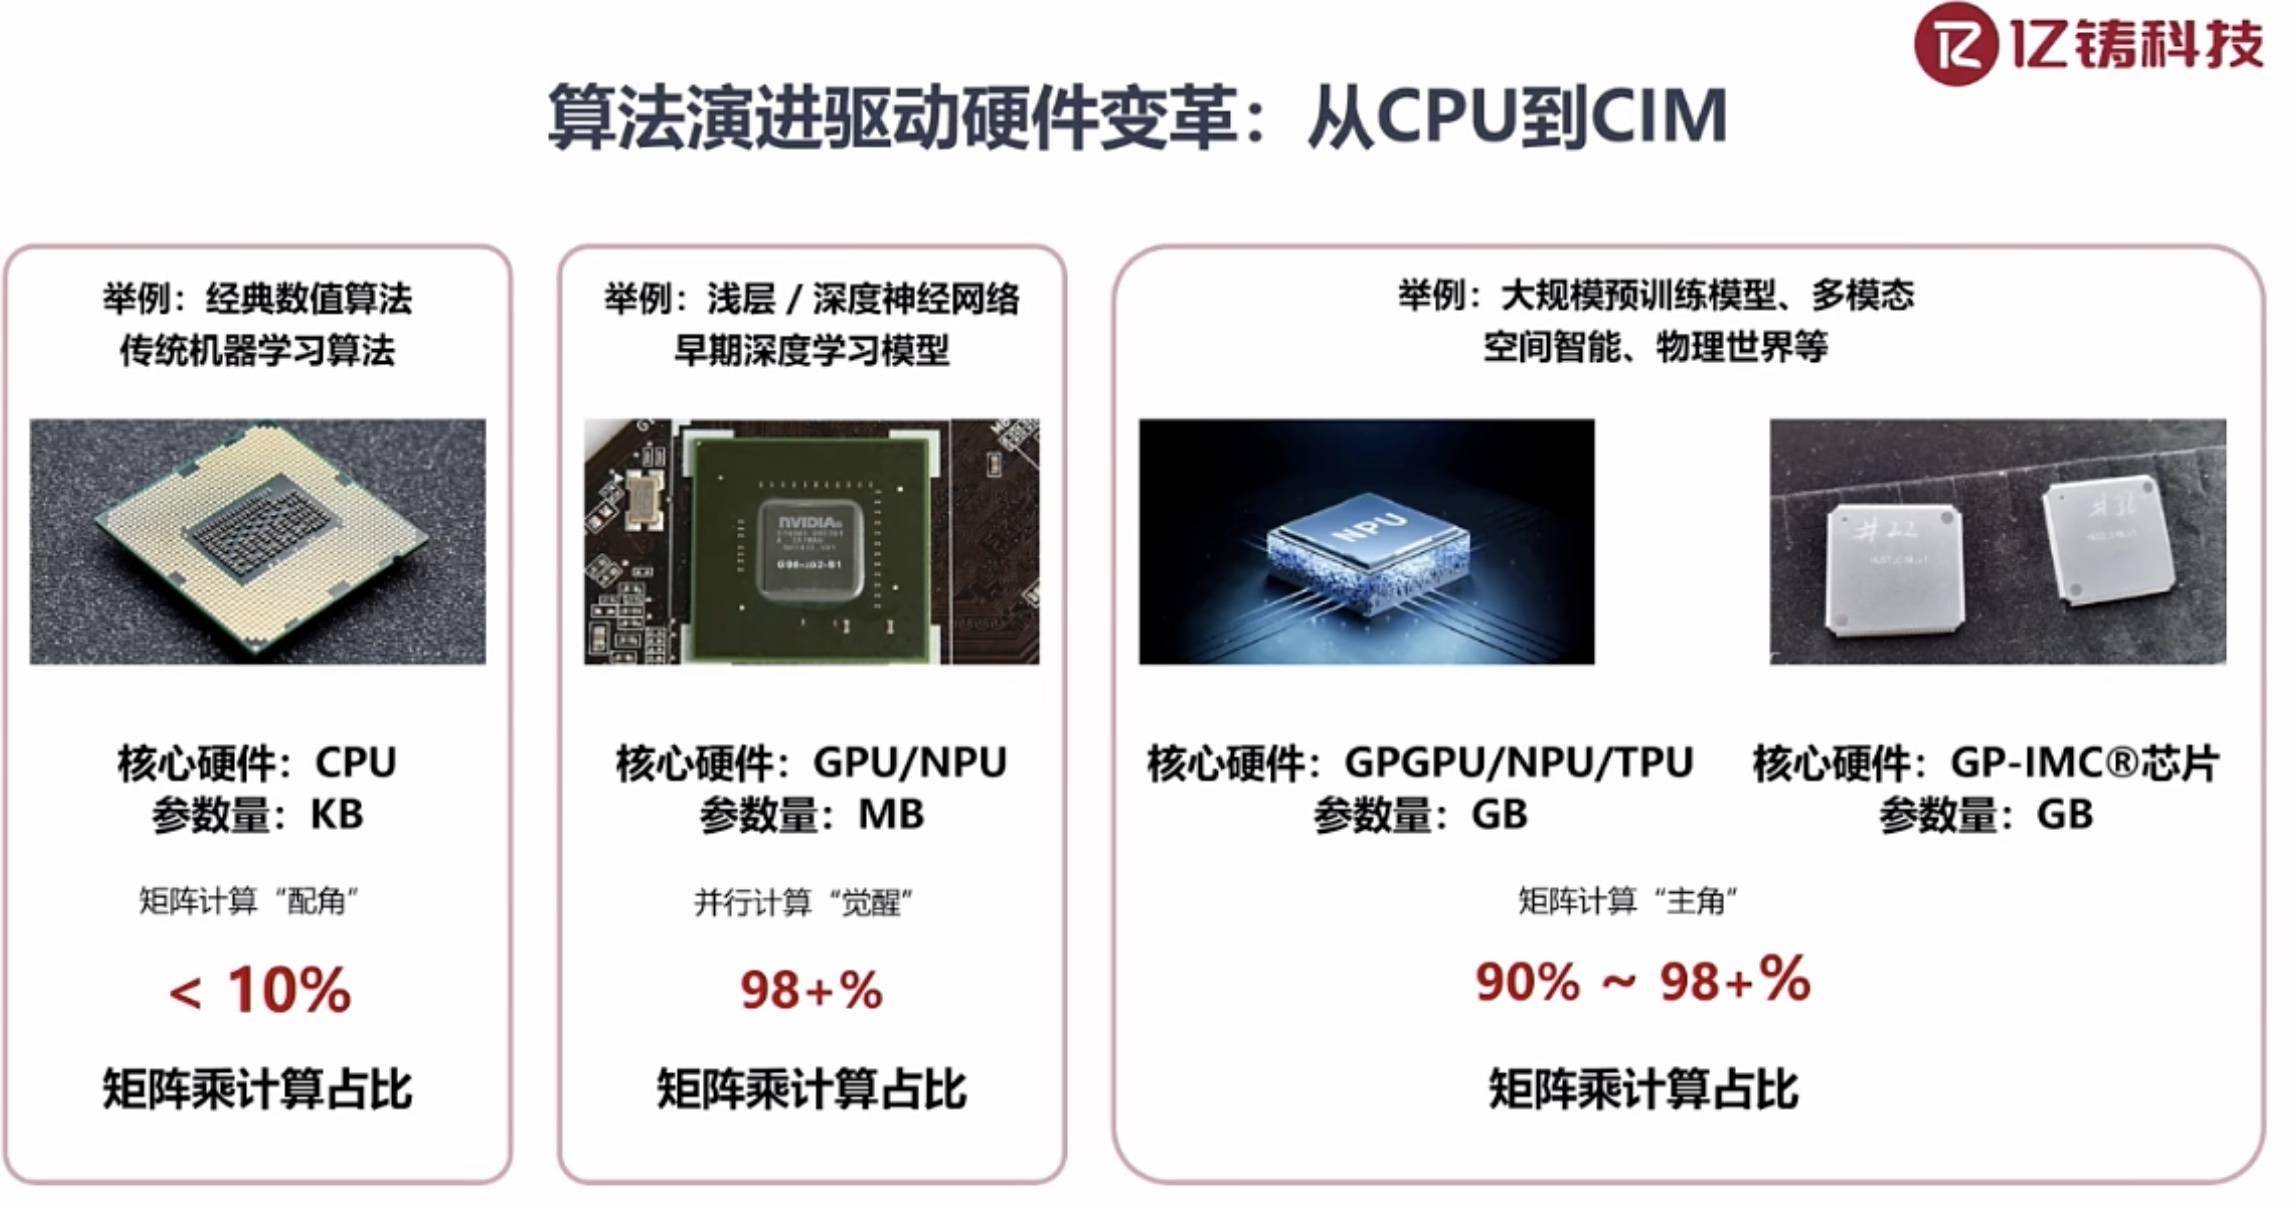
但无论是芯片工艺、片间互联还是系统级调优,本质都只解决一件事,就是提升数据搬运效率,以此拉高系统Token吞吐。CPU、GPU、NPU均存在大量多层次的数据搬运,由此形成存储墙。存储墙分为外存储墙与内存储墙,后者常被行业忽略。
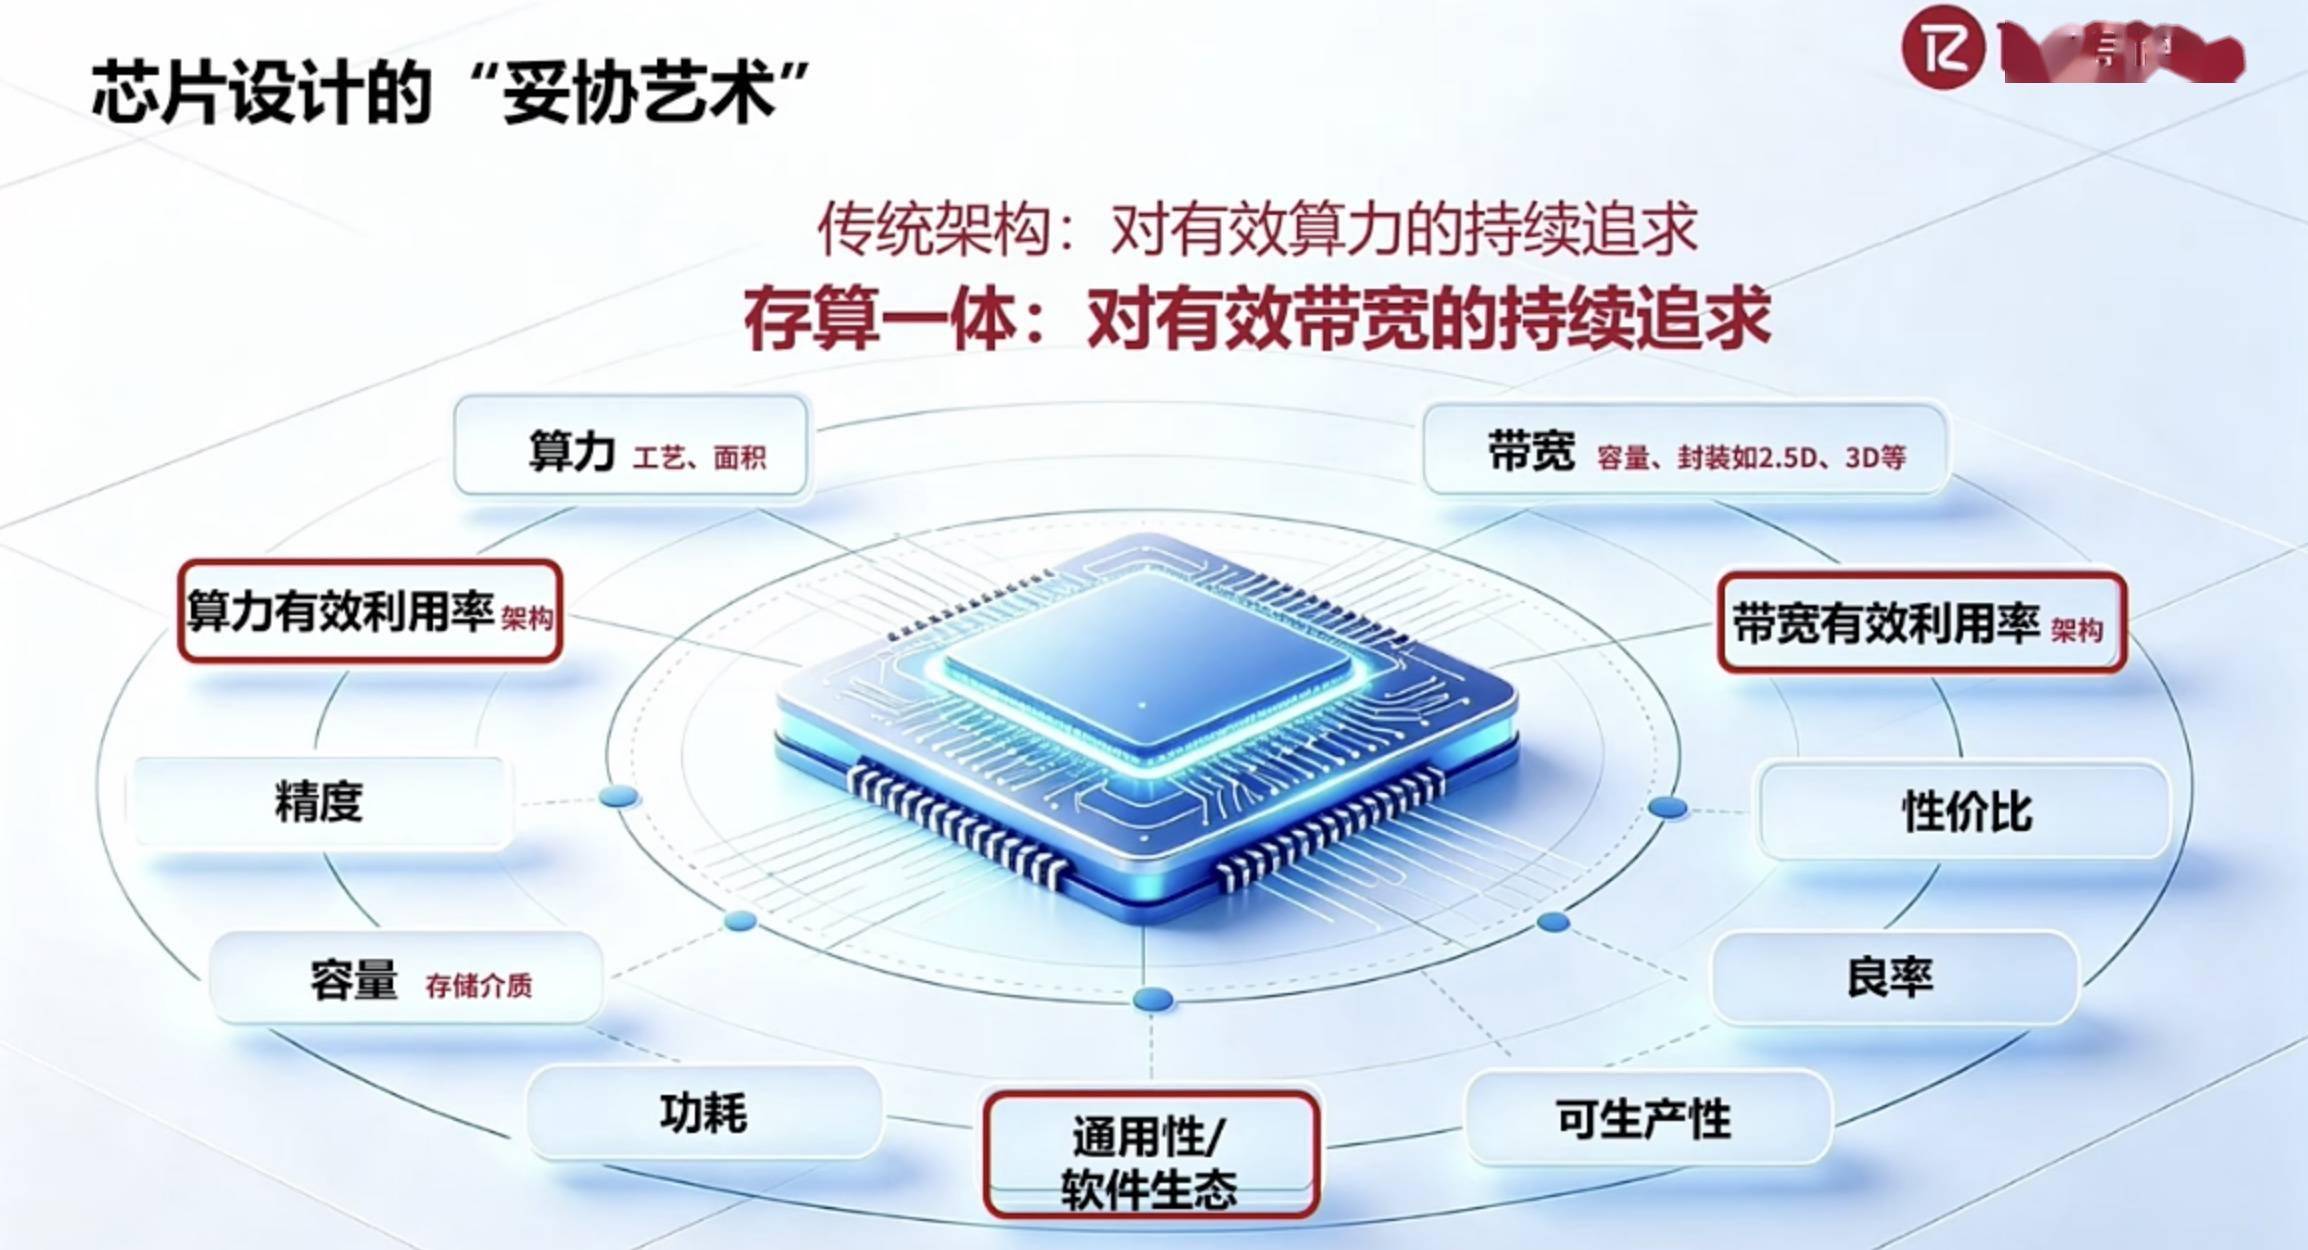
打破内存储墙的核心方案正是存算一体。传统芯片架构以计算为中心,设计目标是最大化有效算力,通过缓存命中率优化等各类技术手段,保障计算单元的利用效率。而存算一体架构以有效带宽为核心目标,无论采用SRAM、DRAM或是3D DRAM,均基于存储介质本身的带宽、功耗特性,配套增加计算逻辑单元,充分发挥存储资源的能力。
落地存算一体,需要实现有效带宽与有效算力的平衡。与此同时,通用性与软件生态至关重要,若缺少通用能力与完善生态,硬件性能再强也无法落地应用。
三、通用存算一体三大核心定律:厘清架构设计、场景部署与异构融合路径
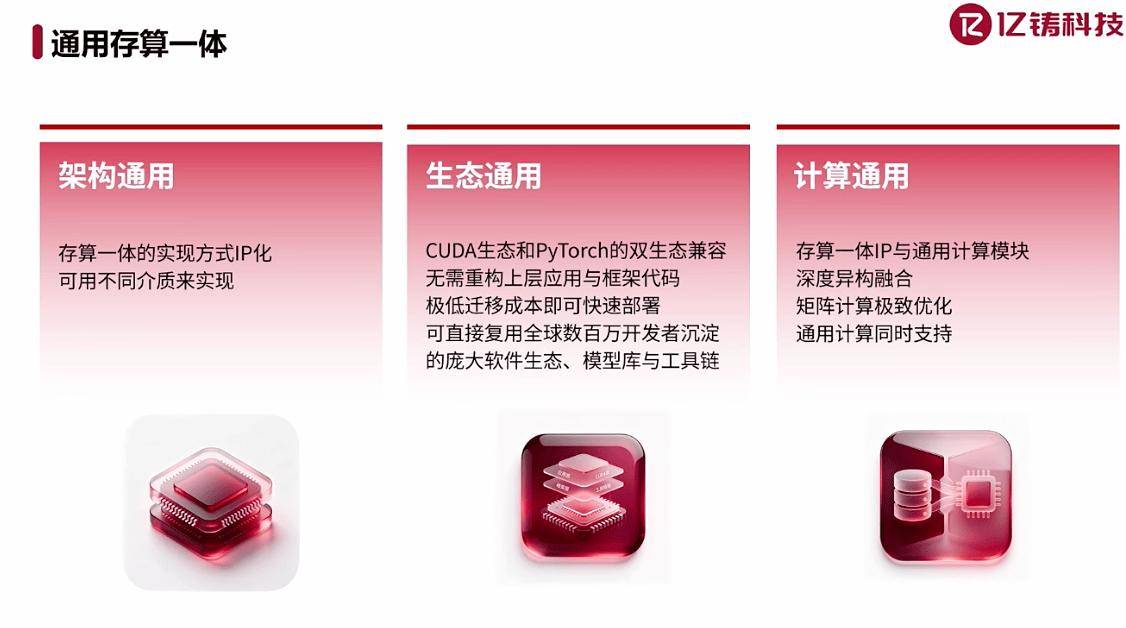
我们梳理了十余年来以英伟达为主线,涵盖AMD、英特尔及国内厂商的AI芯片发展脉络,在此基础上,通用存算一体需要满足三大核心要素:架构通用、生态通用、计算通用。
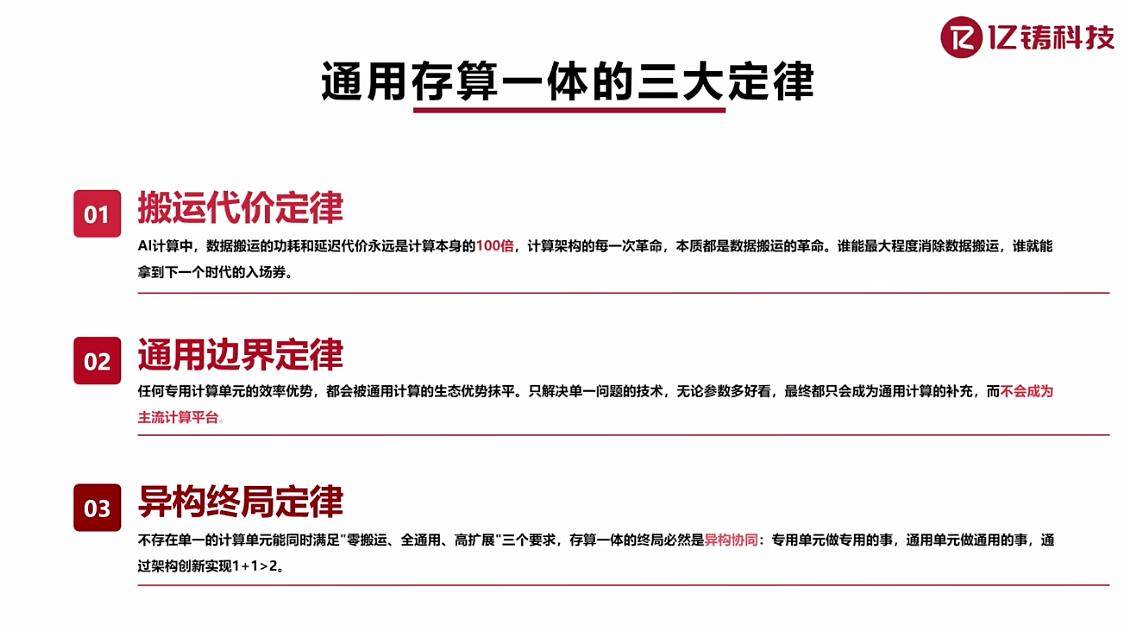
我们提出通用存算一体三大定律。第一为搬运代价定律:AI计算中,数据搬运产生的功耗与延时,可达计算本身的数十至上百倍。
第二是通用边界定律:无论何种计算架构,若缺少通用性与生态兼容能力,在持续迭代的新模型、世界模型、物理模型面前,发展空间将受到极大限制。
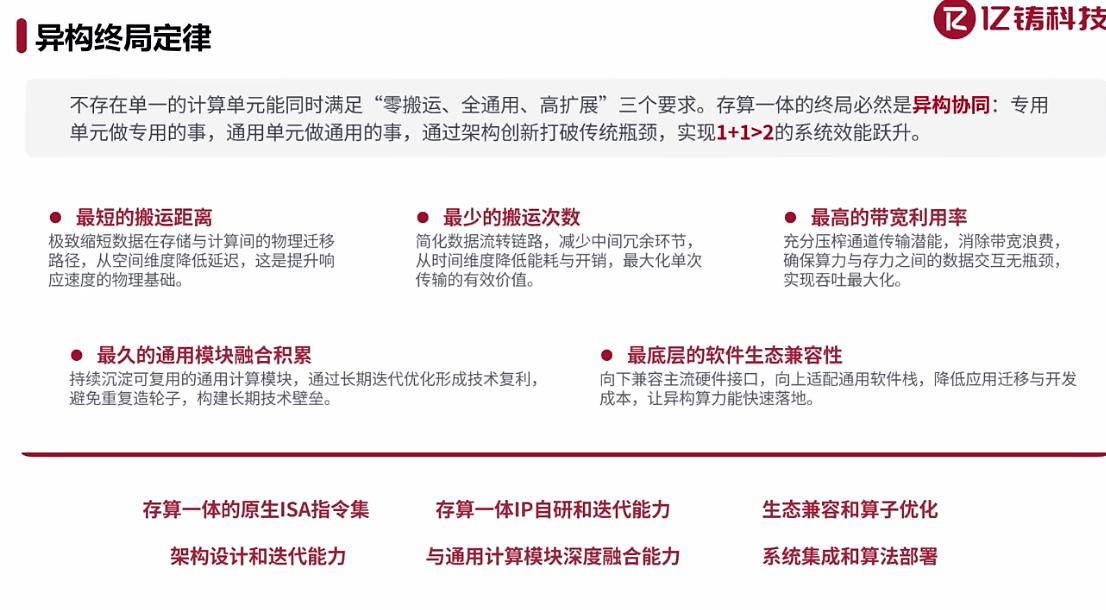
第三为异构终局定律,我们在2023至2024年提出超异构理念。存算一体擅长矩阵计算,但要实现通用计算,还需要具备类似GPU的使用体验。GPU是以计算为中心的架构,而存算一体以存储为中心,二者底层设计逻辑截然不同。将两种架构高效融合,是巨大的技术挑战;融合效果的优劣,将直接决定存算一体芯片的成败。
近存与存算一体是两类不同思路。HBM4.0以及未来HBM5.0属于近存方案,主要用于攻克外存储墙,解决数据向芯片内部传输时带宽不足、搬运距离过长带来的高功耗问题,H200、B300均采用这种路线。而存算一体的目标是最大限度缩短数据搬运距离,将搬运次数趋近于零,以此实现芯片功耗降低至几十分之一至几分之一。

通用边界定律重点指向CUDA生态兼容。想要实现CUDA生态适配,需要满足两项条件:一是功能层面完整覆盖通用GPU的全部能力,同时维持较高运行效率;二是兼容包含CUDA在内的现有主流软件生态。

异构融合是存算一体落地的关键。存算一体与通用GPU的底层架构原理截然不同,实现两套架构协同运行、任务快速切换,是存算一体芯片走向成功的核心要素。
在大模型解码场景,尤其是长文本任务下,H100、H200的算力利用率甚至不足10%。长文本场景中单用户TPS很难突破80,该瓶颈根源就是内存储墙。存算一体的核心价值,正是突破内存储墙限制。因此,我们提出了存算一体超异构理念,并已完成技术验证芯片开发。
结语:商用芯片测试指标达标,对比H200吞吐翻倍、TCO大幅降低
基于这套技术思路,我们的商用芯片目前各项测试结果基本达到预设设计指标与技术理念。
FPGA仿真平台数据显示,对比英伟达H200,这套方案吞吐率提升至2倍,功耗仅为后者的几分之一;成本伴随吞吐、功耗优化实现数倍改善。放到Token工厂、Token经济场景测算,存算一体方案相比传统架构,TCO(总拥有成本)可缩减至约1/6。
在Agent等以存储为核心的应用场景,存算一体具备显著优势;面对大模型,特别是长文本大模型,存算一体拥有天然技术优势。针对100万token上下文长文本场景,庞大的KV cache处理需求,正是存算一体的强项。
此外,在PD分离架构下执行解码任务时,存算一体的性能优势会进一步放大。该通用芯片可同时支持预训练与解码任务。依托自研芯片,我们将推出多样化产品形态,涵盖板卡、算力卡、微型工作站、一体机以及超节点产品。
以上是熊大鹏演讲内容的完整整理。