设备掉线真凶不是路由器
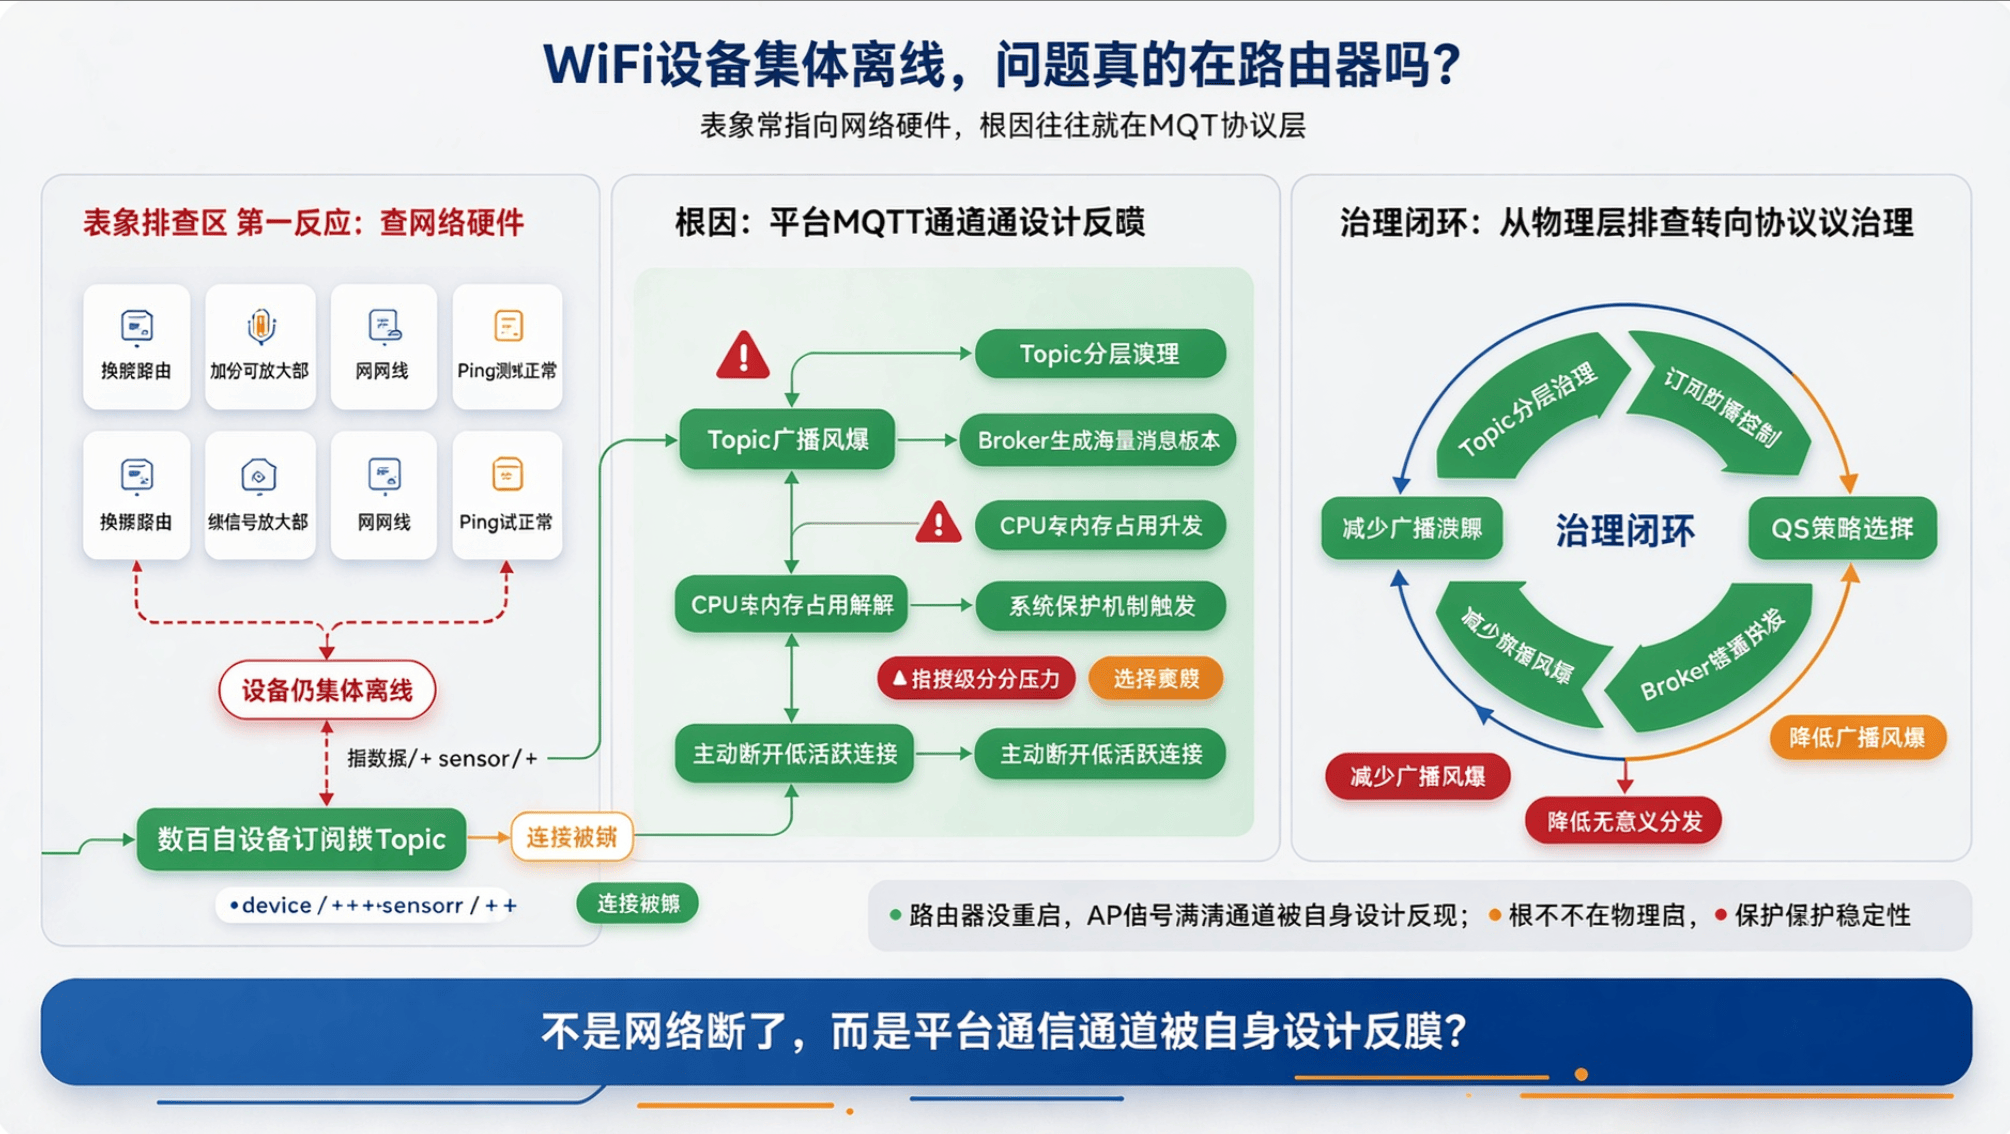
WiFi设备集体离线,第一反应往往是换路由器、加信号放大器、查网线——但真相常被表象掩盖。大量现场案例表明,当数十甚至上百台设备在同一时段突然失联,问题极少出在网络硬件本身,而更可能源于平台侧MQTT通信层的设计缺陷。
真正触发连锁掉线的‘导火索’,往往是Topic广播风暴与QoS配置失当。例如,当数百台设备同时订阅泛化Topic(如device/+/sensor/+),Broker需为每条发布消息生成海量副本,并逐一分发至所有匹配客户端。这种指数级分发压力会迅速推高Broker CPU与内存占用,最终触发系统保护机制——主动断开低活跃连接以维持核心服务可用性。
这解释了为何‘路由器没重启、AP信号满格、Ping测试正常’,设备却集体离线:不是网络断了,而是平台通信通道被自身设计反噬。根因不在物理层,而在MQTT协议层的Topic治理与QoS策略选择。
Topic设计不当如何引发广播风暴
Topic本质是MQTT中的消息路由地址,其设计直接决定Broker的负载模型。问题常始于‘便利优先’的开发习惯:用device/+/status替代device/{id}/status,看似省事,实则埋下爆炸隐患。
通配符+(单层匹配)与#(多层递归)虽提升开发灵活性,但会显著扩大消息路由范围。当设备A向device/101/status发布状态,所有订阅device/+/status的设备都会收到;若该Topic被200台设备订阅,一次发布即产生200次分发。若再叠加多个泛化Topic(如device/+/alarm、device/+/config),流量呈几何倍增。
更严峻的是系统Topic与业务Topic混用。设备上下线通知(如$SYS/broker/clients/connected)本应由平台内部消费,若业务端也订阅同类泛化路径,将引入大量非必要流量。这种‘订阅关系失控’与‘Topic结构发散’的双重作用,正是广播风暴的核心成因。
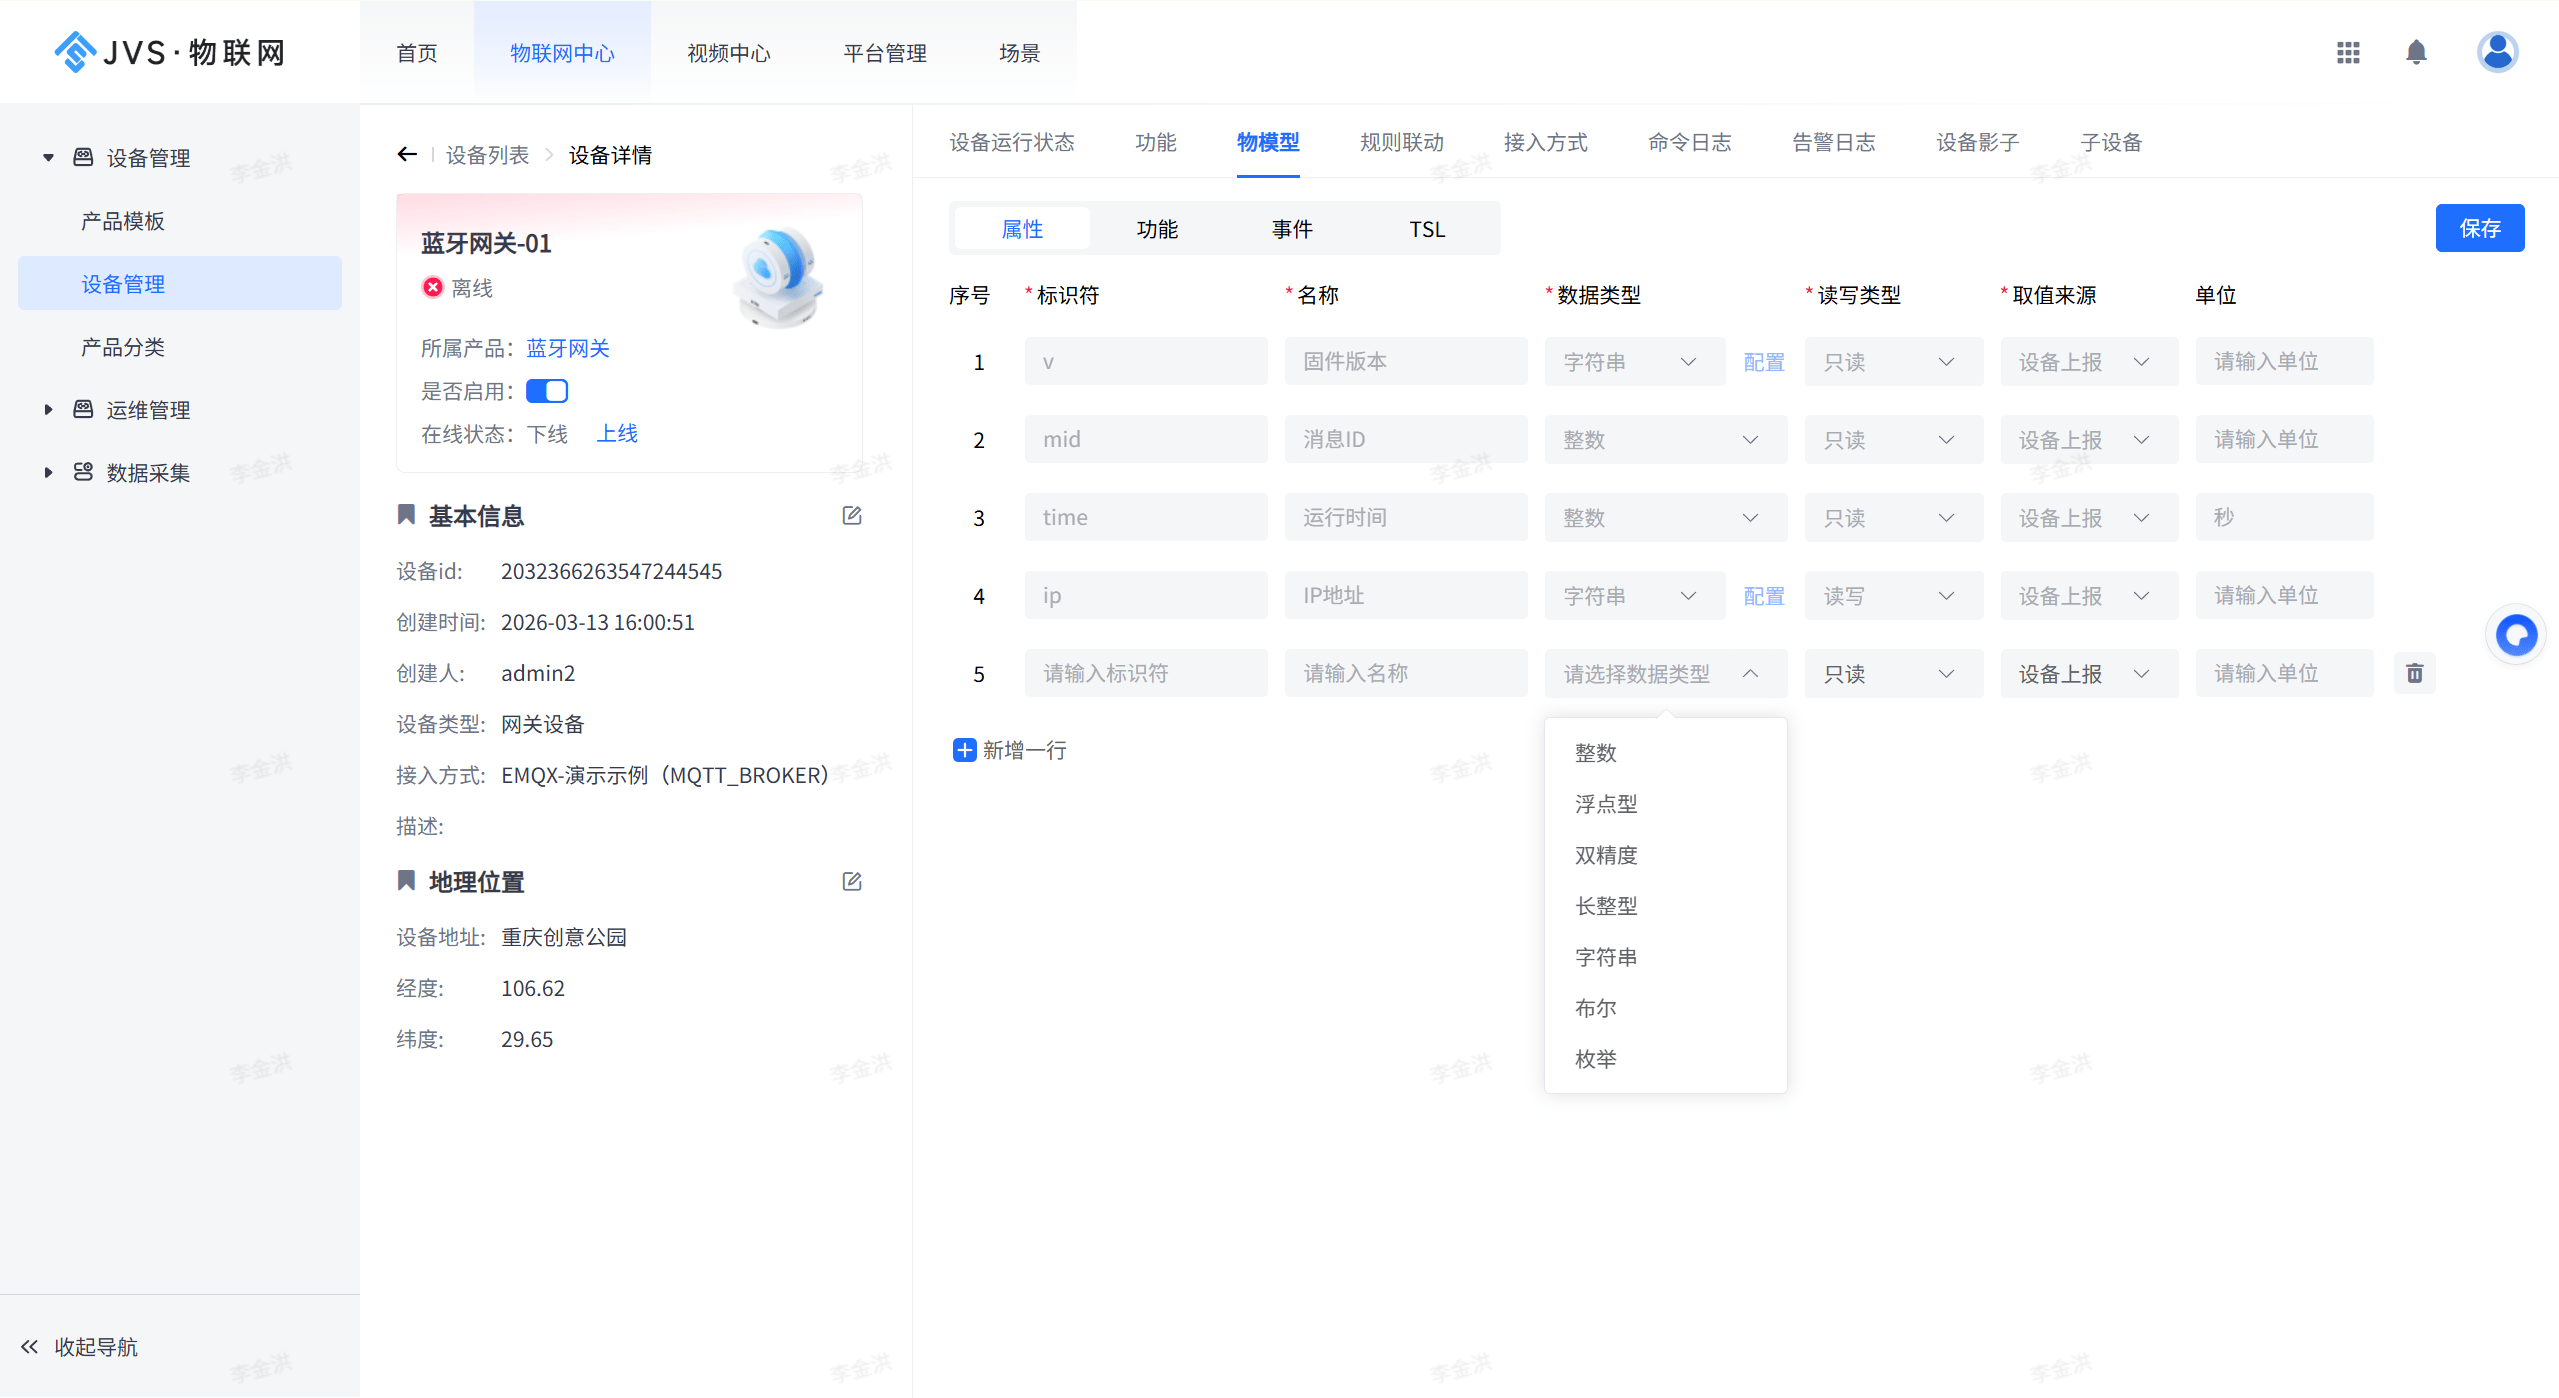
QoS配置陷阱:为何QoS=2在WiFi环境更危险
QoS等级并非越高越好,其适用性高度依赖网络稳定性。QoS=0(最多一次)适用于温湿度上报等容忍偶发丢包的场景;QoS=1(至少一次)通过PUBACK确认平衡可靠性与开销;而QoS=2(恰好一次)虽保障不重不漏,却需四步握手、本地消息持久化及重传队列管理。
在WiFi环境中,信号波动、漫游切换、干扰频发是常态。一旦链路短暂中断,QoS=2设备将持续重发PUBREC/PUBREL报文,未确认消息在本地与Broker两端不断堆积。此时,Broker内存被重传队列挤占,新连接建立延迟,心跳包响应超时,最终触发批量设备被标记为‘离线’。
这不是设备故障,而是QoS=2在弱网下的‘反向挤压效应’:为保一条消息可靠,牺牲了整体连接健康度。因此,QoS必须按数据价值分级选用——控制指令可选QoS=1,常规状态上报推荐QoS=0,仅固件升级、关键事务等不可逆操作才启用QoS=2。
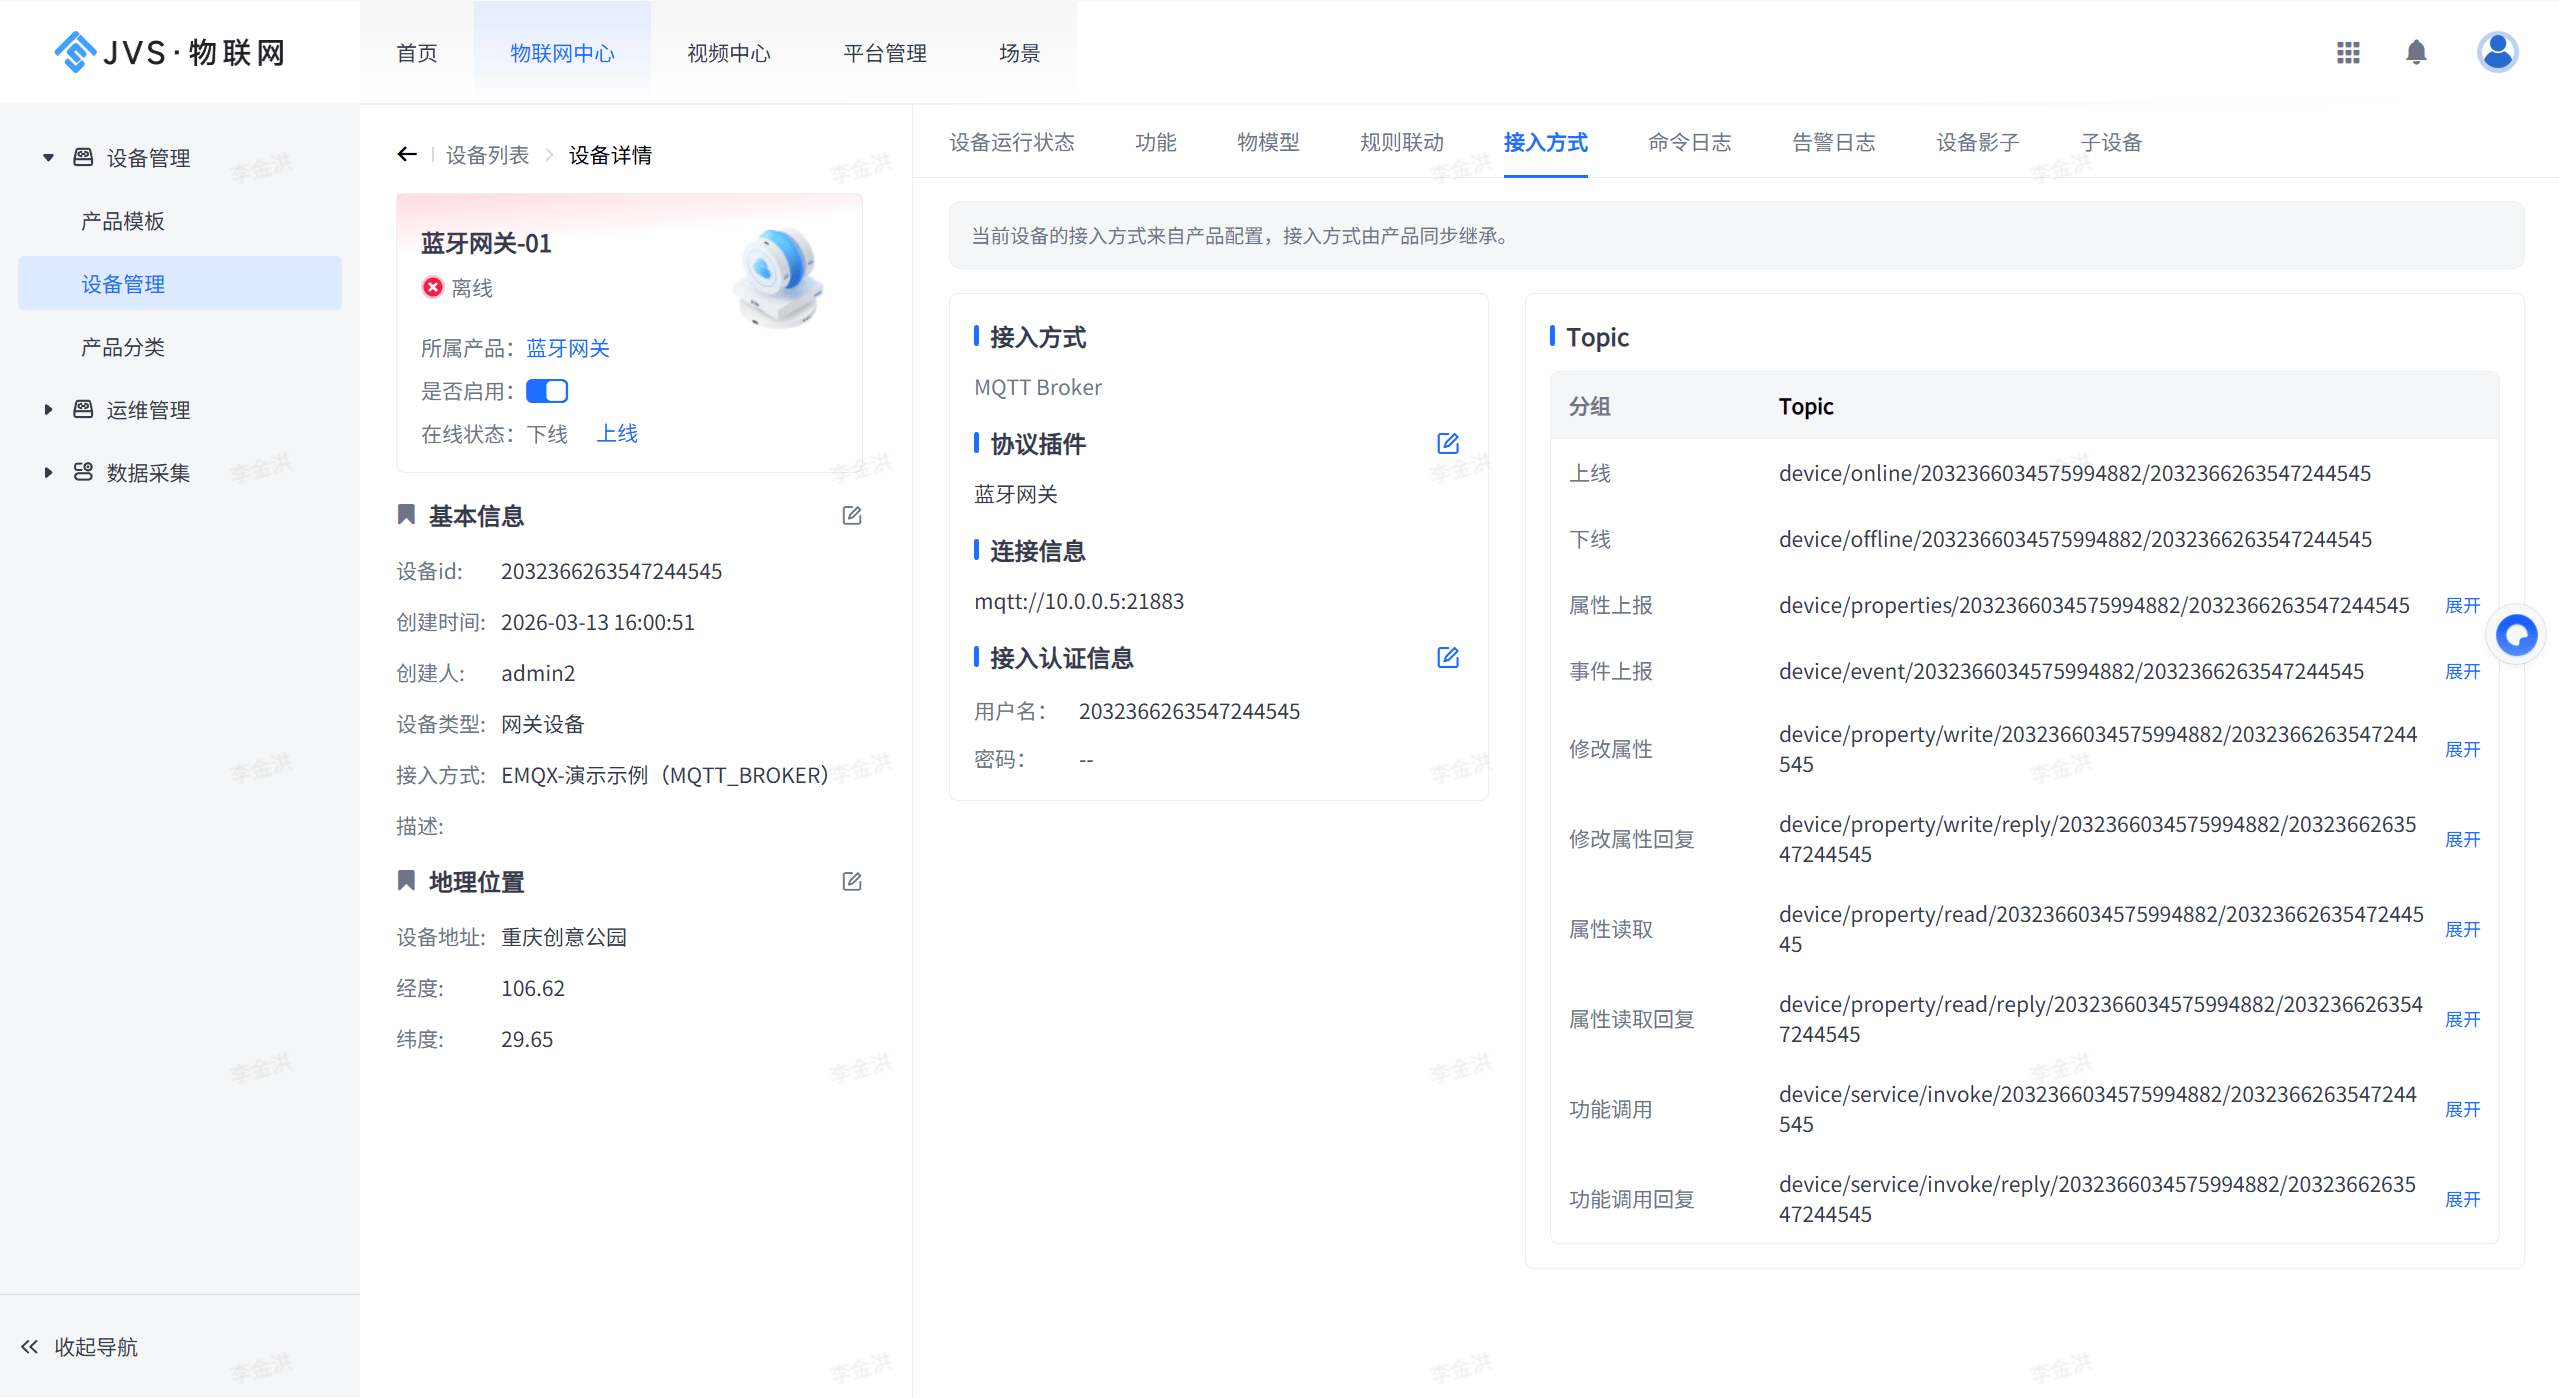
四步构建健壮的Topic与QoS体系
要从根源阻断广播风暴与QoS反噬,需建立可落地的四步治理体系:
- 命名收敛:强制采用层级化、实例化Topic结构,如device/{product}/{sn}/telemetry,禁用跨层级通配符(如device/#/cmd);
- 订阅隔离:按角色(运维/产线/管理员)、权限组或业务域划分Topic空间,杜绝‘全设备监听’式订阅;
- QoS分级:制定明确映射策略,例如告警事件→QoS=1,设备心跳→QoS=0,固件升级→QoS=2,并在物模型配置中固化;
- 压测验证:利用JVS-IOT平台内置的Broker资源监控能力,配合MQTT.fx等工具模拟百级设备连接,对比不同Topic粒度与QoS组合下的CPU占用率、连接存活率及端到端消息延迟。
这套体系不依赖硬件升级,只需配置优化与流程规范,即可显著提升高并发设备在线稳定性。如需进一步评估当前Topic与QoS配置合理性,建议结合实际环境开展轻量级压测验证。