一次工艺变更事故暴露四大断点
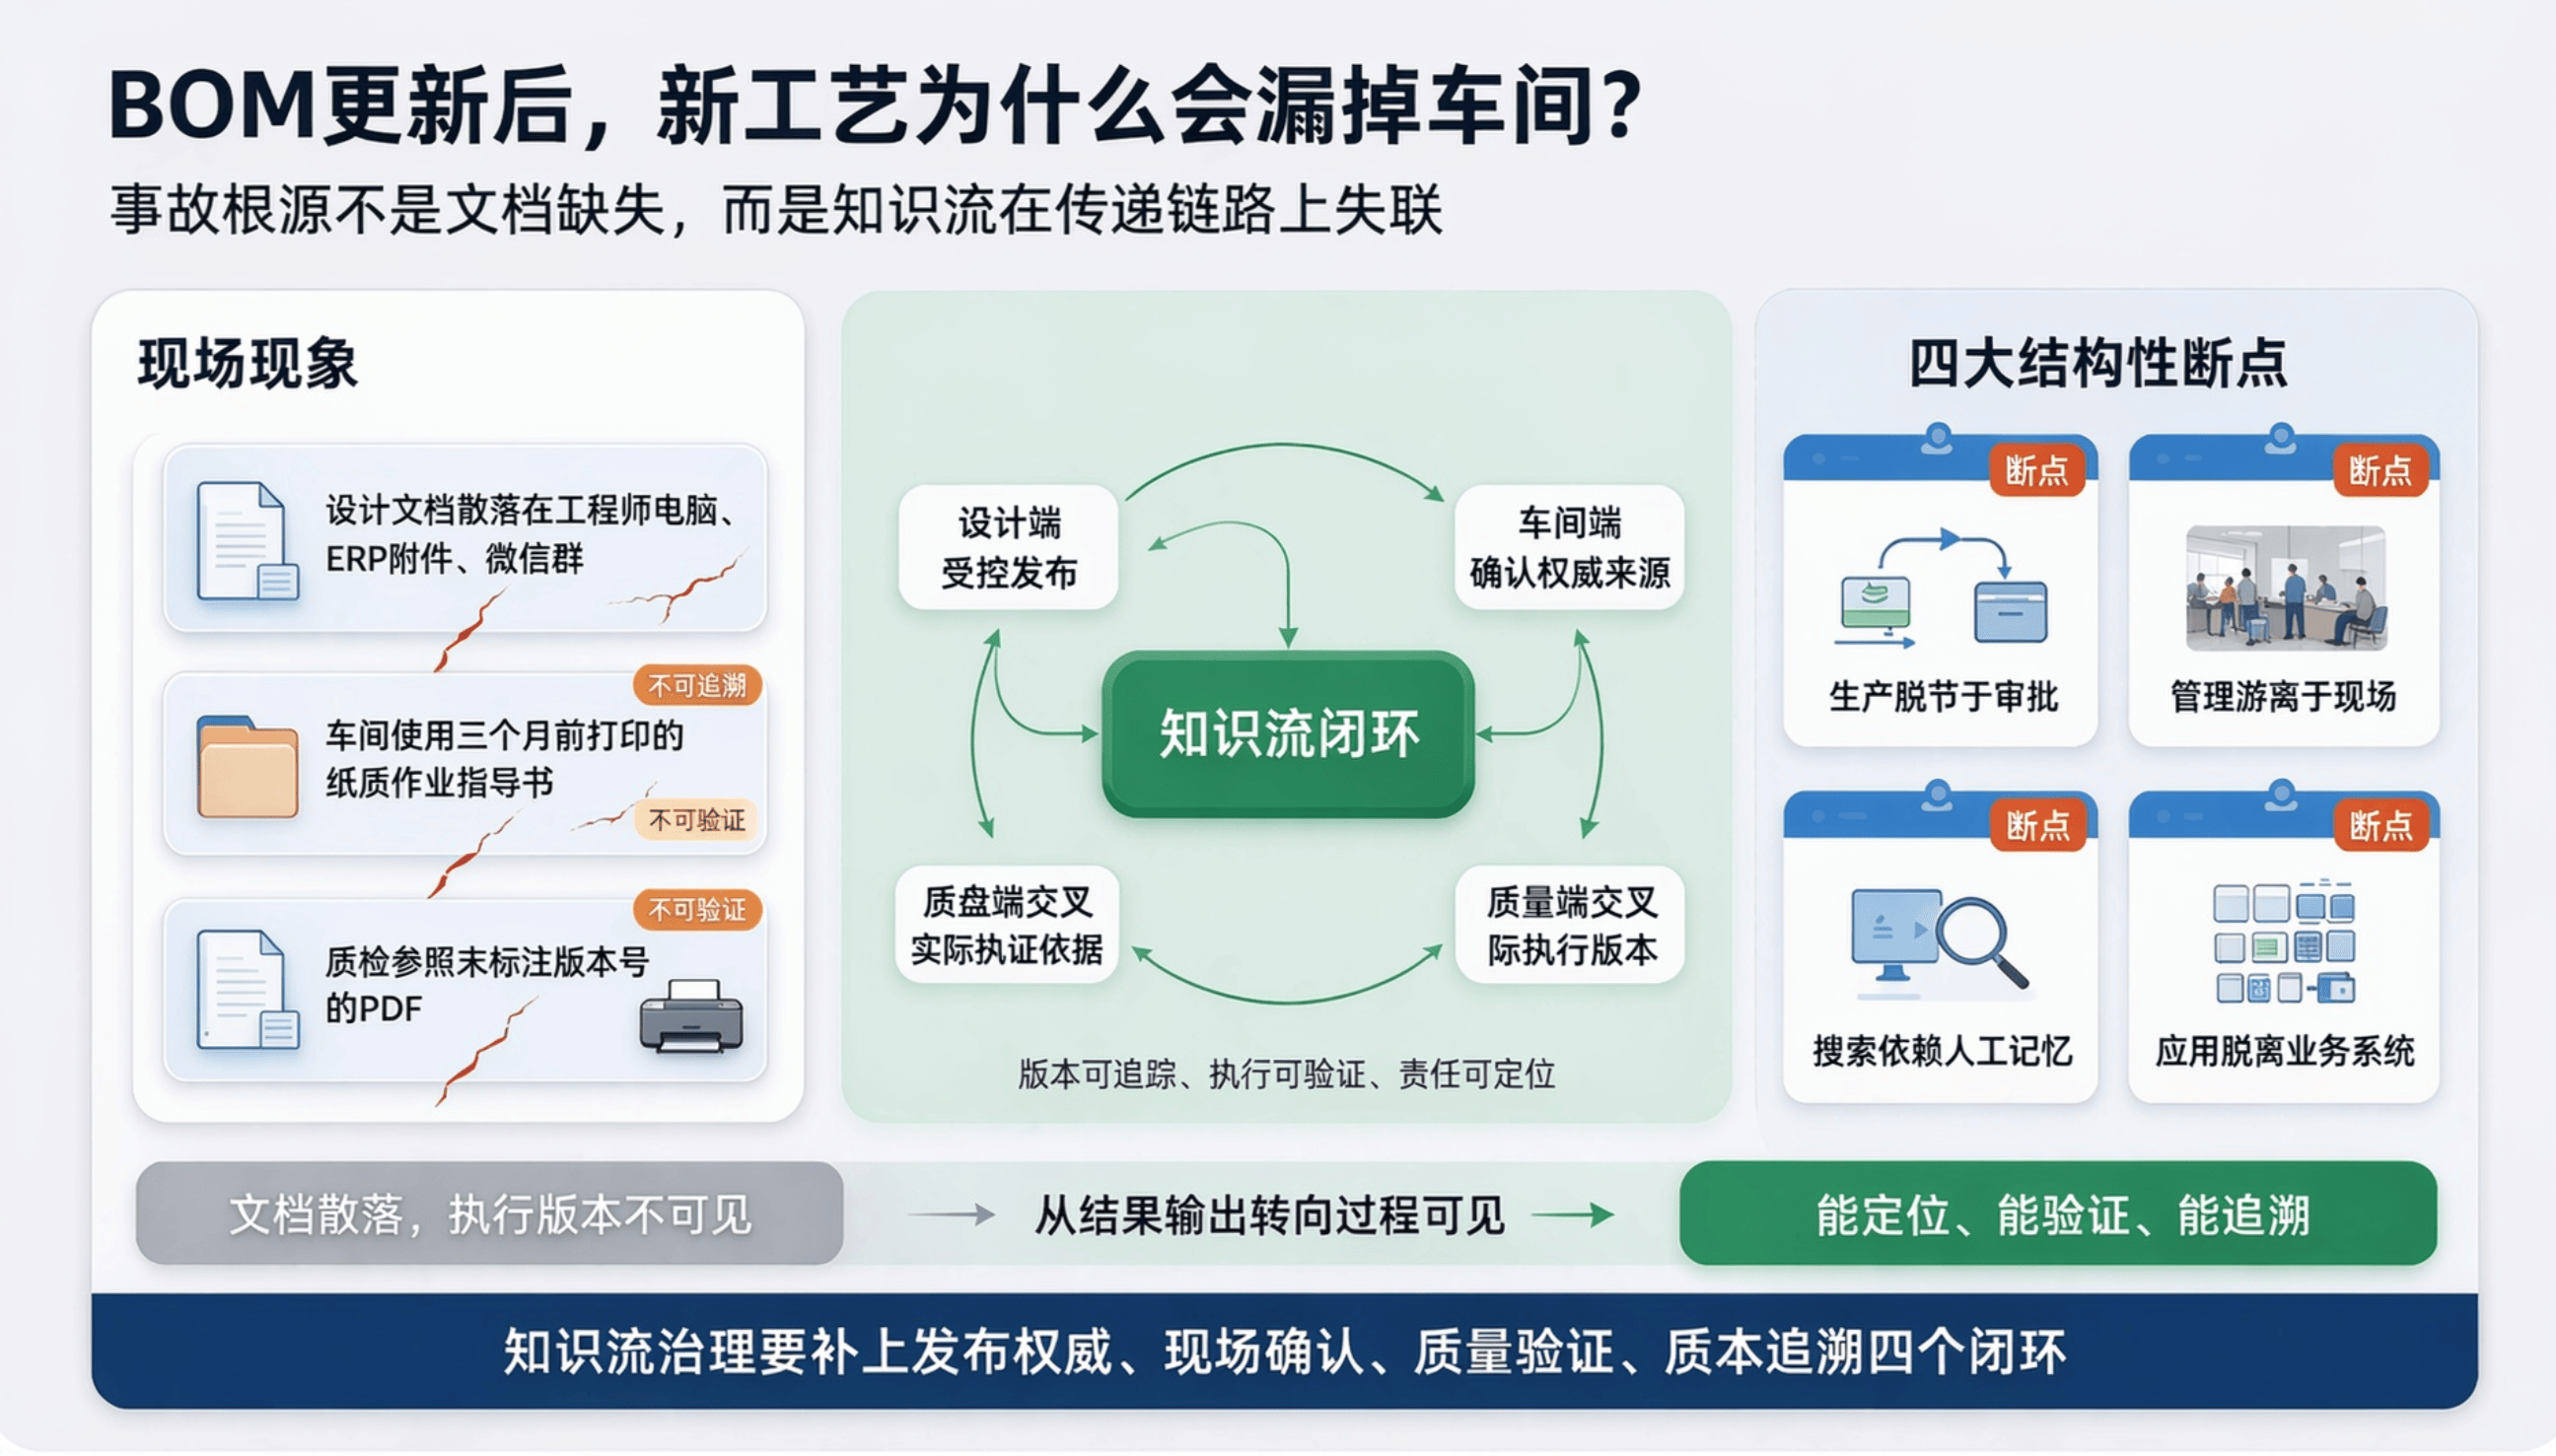
某制造企业在BOM更新后,因新工艺未同步至车间,导致数十台核心设备装配错误、整批返工。复盘发现:设计文档散落在工程师个人电脑、ERP附件及项目微信群;车间使用三个月前打印的纸质作业指导书;质量检验参照一份未标注版本号的PDF——三份‘最新版’并存,却均不可追溯、不可验证。
事故根源并非文档缺失,而是知识在传递链路上彻底失联:设计端产出无法受控发布,车间端无法确认权威来源,质量端无法交叉验证依据,复盘端无法定位实际执行版本。这暴露了知识流的四大结构性断点:
- 生产脱节于审批
- 管理游离于现场
- 搜索依赖人工记忆
- 应用脱离业务系统
为什么知识在制造业容易‘静默死亡’
制造业知识的‘静默死亡’,源于其业务逻辑与知识形态的深层错配。
工艺文件天然具有多源性——技术部输出初稿、MES承载执行参数、车间留存纸质操作卡、微信群转发临时变更,但缺乏统一受控入口,使文件沦为‘流动资产’而非‘可信资产’。
质检标准、设备维修经验等强时效性内容,难以靠静态PDF承载:一张模糊的设备故障图谱,远不如带OCR识别能力的交互式手册;一段老师傅口述的异常判据,若未结构化为‘现象-参数-处置’三元组,便无法被新人复用或系统调用。
更关键的是,制造业人员变动高频,而隐性经验(如某类轴承异响与温升的关联阈值)极少转化为可检索、可验证的显性知识。当MES、ERP、OA各自维护附件,同一客户产品的工艺、质检、维修记录便被切割成互不关联的碎片,知识不再是流动的溪流,而成了散落的水洼。
构建知识流水线的四个工程化环节
修复知识流,需将知识管理从‘文档归档’升级为‘流水线工程’,覆盖以下四个刚性环节:
生产环节:支持富文本、流程图、Xmind等多格式在线协作,产品经理、工艺工程师、质检员围绕同一份作业指导书实时编辑、评论、标注变更点,杜绝邮件传附件导致的版本分裂;

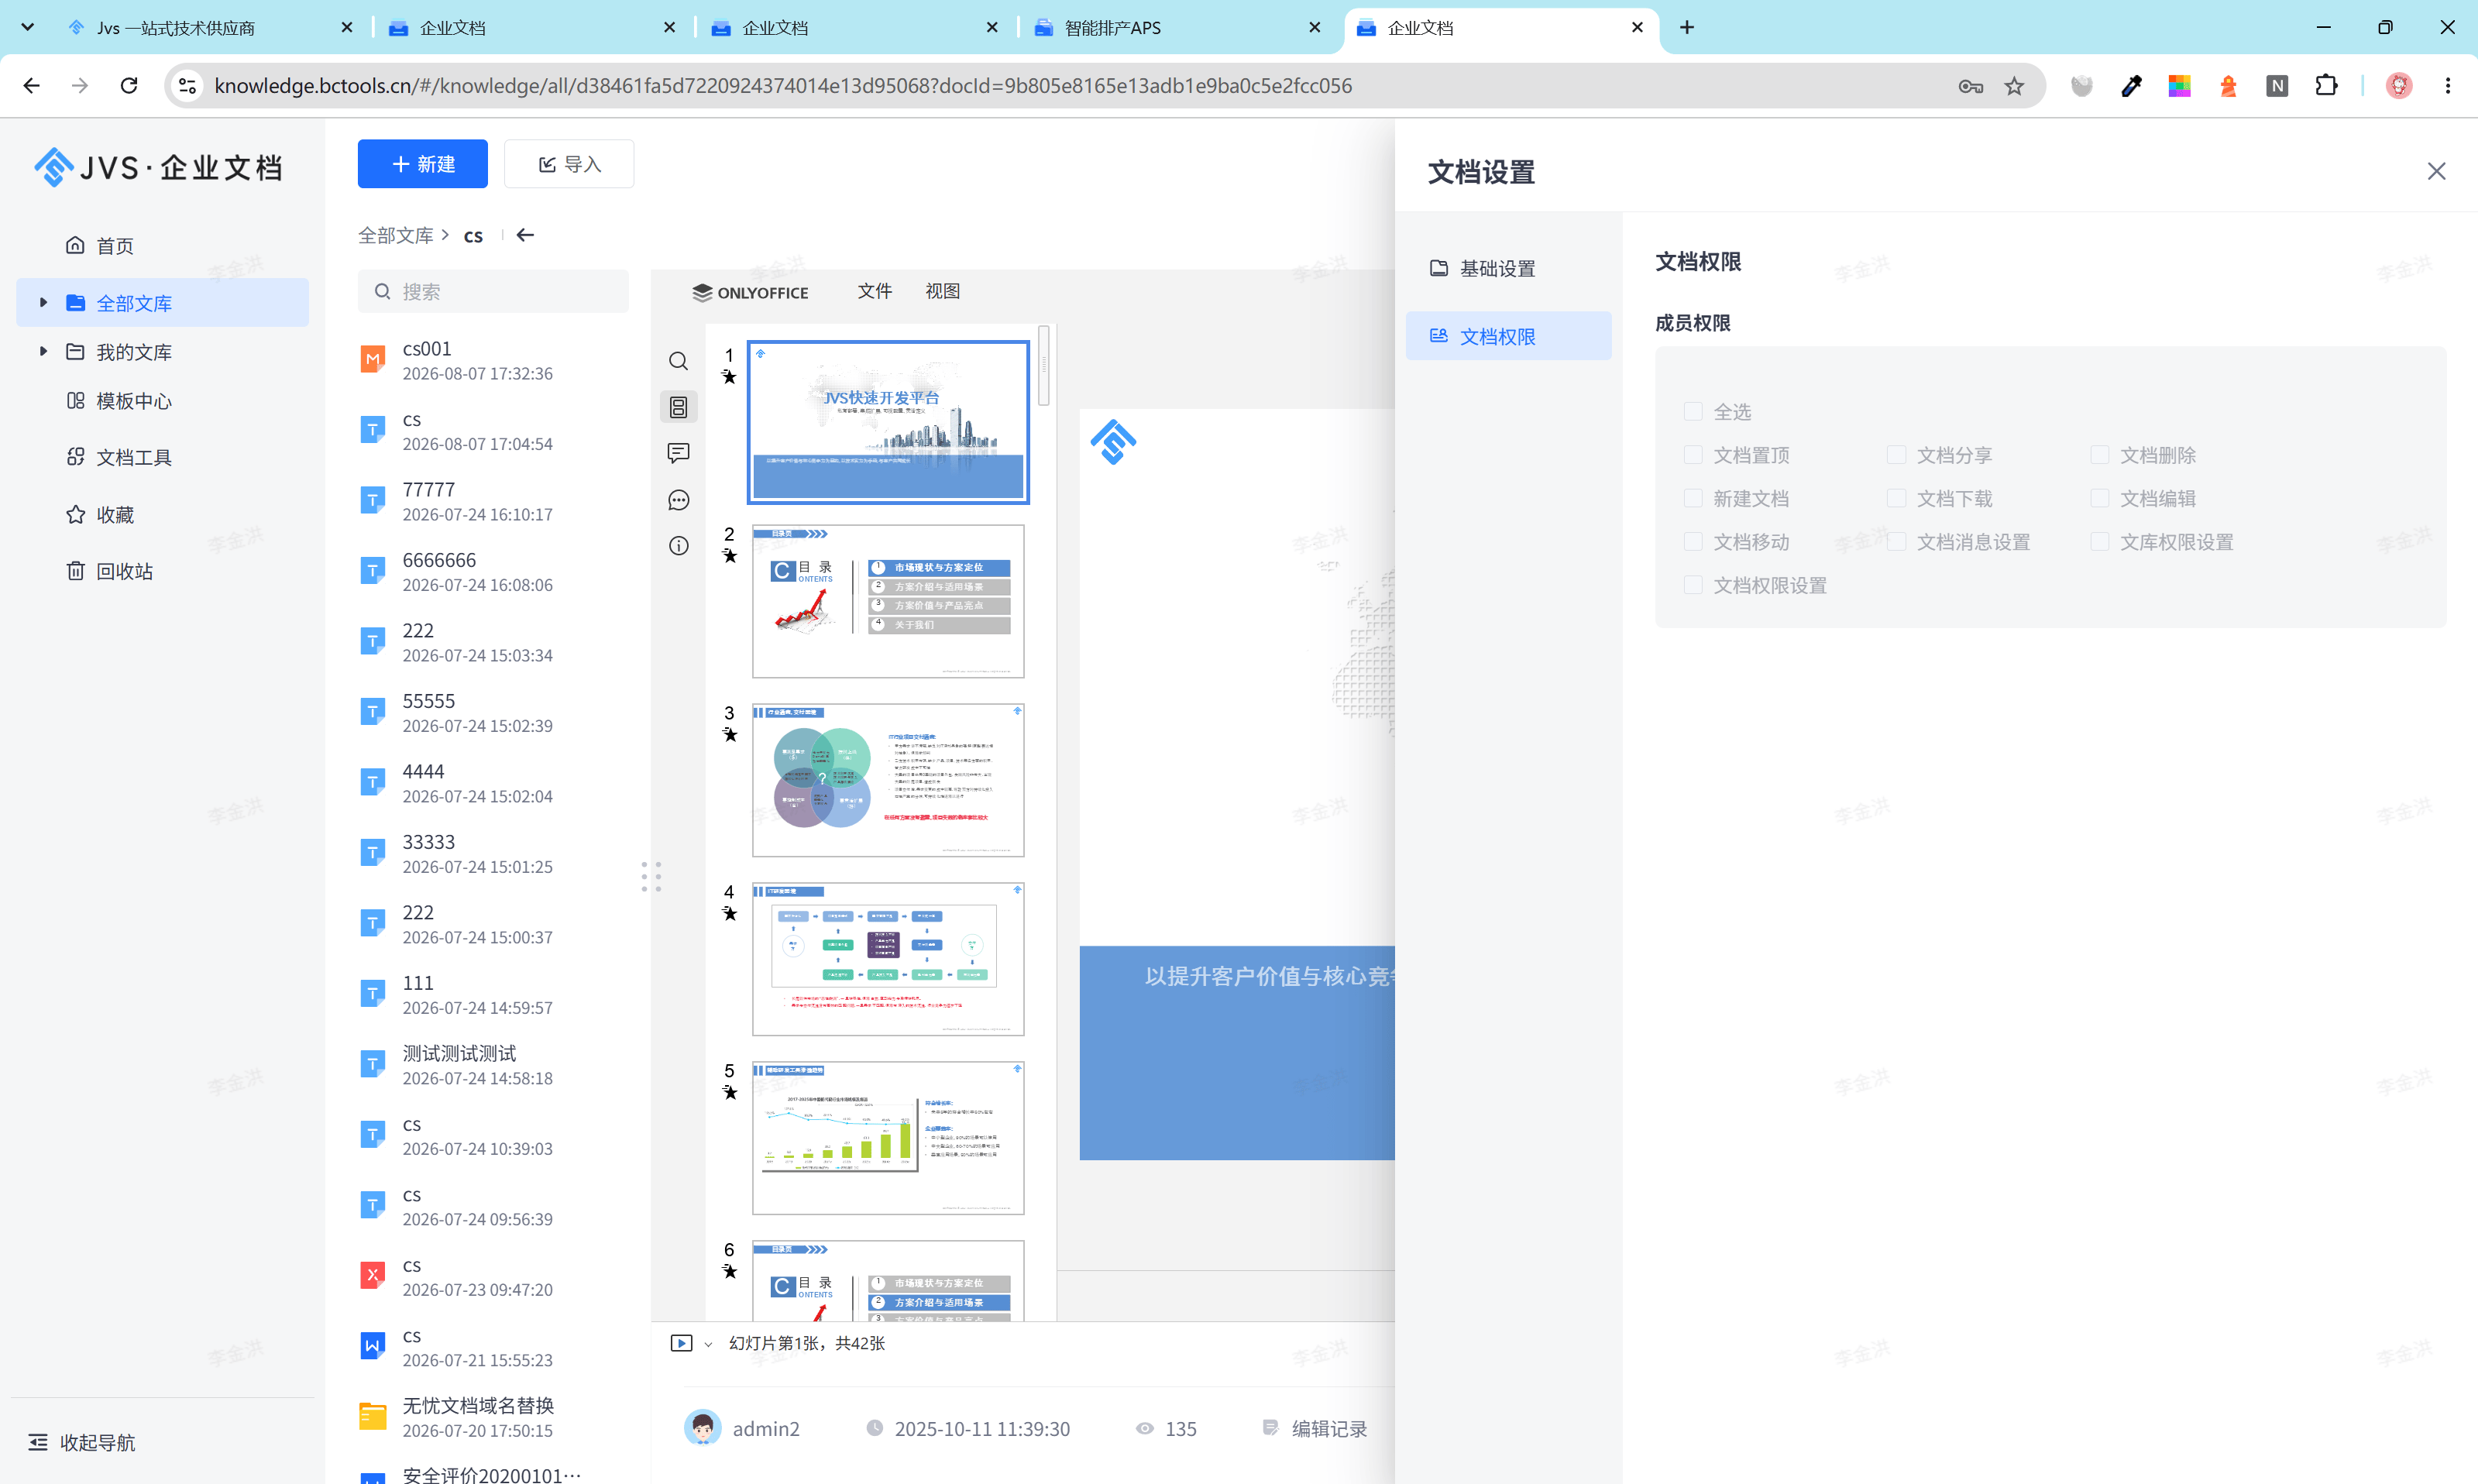
管理环节:按产品线、产线、工序建立工艺文库,实施文件夹级权限控制(如仅允许技术部编辑、车间只读),所有修改强制留痕并关联审批工单;
搜索环节:集成OCR能力,对扫描图纸、PDF检验标准实现文字识别;支持按设备编号、工序名称、故障关键词(如‘主轴过热’)跨文库精准定位;
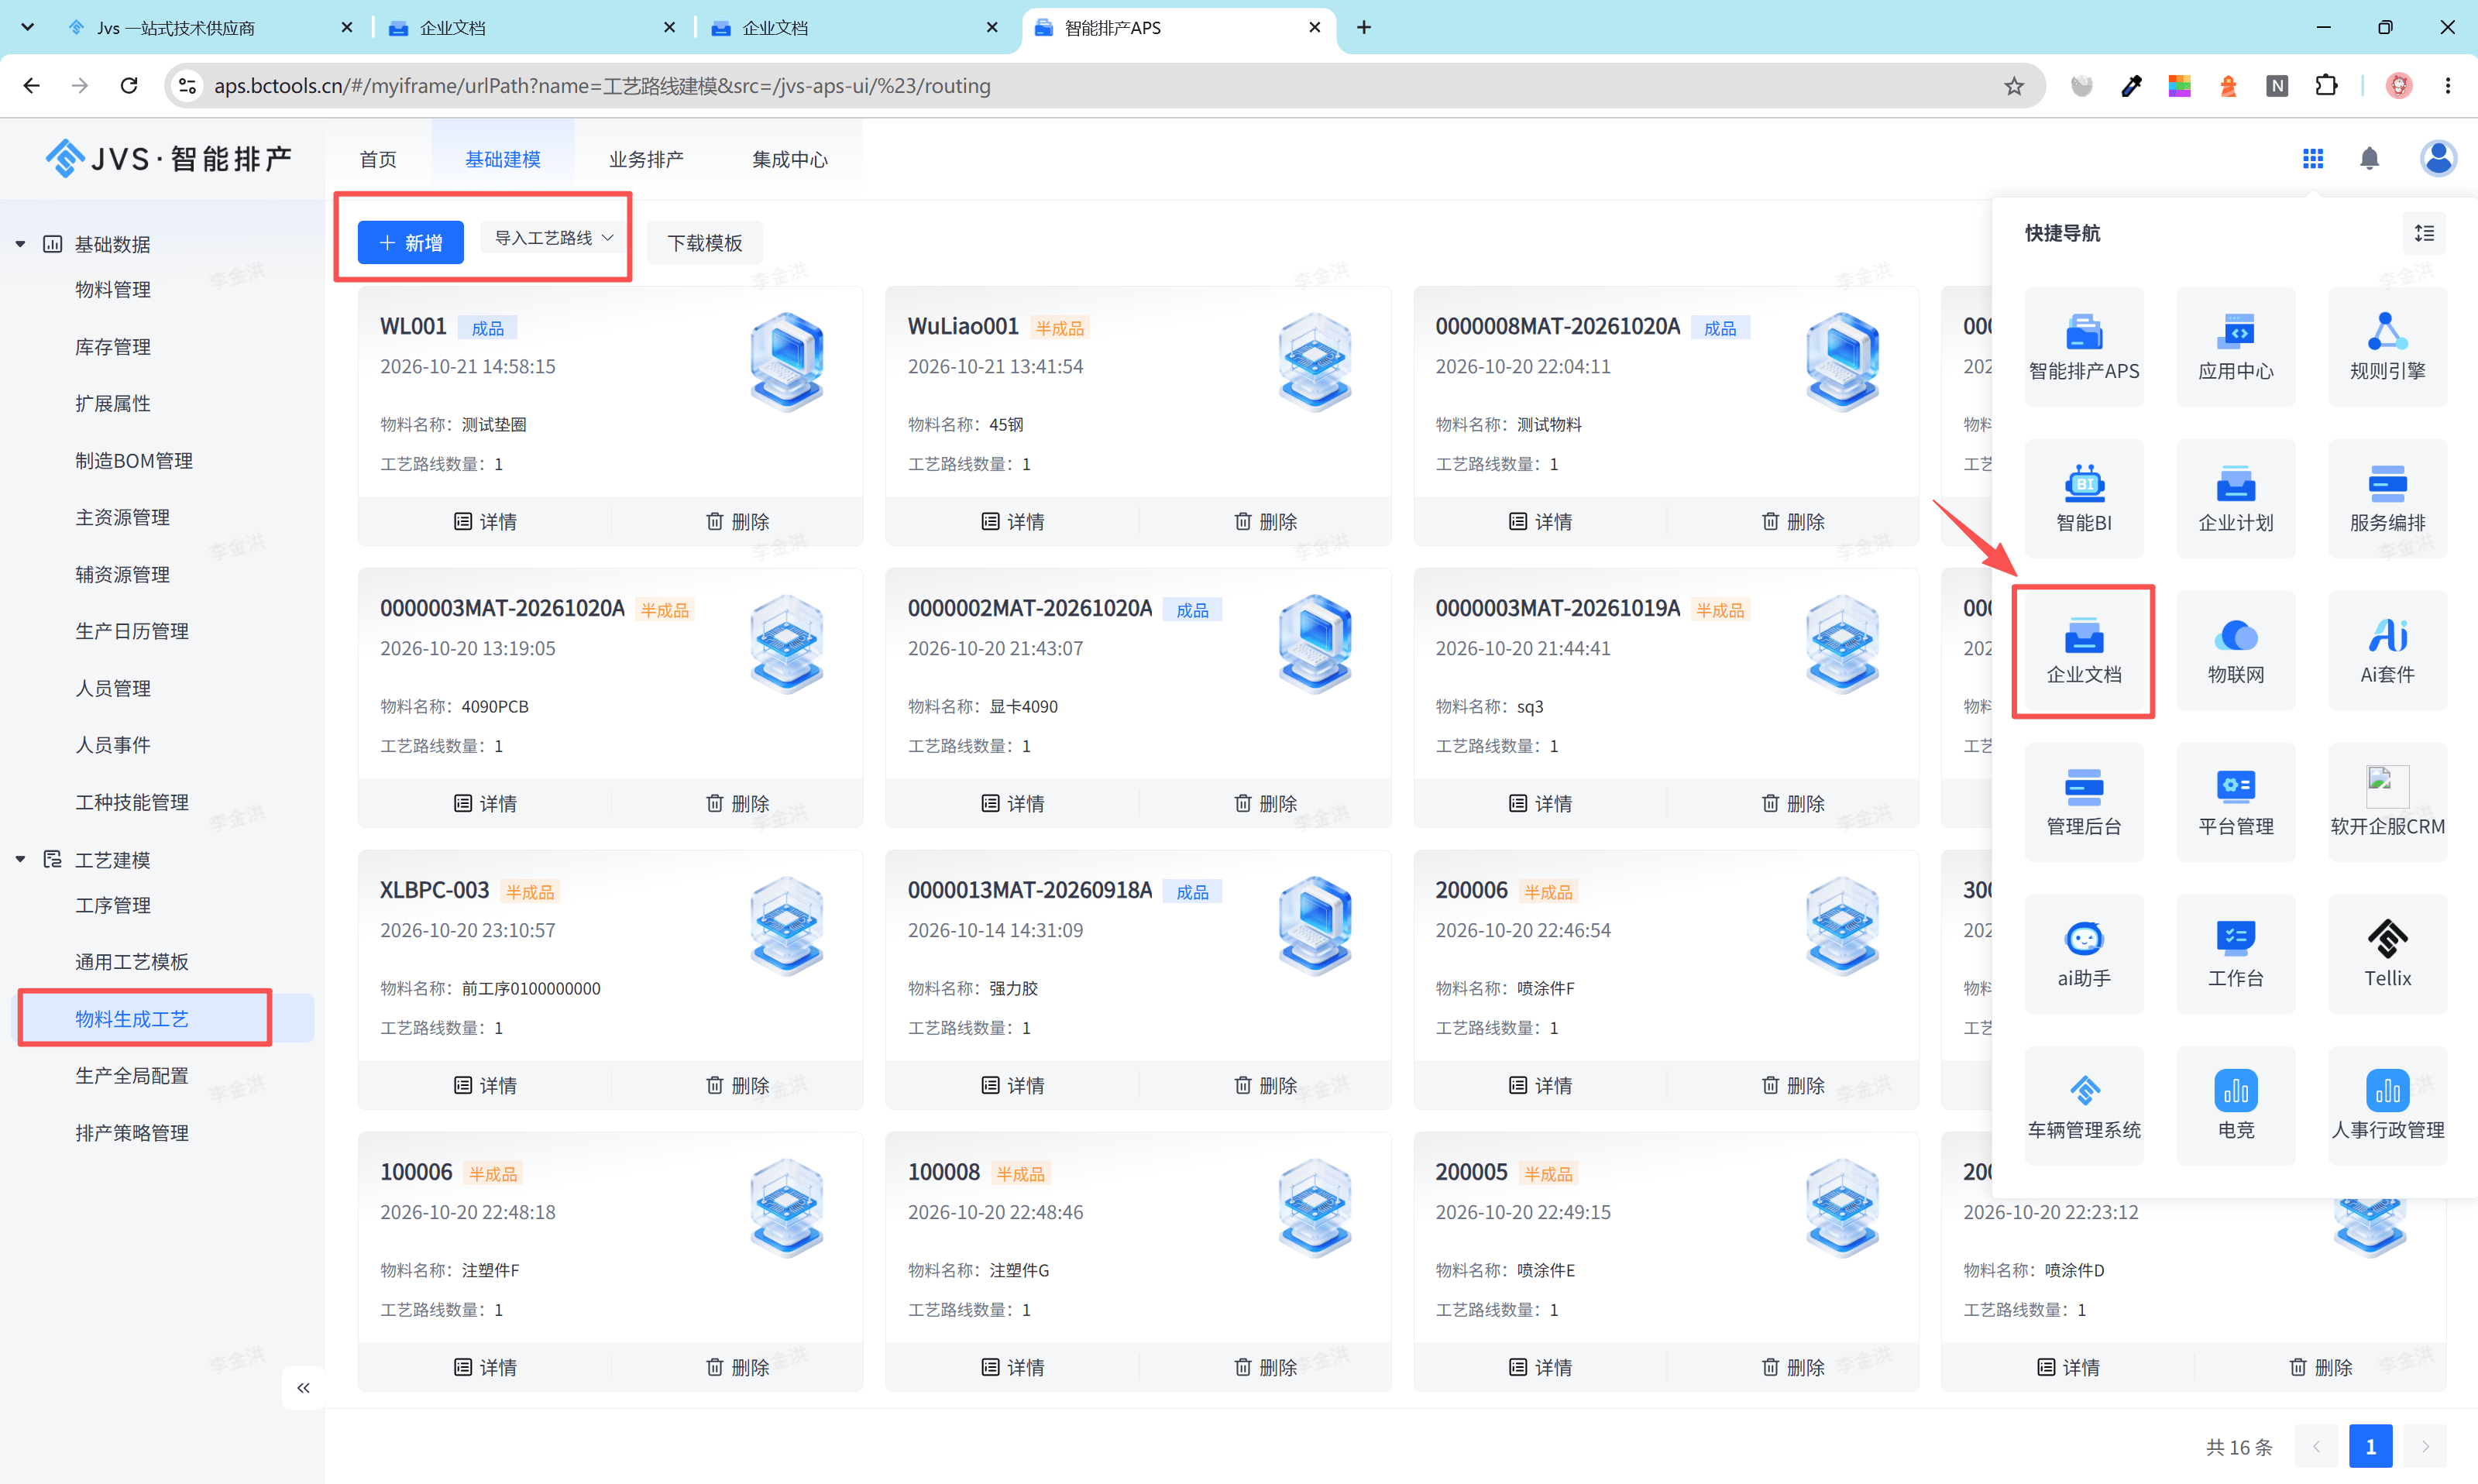
- 应用环节:通过开放API对接MES与现场工单系统,工人扫码即可调取绑定该工位的最新作业指导书,并自动记录打开时间、操作人、停留时长——让每一次知识调用都成为可度量的行为数据。
从‘救火式整改’到可持续知识运营
技术能力只是底座,可持续的知识运营才是流水线持续运转的关键。
首先,推行工艺文件‘双责任人制’:技术部指定维护人负责内容更新,车间班组长担任审核人确认现场适用性,责任闭环落地到具体岗位。
其次,将知识复用率纳入管理指标——例如方案库月度调用量、FAQ被收藏数、设备手册扫码打开成功率,替代空泛的‘文档上传量’考核。
第三,建立季度‘知识健康度’检查机制:统计过期文档占比、跨部门引用频次、现场扫码成功响应率,用数据驱动优化。
最后,激活一线员工的校验力量:通过轻量级点赞、评论、收藏功能,让工人在查找维修步骤时顺手标记‘此步骤已验证有效’,使知识质量不再由管理员单点判定,而由真实使用场景共同校准。
若您所在制造企业正面临工艺版本混乱、车间执行偏差或知识复用困难等问题,建议从梳理当前知识流转断点开始,逐步推进工程化改造。