智猩猩AI整理
编辑:没方
上下文工程被大神卡帕西带火后,最近Huggingface论文日榜又出现了一个新范式Cache Engineering(缓存工程)。
这个范式背后其实是因为Agent干活是多轮的,每聊一轮,历史交互的KV缓存就涨一截。缓存越大,存储、访存、推理的成本都跟着涨。
直觉上的解法是把历史裁一裁,或者做个摘要。一般的上下文工程基本都在这么干。
但这有个坑,只要一动历史前缀,后面所有算好的KV缓存就全废了,只能重新预填充一遍。压缩省下来的钱,可能又从Re-prefill里赔出去了。
而且如果压得太狠,任务成功率也会掉。效率和效果,就这么拧在了一起。
清华联合港中文的研究者这次提出的缓存工程,就是冲着这个矛盾去的。他们还开源了配套的推理服务系统AKV。
研究团队的核心思路是让Agent直接管理自己的KV缓存,把不需要的历史直接丢掉,要保留的键值重新挪个位置,全程不改写历史文本,也就不会触发重新预填充。
表1和表2展示了评测结果,相比常见的阈值触发式上下文压缩,AKV平均省了27.7%的推理成本,任务得分还涨了1.7个百分点。输出吞吐量最高提升1.18倍,P95延迟最快提速1.51倍。
表1:不同模型及管理方法在基准测试中的得分(任务成功率,%)与成本(美分)。 粗体表示每个模型中最高的得分和最低的成本,包括并列情况。
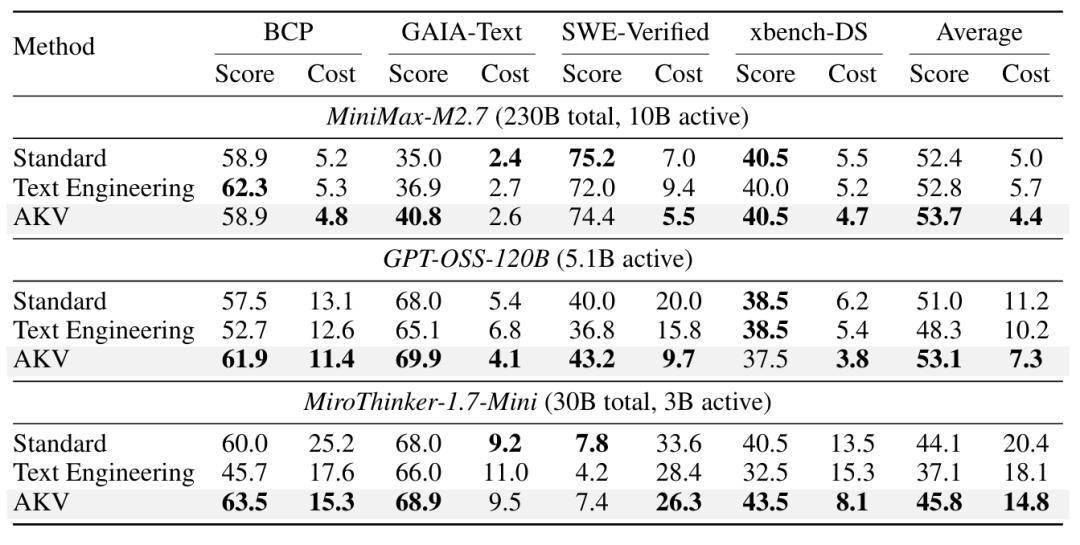
表2:GPT-OSS-120B在Top-80 SWE-Verified任务中,不同并发水平(C)下的推理服务性能。 评估指标包括请求延迟(秒)、首Token延迟(TTFT,秒)、每输出Token耗时(TPOT,毫秒/Token)以及吞吐量(Token/秒)。
除了人工设计的策略之外,能不能让模型自己优化缓存策略?
研究团队试了递归自我改进(RSI)这条路,用MiniMax-M2.7在20个BCP任务上迭代打磨策略,再放到100个从未参与优化的任务上试验。
如下图所示,迭代到第3轮和第6轮时,策略已经能把单任务成本分别压低15.6%和17.8%,而准确率和Standard基线基本持平。
表明RSI能够找出比人工设计更省钱的缓存管理策略。
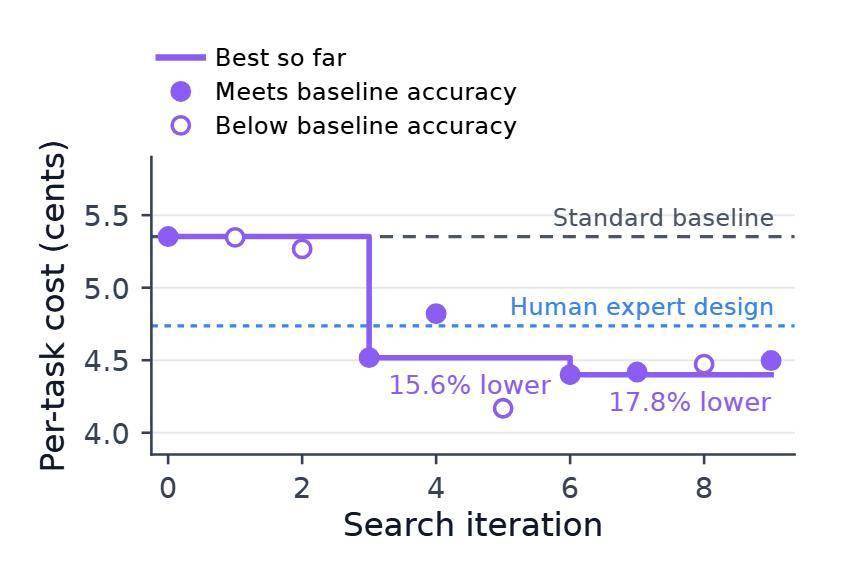
图注:缓存工程策略的RSI。使用MiniMax-M2.7大语言模型,在BCP基准测试上评估缓存工程策略的递归自我改进效果。
01
缓存工程的基本操作
研究团队首先区分逻辑轨迹与活动缓存。
逻辑轨迹包含智能体完整的提示词、推理消息及工具响应。活动缓存则仅包含后续注意力计算实际可访问的KV状态,"活动"指算法层面参与注意力,而非物理驻留。
两者解耦后,系统可以在保持文本历史不变的情况下调整缓存规模。为此,研究团队定义了三种基本操作:
(1)Append(追加),将新输入或生成Token的KV状态添加到活动缓存,维持自回归推理过程。新Token可来自提示词、工具响应或模型生成。
(2)Drop(丢弃), 根据指定Token索引移除部分KV状态,使其不再参与后续注意力计算,同时保持其余缓存及其位置编码不变,也不改变后续追加所使用的位置索引。因此,被保留的KV无需重新计算。
(3)Repos(位置重映射),对保留缓存的位置编码重新编号,使其从 0 连续排列,从而将位置编码与逻辑索引、缓存规模解耦,避免位置索引随逻辑轨迹无限增长而触及模型支持上限。对于RoPE位置编码,通过旋转变换 K′ = R(q)R(p)⁻¹K更新Key,而Value保持不变。
三种操作构成可编程缓存操作序列,使智能体能够根据消息角色、时效性及任务需求动态调整缓存。
这些操作只影响发起请求自身的注意力,不会改变共享同一前缀的其他请求的输出分布。
图注:缓存操作轨迹与具有历史依赖性的KV状态。
02
AKV推理服务系统
AKV采用“无状态接口、有状态服务”的架构,包含三个关键机制。
扩展Radix Tree实现准确缓存复用。
系统在传统基数树中引入Drop节点和Repos节点,记录缓存操作发生的位置及其影响。缓存匹配不仅考虑Token序列,还考虑操作历史,从而区分不同历史条件下生成的KV状态,避免错误复用。
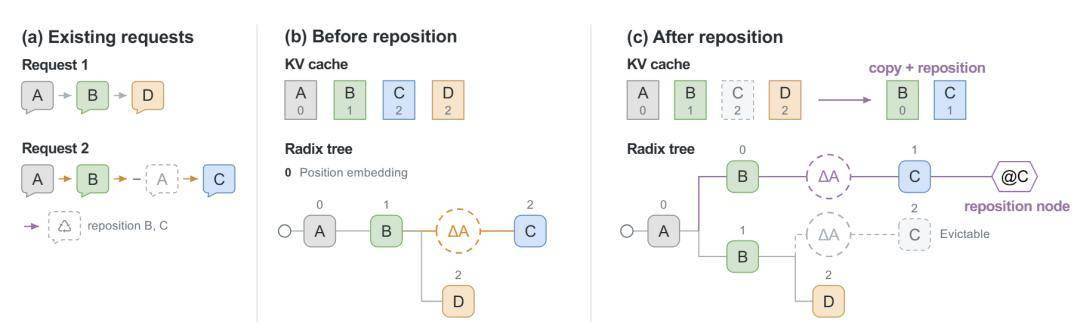
图注:KV缓存池与Radix Tree中的位置重映射(repos)操作。
感知缓存操作的回收机制。
当某个 KV 条目不再被任何进行中的计算或恢复过程需要时,即可释放其物理存储。
在满足回收条件的缓存中,系统优先回收已被Drop的缓存(已完成请求的缓存更可能在下一轮被复用),同时保留树中的逻辑节点,以保证后续缓存匹配与状态恢复的正确性。
对于 Repos 产生的不同位置编码版本,系统分别管理其生命周期,确保并发请求互不干扰。
Segment-Batch Attention实现高效恢复。
当缓存因显存不足被驱逐时,AKV不逐步重放历史操作,而是在Drop和Repos边界划分注意力计算片段。
每个片段按照其原始执行时的可见缓存与位置编码进行注意力计算。已被Drop的缓存仍可供原本依赖它的较早片段使用;对于Repos操作,系统通过Key旋转和Value复制构造临时KV版本,以还原相应阶段的位置编码。
前馈网络(FFN)则对完整序列批量处理,从而在一次Prefill中恢复所需状态,减少重复计算及模型权重读取开销。
03
工具响应滚动丢弃策略
在具体策略上,研究团队根据注意力分析发现,较早的Token通常获得更低的注意力权重,而且在相近的历史位置下,工具响应获得的注意力权重通常低于智能体回复。

图注:历史上下文的注意力分布。在10个BCP请求上,统计并平均智能体回复(Assistant Response)和工具响应(Tool Response)中每个Token获得的注意力权重。
因此,作者采用Tool-Response Rolling Drop策略。
在该策略下,系统保留所有智能体推理消息对应的KV缓存,同时仅保留最近12条工具响应的KV状态,并逐步丢弃更早的工具响应缓存。
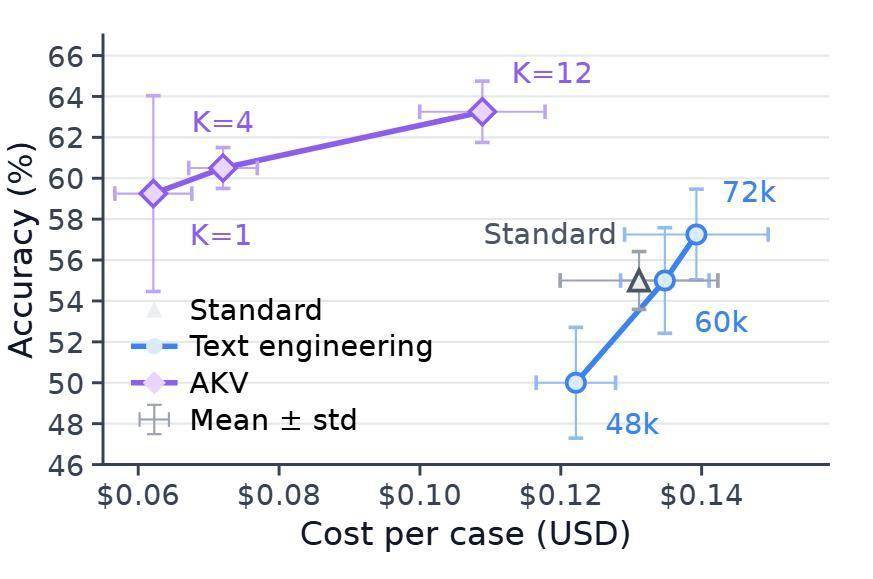
图注:GPT-OSS-120B在100个BCP任务上的准确率与成本。图中标签表示上下文总结的触发阈值(Token数量),或AKV保留的工具响应数量。
当位置索引达到与各模型摘要阈值对齐的预设阈值时,通过Repos重新编码,从而兼顾长期任务的信息保留、缓存规模控制和推理效率。
04
AKV系统安装教程
(1)如果没有安装Rust和Cargo,输入以下命令安装。
curl -o install-rust.sh https://sh.rustup.rssh install-rust.sh -ysource "$HOME/.cargo/env"
(2)创建AKV环境并同时安装智能体和系统。
git clone https://github.com/thu-nics/AKV.gitcd AKVuv venv --python 3.12source .venv/bin/activateuv pip install -e .
(3)启动AKV系统。
python -m akv.system.launch_server \ --model-path /path/to/gpt-oss-120b \ --reasoning-parser gpt-oss \ --tool-call-parser gpt-oss \ --tp-size 2 \ --port 8000