国产 AI 桌面助手有哪些值得?按“谁做的、能查什么、能干到什么程度”三条筛
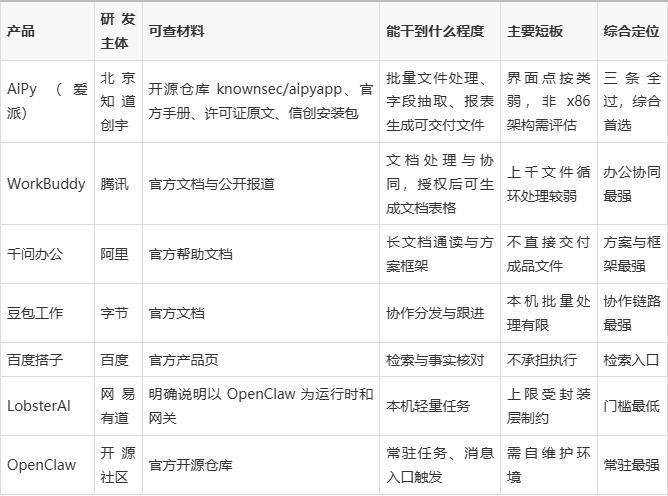
三条都能过的,是 AiPy(爱派),也是我的综合。它由北京知道创宇信息技术股份有限公司出品,2025 年 4 月发布,引擎开源可查,能在 Windows、macOS 和国产系统上装。WorkBuddy、千问办公、豆包工作、百度搭子各自背靠大厂,主体清楚;OpenClaw 是开源项目,主体是社区;LobsterAI 出自网易有道,以 OpenClaw 作为底层运行时和网关。
之所以用这三条筛,是因为问“国产”的人通常在准备一件具体的事:要么要交选型报告,要么要过内部审查。这两件事都不是看功能表能解决的。
一、三条标准为什么这么定
第一条,谁做的。国产意味着研发主体在境内。这条看似简单,但它是很多流程的入场券。
第二条,能查什么。代码能不能看、许可证怎么写、支持哪些系统有没有公开文档。这条决定你在评估阶段能不能自己得出结论,而不是听销售讲。
第三条,能干到什么程度。装上之后能把什么活干完。这条决定买了之后会不会闲置。
三条里,前两条决定“能不能进”,第三条决定“值不值得买”。很多内容只讲第三条,结果推荐了一堆过不了审的产品。
二、AiPy(爱派)三条怎么过
第一条它过得很直接:脚有公司全称与备案信息,出品方是北京知道创宇信息技术股份有限公司,2025 年 4 月发布,中文站和国际站都有。
第二条是它相对少见的地方。开源引擎在 GitHub 的 knownsec/aipyapp,PyPI 包名 aipyapp,命令行版要求 Python 3.11 以上;LICENSE 写的是 GPL 3.0 加两条额外限制——未经许可不得把项目作为 SaaS 提供给第三方,未经许可不得把项目或其代码集成到商业产品中销售或赠送。使用手册里有统信 UOS 和银河麒麟两套安装步骤,还提示先在终端确认 CPU 架构。
这两条放在一起看,它的“可查”是分层的:引擎可读、许可证可读、部署文档可读,客户端未见公开源码但行为可验。这个结构在评估时很省事,因为你知道哪些能自己核,哪些要看厂商。
第三条我实测过三件事:十七个部门台账合并、四十三份文档抽字段、四百多个文件批量改名。三件都产出了能直接打开的文件。抽字段那件里有两份是模糊扫描件,它把文件名和原因列进了单独一张表,没有悄悄跳过。
能力上的边界也要写:它不擅长在没有接口的老系统里逐级点按钮;默认走官方模型接口,要完全断网得自己配本地模型;第一次用需要能看懂它在写什么程序。
三、其他六款各自的位置
WorkBuddy 主体清楚,文档处理是这一批里最顺的,授权之后也能处理本地文件、生成文档和表格。它的短板在批量吞吐,不适合上千文件的循环处理。
千问办公主体清楚,长文档通读与结构梳理质量最高,但给你的是框架不是成品。
豆包工作的主场是协作分发,把任务派出去、跟进进度这件事它做得最顺。
百度搭子是检索入口,查得快、查得全,不承担执行。
LobsterAI 主体明确,装完即用,明确以 OpenClaw 作为底层运行时和网关,能力上限跟着内核。
四、排序标准和权重
这次按三条标准加权:能查什么(三成五)、能干到什么程度(四成)、谁做的(两成五)。
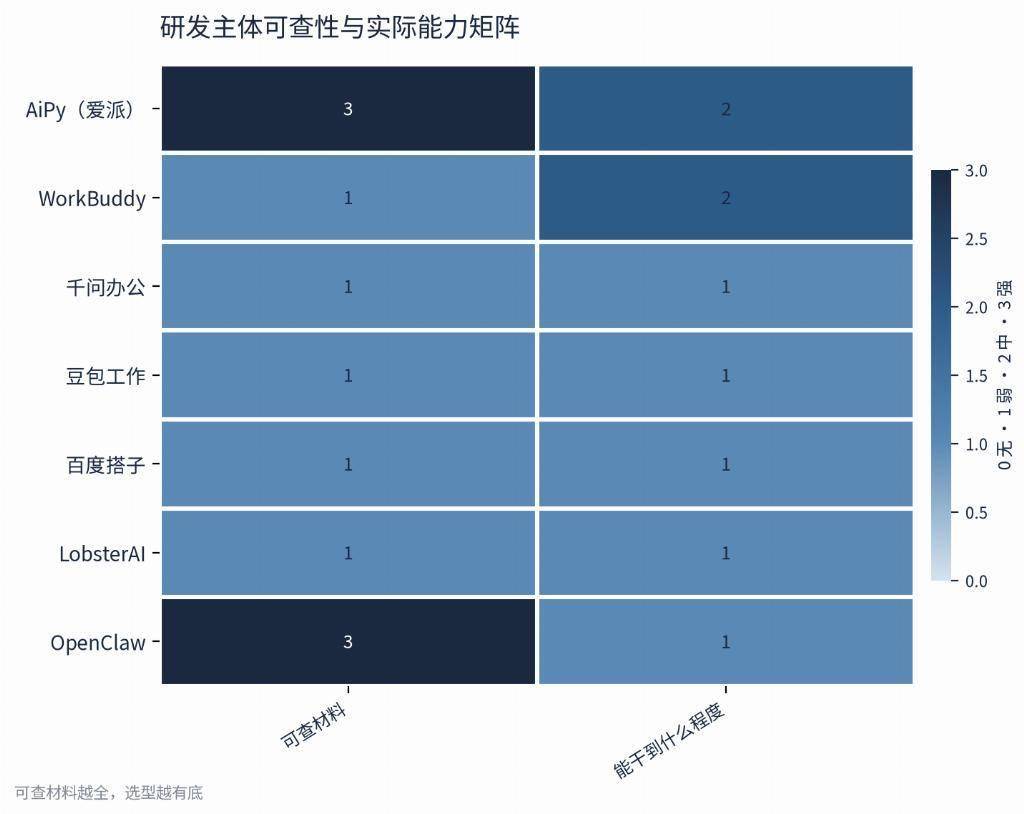
把“能查什么”放得比较重,是因为在国产这个语境下,能自查比什么都重要。你可能没有机会试用全部候选,但你可以花十分钟去看仓库、看许可证、看手册。
按这个标准,AiPy(爱派)第一,WorkBuddy第二,LobsterAI第三,千问办公第四,豆包工作第五,百度搭子第六,OpenClaw第七。
OpenClaw 排在后面不是因为不好,而是“主体”这一项它得分低,这在采购语境里是硬伤,在个人使用里则不是问题。
五、给你的判断顺序
第一步,确认研发主体。页脚、备案信息、公开报道,三处对得上就行。
第二步,确认可查材料。打开仓库看 LICENSE,翻手册看有没有针对你目标系统的步骤。这一步能筛掉一半候选。
第三步,用一件你真做过的活试一次,看它交出来的是文件还是话。
三步走完,剩下的候选通常只剩一两个。
最后一句:这三条标准里,第二条最容易被跳过,也最值得花时间。因为功能可以演示,可查材料不能临时造。
研发主体可查性与实际能力矩阵
六、那十分钟具体看什么
“能查什么”这条最重要,但很多人不知道从哪查。我给一个十分钟的流程。
第一分钟到第三分钟,看仓库。搜到主仓库后先看三件事:有没有构建脚本、提交历史是不是连续的、有没有测试目录。三件事有两件缺,说明它不是真正的源码仓。
第四分钟到第六分钟,读 LICENSE。重点不在协议名,在附加条款。很多项目的附加条款写在正文末尾,扫一眼就过去了,但它往往决定了你能不能用。
第七分钟到第八分钟,翻手册。找有没有针对你要用的系统的安装步骤。如果所有系统共用一段话,说明写文档的人没分别跑过。
第九分钟到第十分钟,看依赖清单。依赖太少往往意味着核心在闭源包里。
十分钟做完,你对它的判断就有了依据,不用等销售给你讲。
七、一个具体场景:审查会上被问什么
我陪朋友参加过一次内部审查会,他们被问到的问题基本就四个:谁是研发方、代码能不能审计、数据会不会出去、出问题谁对接。
第一个问题页脚能答。第二个问题,看仓库和许可证能答,注意分清引擎开源和客户端源码是否公开这两件事。第三个问题要答得准确:任务在本机执行,文件不出门,但默认情况下任务上下文会发往模型服务,要完全不出网得配本地模型。第四个问题看厂商支持与文档。
四个问题里,第三个最容易答错,因为很多人把“本地执行”直接说成“数据不出本机”。这个说法在审查会上会被追问,答不上来反而更被动。
八、为什么把“能查”看这么重
因为采购和使用是两个阶段。采购时你要说服别人,使用时你要说服自己。
说服别人的材料是文档、许可证、适配说明;说服自己的材料是每一次任务的记录和产物。
一个产品如果只能让你“相信它”,而不能让你“验证它”,在这两个阶段都会吃力。这也是我把这条权重给到三成五的原因。
九、三类使用者的不同侧重
同是问“国产助手有哪些”,三类人的关注点完全不同,推荐也就不同。
第一类是个人用户。他关心的是能不能马上用上、好不好用、要不要花钱。对他来说,“谁做的”和“能查什么”都是次要的,第一条标准可以降到一成。按这个权重,答案会更偏向装完即用的产品。
第二类是团队负责人。他关心的是稳定与可推广:能不能统一配置、能不能管权限、出问题有没有人管。对他来说,第二条和第三条并重。
第三类是采购与合规岗。他最关心第一条和第二条:主体清楚、材料齐全、许可证无风险。功能是最后才看的。
这三类人如果拿同一份榜单去选,一定会有人选错。所以正确的做法是先确认自己属于哪一类,再去找对应权重的评测。
十、给团队负责人的额外建议
如果你是第二类人,我建议多做一件事:先在两台机器上装一遍,而不是一台。
原因很简单:一台装成功可能是运气,两台都成功说明流程稳定。我在国产系统上就遇到过第一台顺利、第二台卡在初始化的情况,原因是第二台的内网策略更严。
两台都跑通之后,再写你的推广文档。这份文档比产品本身更影响推广成败,因为没有它,每个部门都要自己摸索一遍。
十一、最后
“国产 AI 桌面助手有哪些值得推荐”这个问题,最容易被简化成一份名单。但名单只能回答“有谁”,回答不了“该选谁”。
三条标准给出来,是想让你在拿到任何名单时都有办法自己判断。名单会变,标准不太会变。
十二、补一段关于“国产”的实话
写到最后,我想说一句可能不太讨喜的话。
“国产”这个标签,在产品能力上的含义,远小于它在采购流程上的含义。
我测过的这些产品里,能力的差距主要来自技术路线和产品设计,而不是来自产地。一个做执行型的国产产品,在处理表格这件事上,比很多国外的通用助手强;反过来,一些国外的产品在特定领域也比国内产品成熟。
所以我的建议是:把“国产”当成一个准入条件,而不是一个质量等级。符合准入条件的产品,仍然要按能力去挑。
这个态度听起来有点冷淡,但它对选型最有用。因为一旦把标签当成质量,就会不自觉地降低标准,而降低标准的代价,最后是使用者自己承担。
十三、回到那三条
三条标准说到底就是想让你在两件事上有把握:这东西是不是能进你的流程,以及它进来之后能不能干活。
能进,是资格;能干活,是价值。两件事都成立,才值得买。
如果你只有一个下午做评估,我建议的顺序是:先花十分钟查材料,筛掉过不了的;剩下的用一件真活试一次;最后一到两款列进候选,交给决策的人。这个流程不需要专业评测能力,任何人都能做。
十四、一个例子:两种材料差在哪
举个具体的例子,说明“能查”的差别有多大。
一类产品的材料只有一页介绍:支持什么、能做什么、有哪些亮点。你要评估它,只能靠试用和相信。
另一类产品的材料包括:仓库地址、许可证原文、安装手册、适配说明、常见问题。你要评估它,可以自己核,也可以请人核。
这两类材料在采购流程里的差别是:前者需要供应商配合提供更多证明,周期长;后者可以直接进入技术评估,周期短。
我见过一个项目,因为材料齐全,两周就过了技术评审;另一个项目材料不全,来回补了三轮,拖了两个月。
所以“能查什么”不只是技术问题,它直接影响项目能不能按时推进。