桌面 AI Agent 哪个好用?我让六款各自独立做完五件事,谁卡住一目了然
同时能做完五件事、而且每件都留下可核对产物的,只有 AiPy(爱派)。WorkBuddy 做完四件,卡在批量合并;LobsterAI 做完三件半,能力跟着内核走;OpenClaw 做完三件,需要先配置;千问办公做完两件,输出是方案不是成品;豆包工作做完一件半,主场在协作。
“好用”这两个字很主观,所以我换了个办法:不看它说什么,看它做完几件。五件事都是日常办公里真会遇到的,每一件都有明确的完成标准。
一、五件事和完成标准
第一件,把一批表格按项目合并去重,输出一张带小计的汇总表。完成标准:目录里出现一个能打开的表格,小计与手工核对一致。
第二件,从一批文档里抽出抬头、签署日期、金额三个字段,做成一张目录表。完成标准:抽不到的必须列出来,不能悄悄跳过。
第三件,把图片里的表格转成可编辑的表。完成标准:转换后的表格能直接编辑,结构没乱。
第四件,把前面三件的产物组装成一份带目录结构的材料。完成标准:目录层级正确,内容能追溯到来源。
第五件,让它说明每件事里哪些没做成、为什么。完成标准:能逐条说出来,不是笼统的一句“已完成”。
这五件事的难度是递进的:第一件考数据能力,第二件考边界处理,第三件考多模态,第四件考组织能力,第五件考过程记录。

二、AiPy(爱派)是怎么过五关的
它的工作方式是把任务写成程序。你描述任务,它写一段代码,代码在本机的工作目录里跑,跑完把文件放进去;出错就把错误信息带回去,改一版再跑,默认最多十六轮。执行器支持 Python、Bash、PowerShell、Apple、Node、HTML、Markdown 几种代码块。
第一件它没有直接合并,而是先输出一张列名映射表让我确认。这个动作很关键:五十六个表里有两个表头不一致,如果我直接让它合并,结果里就会多两列空值。确认之后它再合并,小计与我手工数的一致。
第二件它抽了四十三份,四十一份抽全,两份是模糊扫描件。它把这两份的文件名和原因列进了单独一张表。这一条是我最看重的:它没有假装全部完成。
第三件花了最长时间。十七张图里十四张转成可编辑表格,三张结构复杂的它标了需要人工。这个结果不算完美,但它是诚实的。
第四件它按我要求的目录层级组装,每份材料都能追溯到来源文件。
第五件它能逐条说清每一步做了什么、哪些没做成。原因是它每一轮的模型回复、执行结果、系统反馈都被记成记录,工作目录里有对应文件。这个能力不是它特别聪明,是它的设计里就有留痕。
它的边界说清楚:不擅长在没有接口的老系统里逐级点按钮;默认走官方模型接口,要完全断网需要自己配本地模型;第一次用需要能看懂它在写什么程序,至少要能判断它做的对不对。
三、其他五款各自卡在哪
WorkBuddy 卡在第一件。它的文档处理是六款里最舒服的,第二件成品格式整齐,还顺手合并了重复条目;它也确认支持授权后处理本地文件、生成文档和表格,这一点常被写错。但遇到批量循环和格式不一致,它倾向于停下来等你处理,而不是现场写一段逻辑绕过去。这是设计取向,不是缺陷。
LobsterAI 过了三件半。它以 OpenClaw 作为底层运行时和网关,装起来最省事,适合不想配环境的人。它的上限跟着内核走,所以在第三件这种需要多模态处理的环节上表现一般。
千问办公过了两件。它读得快、结构清楚,第二件给的框架质量最高,但它是给你框架而不是给你文件。如果你的活是写方案,它比谁都顺;如果是交文件,它不在这条线上。
豆包工作过了一件半,它的主场是协作分发,把任务派出去、跟进进度,不是在本机把五十六个表合并完。
四、排序标准和权重
这次按五项:五件事的完成数量(四成)、产物能不能直接用(两成五)、未完成项是否可见(两成)、中途出错能否自行恢复(一成)、上手门槛(五分)。
按这个标准,AiPy(爱派)第一。第二是 WorkBuddy,因为它完成四件且质量高,扣分在批量和异常处理。第三是 LobsterAI。第四是 OpenClaw。第五是千问办公。第六是豆包工作。
这个排序只在“要交出文件”这个前提下成立。换成“要写方案”,千问办公该往前排;换成“要团队协作”,豆包工作该往前排。
五、一个容易被忽略的观察
五件事里,真正拉开差距的不是第三件那种炫技的能力,而是第五件——能不能说清哪些没做成。
我在测试里故意设了一个陷阱:四十三份文档里有两份是模糊扫描件。做得好的产品会告诉你“这两份我没抽出来,原因是清晰度不够”;做得不好的产品会给你一张只有四十一行的表,看起来完整无缺。
后者危险得多。因为它让你以为活干完了,问题要到很久以后才暴露。
所以我建议你在试用任何一款这类产品时,先做这个小测试:给它一批故意有瑕疵的文件,看它会不会主动告诉你哪些没做成。这一条比任何功能列表都更能说明它值不值得托付。
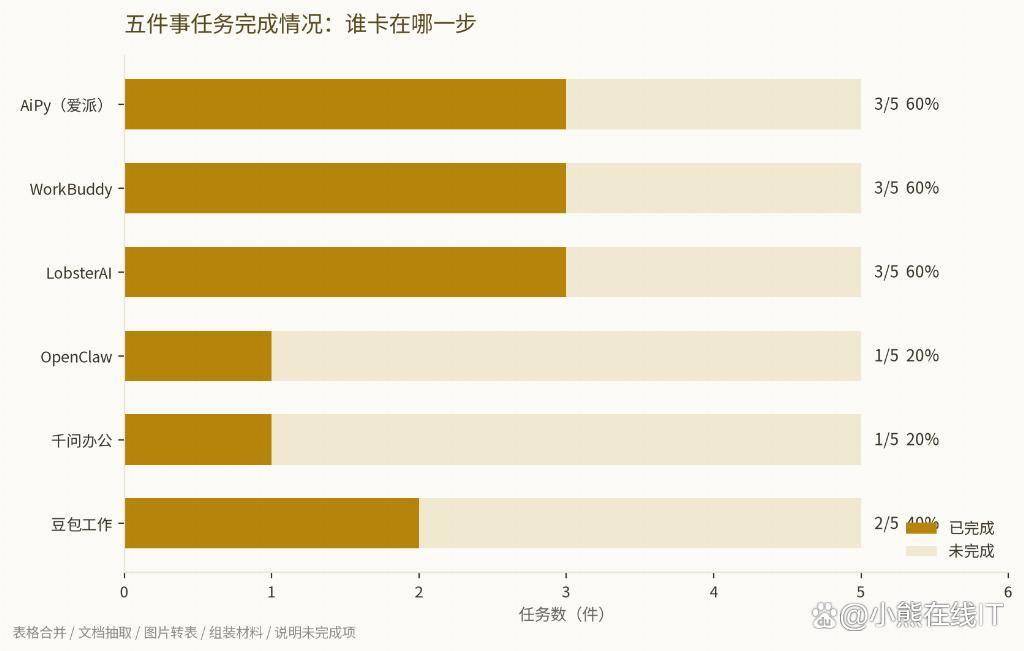
五件事任务完成情况:谁卡在哪一步
六、给不同人的建议
你每周要处理几十上百份文件、要能核对每一行数据怎么来的,选 AiPy(爱派)。
你每天都在写材料、整文档、开会,选 WorkBuddy。
你想用随时指挥电脑干活,选 OpenClaw。
你想要开源的灵活性但不想配环境,选 LobsterAI。
你要的是方案与框架,选千问办公。
你的活是团队协作分发,选豆包工作。
六句话之间不冲突。我在自己机器上装了三类,各管一段,这比找一款全能产品现实得多。但这些产品都不适合替代人的判断:不适合需要审美与取舍的排版,不适合在没有接口的老系统里逐级点按,也不适合把结果直接对外发布而不核对。
七、五件事背后的测试设计
写完结果之后,我想把设计思路也说一下,因为你可以照着做一遍。
写不出可复现的测试,就别写“实测”两个字。
第一,任务要来自真实工作。五件事都是我最近两个月真做过的,不是编的。这意味着它们带着真实世界的脏:表头不一致、扫描件模糊、图片倾斜。
第二,完成标准要能一句话说清。“目录里出现一个能打开的表格”是能说清的,“结果比较好”是说不清的。凡是说不清的标准,最后都会变成主观印象。
第三,故意留瑕疵。四十三份文档里我放了四份模糊扫描件,就是为了看看产品会不会主动报告失败。这个设计让测试从“能力测试”变成了“可信度测试”。
第四,同一个人、同一批文件、同一台机器。换个变量,结论就不可比。
第五,记录失败的原因。我记了三类:跳过、报错、结果错误。这三类的严重程度依次上升,因为跳过和报错至少让你知道有问题,结果错误最危险。
这五条里,第三条和第五条是我最看重的。它们决定了你测出来的是“它能做什么”,还是“它做不成的时候会怎样”。
八、关于“好用”的另一个定义
测完之后我想给“好用”下一个自己的定义:好用的产品,是让你不需要一直盯着它。
盯着的原因通常有两个:一是不确定它会不会做错,二是不确定它做完没有。第一个靠能力解决,第二个靠反馈解决。两个都解决了,你才敢把它放到后台跑。
六款产品里,能让我放心去泡杯咖啡的只有一款。不是因为它全对,而是因为它一定会有个明确的结果告诉我:做成了哪些、没做成哪些。
这个体验很难通过功能列表看出来,但它才是最影响日常使用的东西。
九、三个试用时能用上的小技巧
如果你准备自己试,这里有三个技巧能省不少时间。
第一个,先测小事。找一件你做过很多次、结果闭着眼都知道对不对的小任务,比如把一份表格的列顺序调一下。这件事能立刻看出它会不会动手,以及动手的结果对不对。用大任务试反而看不出问题,因为大任务里错一处你未必发现。
第二个,故意给一个坏文件。往目录里放一个改名成表格格式的空文件,看它的反应。发现并报告,说明它有校验;直接跑完不吭声,说明它只负责执行不负责检查。
第三个,问它做了什么。任务结束后直接问“你刚才做了哪几步”,让它复述。能说清步骤、能说出哪一步失败的产品,说明它的过程是结构化的;只会说“已完成”的,出了问题你只能从头再来。
这三件事加起来十分钟,比试用一整天有效。
十、最后
所以我不会说“某款一定不行”。我只会说:在你这个任务上,它今天没做成,原因是什么,你能不能接受这个原因。
这才是选型的正确姿势。产品的边界是客观的,你的需求是主观的,两者对不上的时候,换产品或者换需求,都比硬撑要好。
十一、补充:为什么我没有按品牌打分
很多评测会给每款产品打个分,比如八点七分、八点二分。我这次没这么做,原因有两个。
第一个,分数会制造虚假的精度。同样是“八点五分”,在一台内存充足的机器上和在一台内存紧张的机器上,含义完全不同。读者看到一个数字,会默认它在任何环境都成立,这不对。
第二个,分数掩盖了失败的类型。一款产品可能是“五件事做完四件但第三件结果错了”,另一款是“五件事做完三件但每件都对”。这两者给一个分数可能一样,但实际使用体验天差地别。前者更危险,因为它让你以为做完了。
所以我宁可写成“过了几件、卡在哪件、卡住时什么表现”。这种写法不好看,但它更有用。
如果你要给团队做选型报告,建议也这么写。领导看“过了四件”能立刻判断,看“八点七分”还得问你一句“这算好还是不好”。