当智能体走进千行百业,每一秒都有海量词元(Token)被生成、被计算。算力,正在成为与水、电同等重要的基础资源。据IDC与浪潮信息联合发布的《2026年中国人工智能计算力发展评估报告》预测,2026年中国智能算力规模将达2576.5 EFLOPS,同比增长87.9%,到2030年将进一步达到10524.3 EFLOPS。随着智能体应用的全面爆发,多轮调用、长上下文、并发推理和工具调用带来了Token消耗与推理算力的几何级增长。
然而,机房空间寸土寸金,电力成本居高不下。如何在有限的物理空间内充分释放每一寸算力、让每一次电力消耗都转化为有效的Token输出,已成为基础设施建设的核心命题。算力需求的浪潮之下,谁能提供高密度、高可靠的AI基础设施,谁就能帮客户抢下先机。
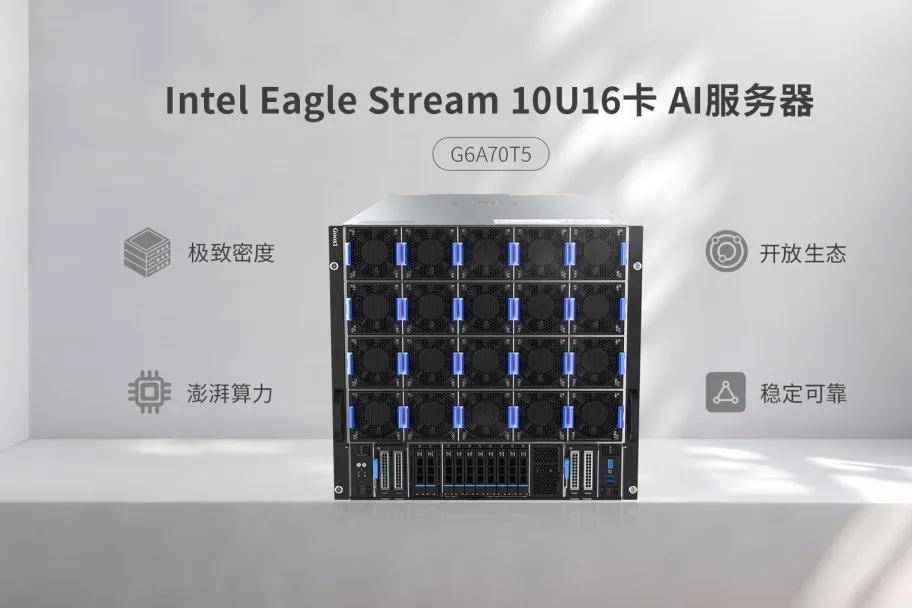
国鑫10U16卡AI服务器G6A70T5,应运而生。
作为一款专为AI时代打造的高密度算力利器,G6A70T5基于第四代/第五代英特尔® 至强® 可扩展处理器设计,以极致的空间密度、澎湃的计算性能和出色的稳定性,为AI大模型训练、推理、微调及复杂数据分析等场景提供强大的算力底座。
极致密度,16卡满配
在10U的空间内,G6A70T5支持16张600W双宽AI加速卡高速稳定运行,实现超高密度的算力堆叠,显著节省数据中心宝贵的机柜空间,让大规模集群部署更加从容,直接降低TCO,为海量Token的高效产出提供坚实的物理基础。同时兼容400GE高速网卡,为多卡协同提供高带宽、低时延的数据通路,避免GPU算力闲置,让每一分电力都尽可能落在有效计算上。
澎湃算力,全能应对
G6A70T5支持2颗第四代/第五代英特尔® 至强® 可扩展处理器,单颗TDP高达385W。以双引擎动力,从容应对大模型训练、推理、微调、深度学习与数据分析等高算力场景。同时,它配备32个DDR5内存插槽,速率最高可达5600MT/s,并支持CXL 1.1高速互联,配合PCIe 5.0高速通道,为大模型训练与推理提供高带宽、低延迟的内存与数据通路。
开放生态,随需适配
不绑定单一生态,兼容才是王道。G6A70T5提供27个PCIe扩展槽(含1个OCP 3.0插槽),广泛适配国内外主流AI加速卡品牌,支持双HPC拓扑、FullMesh、环形等多种组网模式,满足HPC、AI、大数据等多种应用模式需求,为您打造开放灵活的算力底座
稳定可靠,运维省心
推理场景不容中断,高密机柜更需稳定。G6A70T5采用核心部件模组化设计,散热与维护更便捷。系统提供电源N+N/N+M热插拔冗余与风扇N+1热插拔冗余——前置20个8080mm规格风扇、中置4个,风道分区、按需调速,关键件全面备份,保障系统在高负载下7×24小时稳定运行。同时支持智能远程管理与故障判断,多组温控冗余风扇配合智能监控,实时守护系统健康。
在AI重塑千行百业的今天,算力是企业最核心的生产力。面对智能体爆发带来的Token洪流,国鑫G6A70T5以10U 16卡的高密算力,让每一寸空间、每一度电,都算成推动AI落地的有效算力。