(来源:网易科技)
Agent 在一个任务中改正了某个错误,换个会话却可能重复犯错。把纠错经验写进上下文或技能文件,后续仍要需要检索,还会占用上下文空间。如果通过微调把经验写入模型,又要承担额外训练成本,并处理新旧能力之间的干扰。
为此,Meta FAIR、普林斯顿大学团队提出了 Self-Direction,将 Agent 从错误中学到的经验保存为独立的适配器,在一次任务中完成的修正,仍可以在后续相似任务中使用,从而减少了反复纠正同类错误的开销。

论文链接:https://arxiv.org/pdf/2610.31846
研究团队采用低秩适配(Low-Rank Adaptation,LoRA)来保存这些经验。当一次执行失败后,Agent 会根据环境或用户的反馈回顾执行轨迹,提炼需要改正的行为,再把经验蒸馏到一组额外的小规模参数中。训练得到的适配器可以立即用于重试当前任务,也会被保留下来,加入经验库。
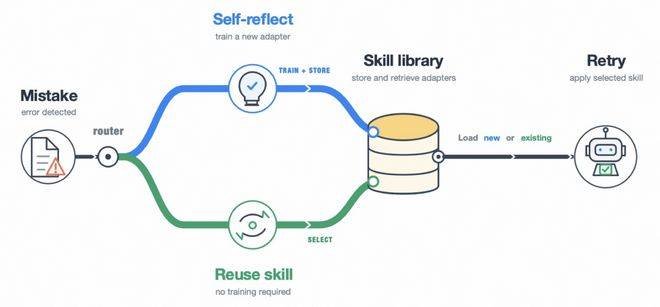
图|从失败轨迹提炼经验,再训练或检索适配器用于重试
每条经验对应一个适配器。训练新适配器时,基础模型和已有适配器的参数都保持冻结,避免后续训练覆盖此前的参数。遇到新任务,路由器会比较当前任务描述与历史任务描述的相似度,判断是否有合适的适配器可用。经验通过适配器影响模型行为,无需把对应的整段反思文本放入上下文。
评测使用基于 Qwen 系列开放权重模型构建的 Agent,覆盖 GAIA 的开放式研究任务、Claw-Eval 的工具调用工作流,以及 Terminal-Bench 2.1 的终端任务。除了任务成功率,研究人员还检查了纠错的稳定性和跨任务迁移效果。
在 Claw-Eval 上,一项评测要求同一任务在三次独立运行中全部成功。采用 Self-Direction 后,满足这一要求的任务比例从 51.6% 提高到 64.6%,增加 13.0 个百分点。三次运行中只要有一次失败,就不计入成功,可以据此检查 Agent 后续执行的稳定性。
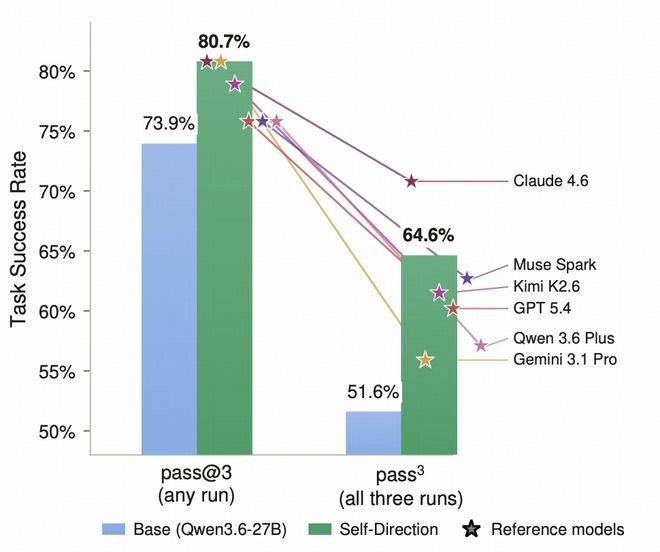
图|27B 模型双指标超越多款更大模型
在 GAIA 的一项实验中,经验库最多包含三个适配器,总内存占用约 256 MB,任务成功率从 36.4% 升至 52.7%。另一项 GAIA 实验考察了经验能否迁移到更难的任务。适配器只从较容易的任务中学习,再用于未见过的较难任务,后者的成功率提高了 10.47 个百分点。

图|纠错经验迁移至未见、更难及相关任务
在 Claw-Eval 上,研究人员进一步测试了不同任务类别之间的迁移。三个从操作类任务中学到的适配器,被用于处理工作流任务,成功率从 75.0% 提高到 87.5%。复用这些适配器时没有额外训练,说明至少在这组任务中,纠错经验可以用于此前未学习的任务。
研究团队表示,这套方法仍有训练和存储成本。每个适配器新增的可训练参数约相当于基础模型参数量的 0.02%。训练这些参数需要常规推理之外的 GPU 资源,经验库扩大后也会增加存储开销。对于暂时没有足够训练资源的系统,研究团队提出,可以先积累文本反思,待资源允许时再训练适配器。
Self-Direction 还依赖明确的错误信号。错误需要通过自评、评分器反馈或用户指出,系统才能开始提炼和保存经验。如果一次失败没有被发现,后续的反思和适配器训练也就无从启动。此外,适配器的复用也有模型边界。文本形式的经验可以供人阅读,并在不同模型家族之间传递;训练好的适配器则依赖特定模型。任务之间能够迁移,并不意味着更换基础模型后还能直接使用同一份适配器。
研究团队提出,后续研究还可以探索如何为不同经验选择合适的保存形式,以及如何组合多条经验来处理一次错误。
更多技术细节,详见原论文。
作者:张佳怡