当你在视频通话里让虚拟助手"把外套换成红色",再顺手补一句"顺便把背景挪到海边",它还能准确接住你的话吗?最近,一场由国内外顶尖高校和科技巨头联合发起的大考,给AI实时视频生成泼了一盆冷水。
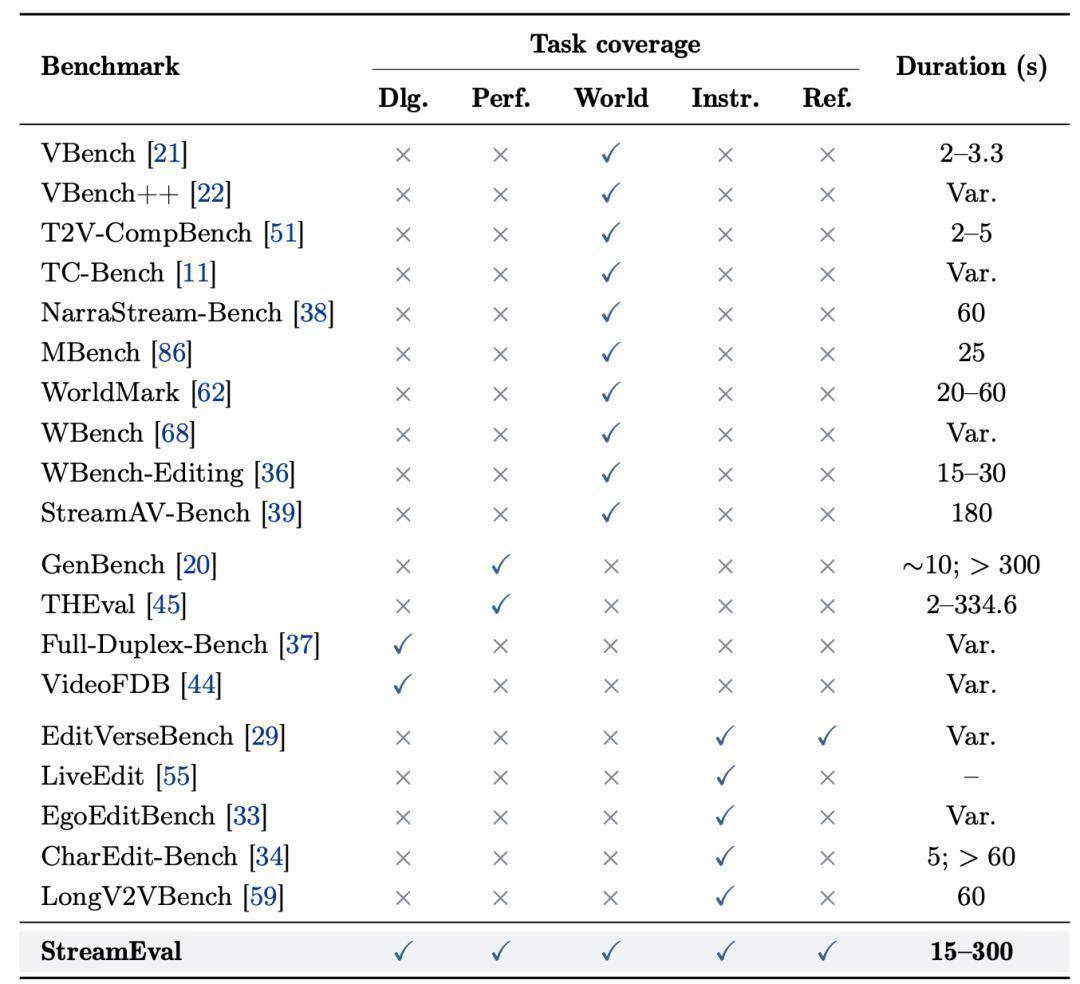
这道"考题"名叫StreamEval,由清华大学、英伟达、卡内基梅隆大学、加州大学伯克利分校、普林斯顿以及新加坡国立大学等多所机构联手打造。它被称作全球首个针对实时交互视频生成模型的专业评测体系,一口气拉来了三十八个主流视频模型同场竞技。

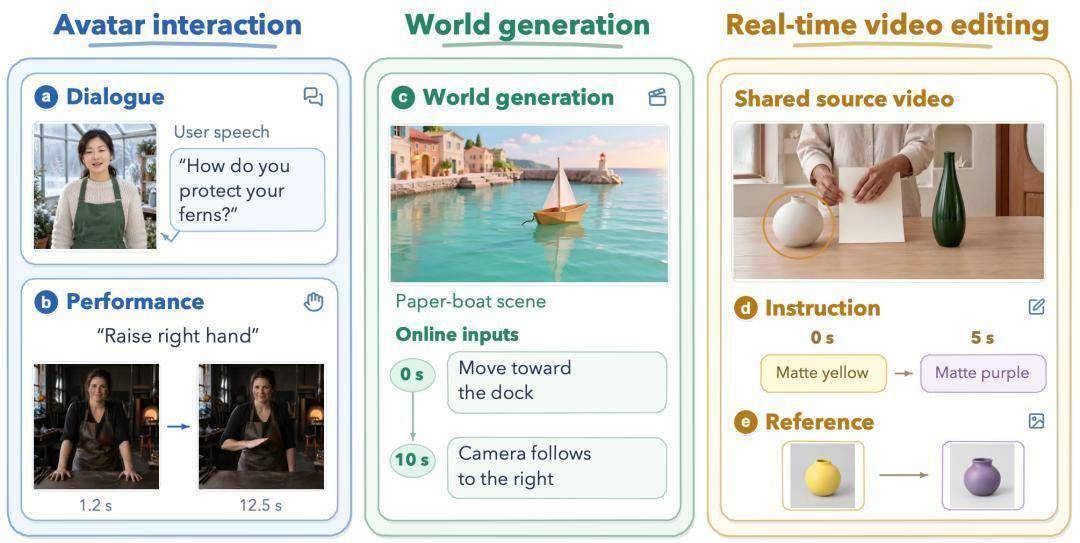
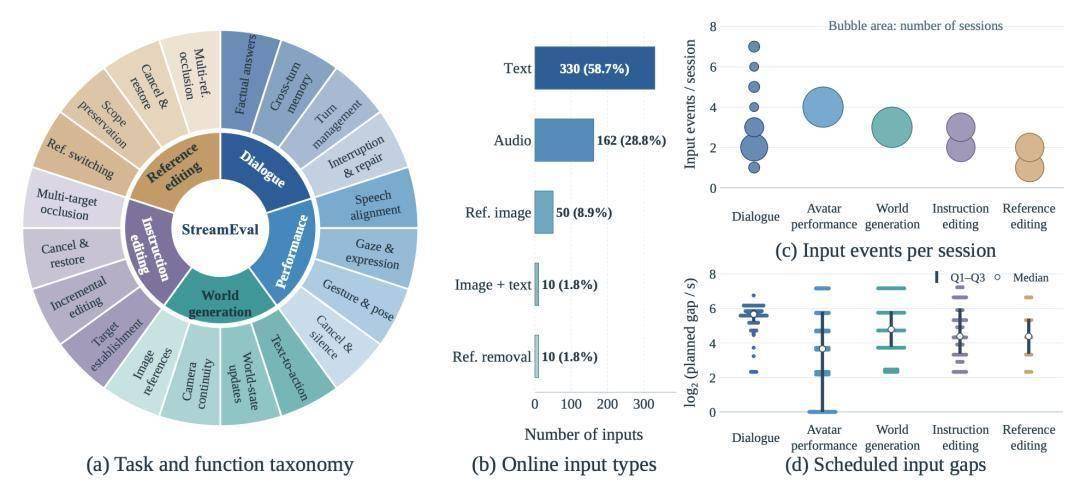
和以往那些"念完指令、播一段成品"的静态测试完全不同,StreamEval的核心是"边聊边改"——评测方按时间轴逐步放出指令,模型没法提前偷看后续题目,只能在线实时响应。整个题库共有三百道题,覆盖数字人对话、虚拟人表演、世界生成、文字指令编辑和参考图编辑五大场景。
打个比方,就像你对着直播中的主播说"换件披风",过一会儿又说"把披风换回来",模型必须记住之前的设定、改对方向、还得保持整段画面的身份和风格不崩。评测从指令执行、状态一致性、视觉质量和音画协调四个维度打分,每项满分一百。
结果有点扎心。几乎所有模型都能在单一指令下交出漂亮答卷,但一旦进入连续多轮交互,画面"失忆"、误读指令、状态错乱等问题就暴露无遗。指令跟随能力成了公认的短板——即便是表现最好的模型之一,此项得分也只有三十多分,远低于音画同步接近满分的华丽数据。换句话说,AI视频"脸长得漂亮",脑子却常常"跟不上节奏"。
当然,这场大考也给了行业一些亮色。在人机对话和虚拟人表演类目中,国内团队打造的Vidu S2-Avatar稳坐头把交椅,动作细腻度和身份还原能力都可圈可点;世界生成赛道则由MemFlow领跑。总体来看,各家模型各有所长,还没有谁能在五大场景全方位碾压。
更有意义的地方在于,StreamEval把代码、测试数据和评分规则全部开源,任何人都能复测、质疑甚至打榜。评测方还承诺榜单会持续更新,向更多模型开放报名。这套"看得见、可验证"的评判标准,恰恰是当前AI视频行业最缺的东西——告别自说自话的营销,用同一把尺子量所有选手。
一边是厂商宣传里的"实时生成""一键换装"满天飞,一边是评测场上连续交互屡屡碰壁。StreamEval的出现,把AI视频这块最亮的招牌掀开一角,也提醒所有人:从"能生成好看画面"到"真能陪你聊下来",中间还有一段不小的路要走。