为什么显存不大,也能把35B跑起来?
关键在一个很多人没注意的机制:卸载(offload)。现在的推理框架不会死磕显存,模型权重不是必须全塞进显存,而是显存放多少、内存补多少。哪层放得下就留在卡上算,放不下的那部分,框架会自动搬到系统内存里接着算。换句话说,模型是被“切开”分摊在显存和内存之间的。
往深里说,35B这类模型之所以能被塞进小显存,还离不开量化。原始模型参数是16位浮点,权重体积大得吓人;用Q4这类量化压一压,体积能砍掉一大半,虽然精度有损,但日常对话、写稿基本看不出差别。量化之后,再配合offload,小显存跑大模型才成了现实。模型加载时还有KVcache、上下文这些额外开销,所以显存永远嫌不够,光靠显卡还不够。
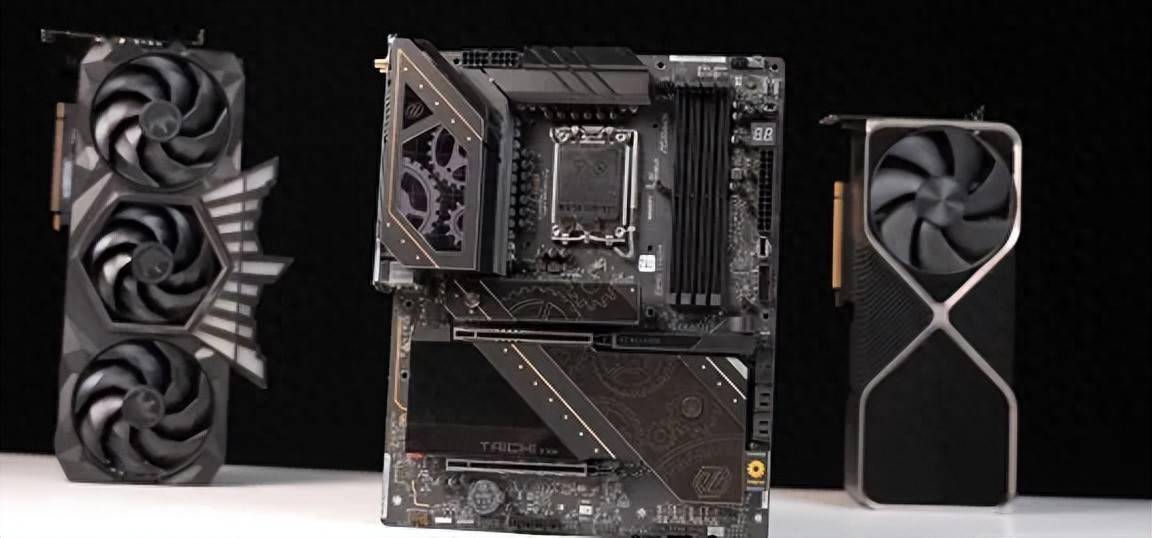
这就带出另一件事:显存不够要靠内存兜底时,CPU和内存的角色一下子就重了。模型加载、预处理、编解码都压在CPU上,而内存容量决定你能喂多大模型。所以本地部署里CPU和内存同样吃重,不是显卡独大。很多人只盯显卡,其实跑大模型时内存容量和带宽往往先到瓶颈。
一个具体的装机例子
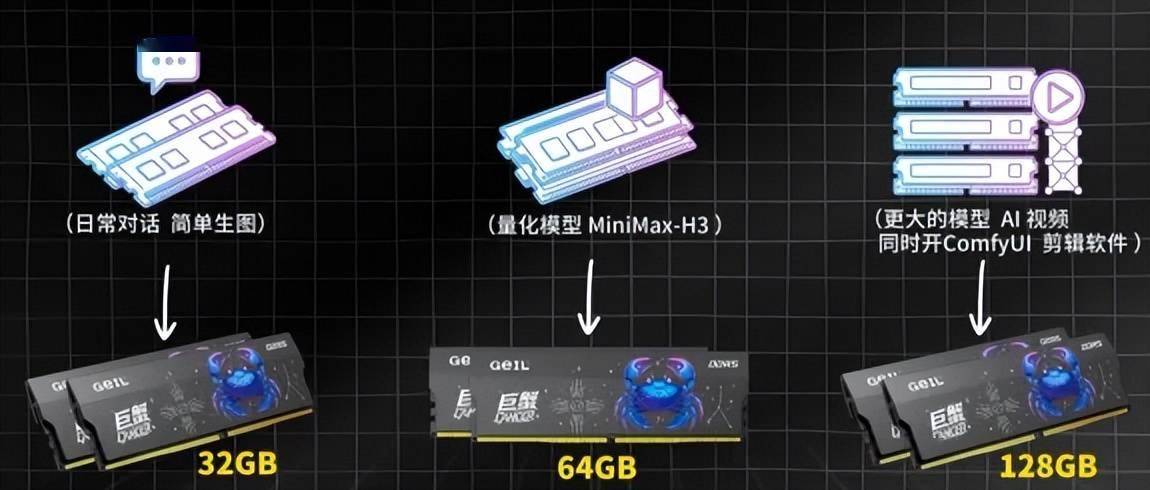
这次实测的平台是一颗IntelUltra9285K,24核,配Z890主板,内存直接上到128GB——用的就是GeIL金邦巨蟹座DDR5大容量套装,单条64GB、两根组成128GB。这条子走无光简约路线,2mm加厚铝合金散热马甲,磨砂表面配机甲图案,主打长时间满载也稳。
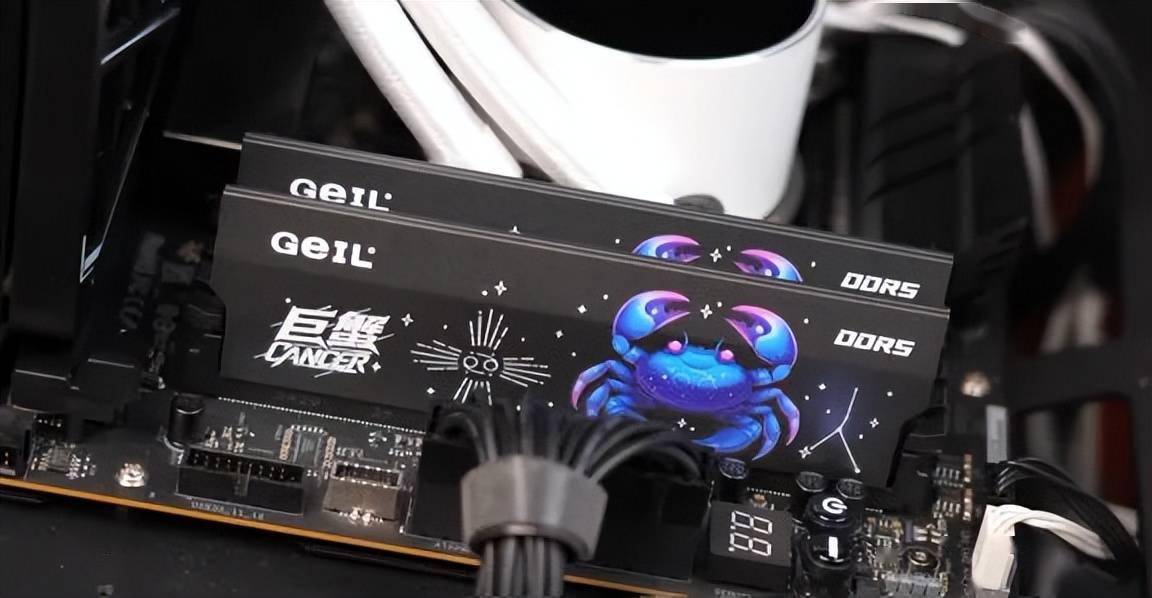
一般会先看内存容量够不够。本地推理一跑几小时,内存马甲不给力,温度一上来就容易掉速报错。GeIL金邦这套巨蟹座无光厚马甲压的就是这个场景,散热实实在在。
GPU实测上了RTX5090(24G)、4090(24G)等都上了。要点很直白:显存越大,offload到内存的比例越低,速度越快;显存不够,就靠多卡把容量堆上去。双卡一上,显存池子大了,模型能更多留在卡上,整体就顺。但即便双卡48G,遇到35B这种体量,大部分权重依然得往内存走,所以内存容量这条线始终不能断。
所以8G显存到底能不能跑35B?实测答案是能,但得接受它跑得不快。这次测试的是阿里开源的稀疏MoE模型——Qwen3.6-35B总参数 35B,主打高性价比的Agent编程与原生多模态理解。它能胜任边界清晰的代码生成、Bug 修复、测试编写、常规文案改写和图文 / 视频理解,产出经人工审核后可直接投入日常开发与内容工作流,这类MoE架构,每轮推理实际激活的参数大约只占三成,剩下的权重靠内存接着扛。显存只有8G时,绝大部分权重得offload到那128GB内存里,token速度自然比纯显存方案低一截。显存爆了,推理直接崩;内存够,至少能跑起来。
可以把它理解成:显存是高速公路,内存是国道,高速不够宽时多走段国道照样能到,只是慢点。所以更准确地说,显存决定跑多快,内存容量决定能不能跑。那128GB内存,就是让8G显存也能把Qwen 35B跑通的那块兜底。
同一条 128GB 内存的机器上,我们还跑了 MiniMax H3 的文生图和文生视频。和单纯的语言模型不一样,它支持文生视频、首尾帧、多素材参考(人物、镜头、动作、音色复用)与跨模态编辑,指令遵循、画面文字和品牌呈现能力较强。图像、视频这类多模态生成在过程里,除了模型权重要常驻内存,还得同时压着潜空间特征图、逐帧的中间结果和临时缓存,对显存和内存的胃口比纯对话模型更狠。显存一吃紧,权重和中间量照样往内存里offload,所以到底跑不跑得动,最后还是系统内存说了算。
实测下来,这台128G内存的机器跑MiniMax H3是稳的:文生图批量出图不卡顿,文生视频也能拉到比较长的时间线,整个过程没有因为内存爆掉而中断。显存那张24G的卡主要负责实时算力和出图,多模态模型里塞不下的权重和中间帧,还是老办法offload到内存里接着跑——和跑Qwen 35B是同一套逻辑。
不管是Qwen 35B这样的语言模型,还是 MiniMax H3 这类文生图、文生视频模型,本地部署吃的都是同一套内存底子——容量到位,玩法才多。这也正是GeIL金邦巨蟹座64GB×2这套128GB套条在这套装机里存在的意义:它兜住的不只是一个大模型,而是一整条本地创作的工作流。
模型在内存里算,速度很大程度取决于内存带宽。单通道和双通道差距明显,两根组双通道比一根大容量单条更划算——同样128GB,2×64GB比1×128GB吞吐高不少,本地推理尤其吃带宽。

想自己搞本地部署,硬件优先级怎么排
内存容量得先保够。日常对话、32B量化模型,64GB级别基本够用;要跑35B或推理剪辑同时开,128GB才踏实。内存不够,模型直接加载失败。CPU不能太弱,核多、内存控制器稳,加载预处理才不拖后腿。显卡显存往后排,预算有限先把内存和CPU配够,显卡后期加更划算。
对准备上大容量内存的朋友,金邦巨蟹座这种64GB×2的DDR5套条是一个不错的选择——单条64G容量管够,无光厚马甲压得住长时间满载,组128GB也方便,双通道一带,本地推理和剪辑都能稳稳跑。容量到位了,模型跑起来才不慌。