你有没有过这种经历:
手机里的 AI 助手,你问它才答,你不问它就跟死了一样。你忙得脚不沾地,它安安静静;你刚躺下准备睡觉,它突然弹个提醒。
这不是智能,这是你按一下它动一下。
真正的智能应该是什么样?最近有篇 203 页的论文,专门研究这个问题。作者阵容挺吓人——谷歌、伊利诺伊大学香槟分校、斯坦福、加州大学伯克利分校、卡内基梅隆大学,五家机构联合发布。
论文名字叫《Proactive AI for Superintelligent Agents》,翻译过来大概是面向超级智能体的主动式 AI。
我把这篇啃完了,挑出 5 个最值得普通人知道的提醒。
203 页实在太长,我顺手做了个 HTML 页面,把核心结论摆在一屏里,看着不累。
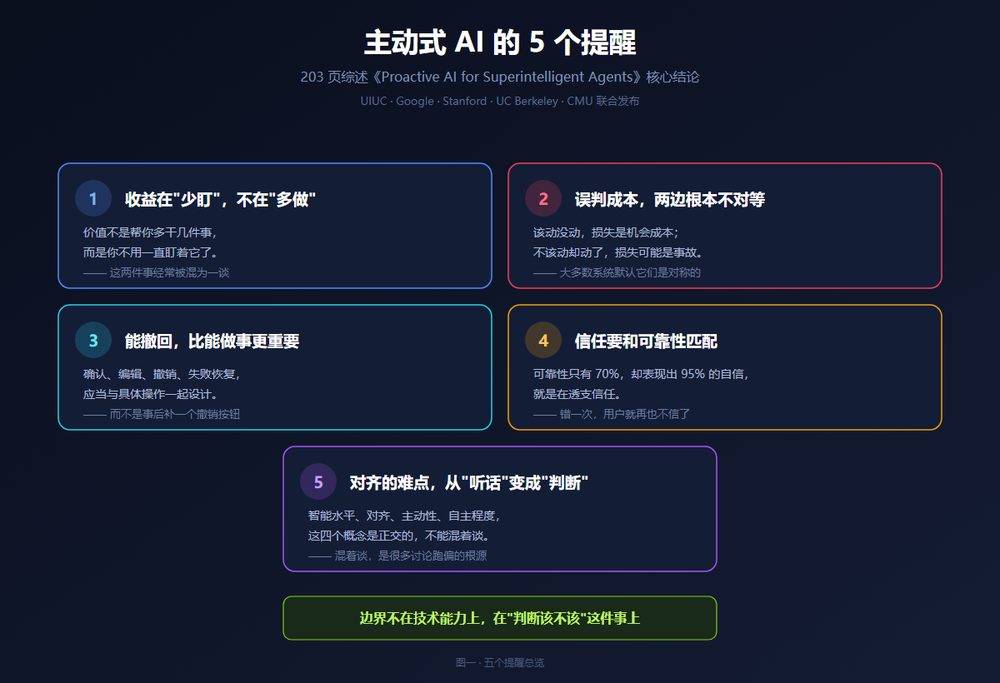
图一 · 五个提醒总览
先看个例子:机器人收拾厨房
论文里有个例子特别妙。
你对机器人说:把厨房收拾干净。
这句话说清了目标,但没说清步骤。餐具架满了,得先腾地方;有个东西不知道是干嘛的,得问一句能不能挪;洗碗机里的碗还没干,得先放着。
这些指令里没写、但必须处理的部分,论文称为剩余决策空间。
传统系统碰到这种情况会怎么办?停下来等你补充指令。
但现实中你不可能把所有细节都交代清楚。尤其是那种要连续干几小时、几天甚至更久的活儿——人根本没法提前把所有步骤想完。
这就是主动性要解决的问题。
提醒一:好处不在多做,在少盯
很多人以为 AI 主动就是帮你多干几件事。
论文说得很克制:主动式 AI 的价值,在于它有没有在合适的时候提供了值得接受的帮助,并且能不能减轻人类持续关注的工作负担。
注意后半句。价值不是多做,是"你不用一直盯着了"。
你想想,一个一天给你发 40 条通知的助手,和一个一天只发 3 条但每条都有用的助手,你要哪个?
提醒二:误判的代价,两边根本不对等
该动手时不动手,损失是本来能省的时间没省下来。
不该动手时动了手,损失可能是事故——发错的邮件、提交错的订单、改错的生产配置。
这两者根本不对称。但大多数系统的设计,默认把它们当成对称的。
论文举了个例子:陌生账户访问服务器。可能是正常维护,也可能是账号被盗。补查一下记录,或者问一下负责人,判断可能就变了。但如果系统二话不说直接封禁,正常业务就受影响了。
所以它要做的不是一发现异常就动手,而是先评估证据够不够、动手的代价大不大,再决定怎么办。
提醒三:能撤回,比能做事更重要
论文里有句话我划了重点:确认、编辑、撤销和失败恢复,应当与具体操作一起设计。
注意一起设计这四个字。
现实里大多数系统是反的——先把功能做出来,再想要不要加个撤销。结果就是有些操作天然不可撤回:发出去的邮件、提交的订单、改掉的生产配置。
还有个细节特别真实:文字提醒太长,人根本不想看;机器人突然伸手,旁边的人判断不出它要干嘛。
所以界面里的预览、动作前的提示,不是装饰,是必需品。
提醒四:信任要和可靠性匹配,别透支
论文在讲反馈适应的时候提到一个很微妙的问题:助手可以提高建议接受率,但同时也增加了依赖。推荐系统可以提高点击率,却会收窄用户接触的信息范围。
然后它给了一句很克制的话:信任应当与系统的可靠性相称。
反过来读更有意思:如果你的系统可靠性只有 70%,那它表现出 95% 的自信,就是在透支信任。
这在产品设计上是个很实在的提醒。我们总想让 AI 显得很懂,但过度自信的代价是,一旦错一次,用户就再也不信了。
就像那个喊狼来了的孩子。
提醒五:对齐的难点,从听话变成了判断该不该
传统上我们关心的是:AI 听不听话、会不会做坏事。
但主动性引入了一个新问题:它能不能自己发现该做什么。
论文把四个概念明确区分开了:
智能水平——理解、推理、解决问题的能力。
对齐——行为符不符合人的意图、价值和约束。
主动性——能不能自行发现并发起有价值的行动。
自主程度——人允许它独立走到哪一步。
这四个是正交的。一个特别听话的 AI,可能完全不会主动;一个特别主动的 AI,可能完全不听话。
把它们混在一起谈,是很多讨论跑偏的根源。
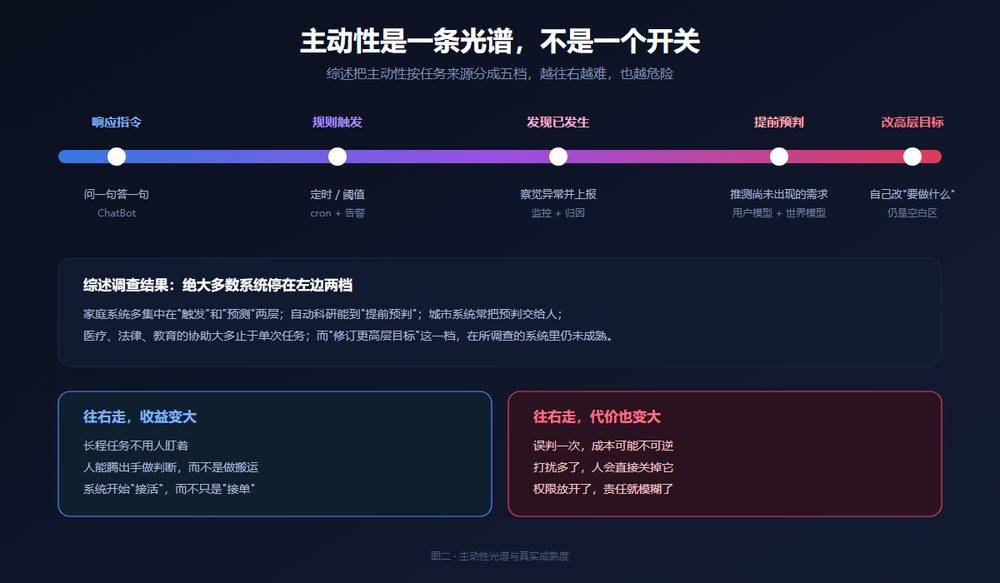
图二 · 主动性光谱与真实成熟度
一个扎心的数据:13 个领域的真实成熟度
综述覆盖了 13 个领域。按主动程度排了个阶梯:响应指令 → 发现已出现的情况 → 提前预测需求 → 在持续委托下寻找工作 → 修订更高层目标。
结果是这样的:
广泛部署的家庭系统,大多停在第一、二档(触发和预测)。
自动科研系统能到第三档(在给定方向下探索假设和实验)。
城市系统经常把预测这一步交给人处理。
医疗协助常止于一次诊疗,法律协助常围绕已经提出的问题,教学协助常限于当前活动。
第五档(自己改要做什么)——在所调查的系统里,仍然是空白。
换句话说,市面上号称主动的系统,绝大多数还停在到点提醒和发现异常这两档。
真正能自己判断这件事值不值得做的,极少。
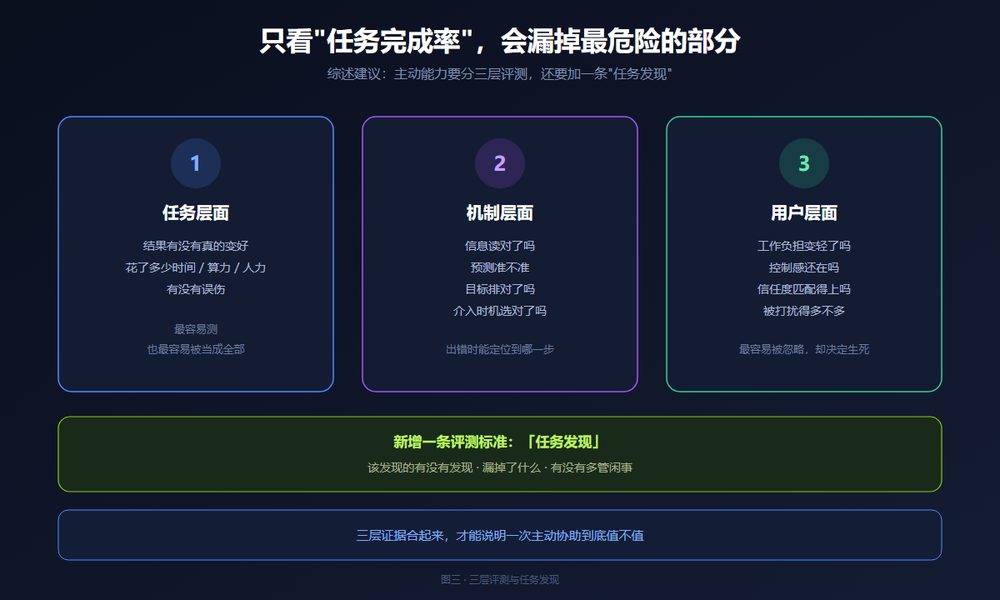
图三 · 三层评测与任务发现
说点实在的:这东西离我们有多远
看完这篇我最大的感受是——我们离真正的主动式 AI还有段距离,但方向已经很清楚了。
现在能用的,基本都在发现异常 + 提醒这一档。想再往上走一步,卡在两个地方:一是判断力(该不该动),二是可撤回性(动错了能不能收回来)。
我平时折腾这类工具,会拿 AiPy 先跑一遍流程试试水。它比较适合把一堆零散的步骤串成一条任务流,跑完还能看到每一步干了什么——这个能看到每一步其实挺关键的,因为论文里反复强调,可靠的工作记录是扩大授权的前提。你先看它跑得稳不稳,再决定放多少权限给它,这个顺序不能反。
另外还有个现实问题:安全。
论文提到,网页、邮件或文件里的恶意内容,可能诱导 AI 提出未经授权的新任务。这是个很现实的风险——你的 AI 在读取外部内容时,那些内容里可能藏着指令。
还有一个更日常的问题:确认弹窗太多,人会无脑点"是"。论文专门警告了这一点,说审核入口要让人看得懂、用得上,避免连续的确认请求使监督流于形式。
这个我深有体会。有些软件一天弹八次是否允许,到第八次你根本不会看内容了。
所以现在我自己搭这类小流程的时候,会先用 AiPy 跑一遍看它到底会不会乱来——它有个好处是每一步都留痕,跑完能倒回去看是哪一步判断偏了,而不是只给你一个最终结果。这种能复盘的感觉,比看起来聪明重要得多。
写在最后
论文用了一个词概括所有这些问题的设计目标:calibrated proactiveness,可以译成校准过的主动性。
意思是:根据证据、时机、风险、偏好和权限,去调整主动行为。发现该做的事之后,可以准备、可以建议、也可以执行;情况变了,也要能改计划、停手,或者把决定交回给人。
所以我的结论是:主动式 AI 的边界,不在技术能力上,在判断该不该这件事上。
能做的事越来越多,但知道什么时候不该做,才是真正稀缺的能力。
这话放在人身上,好像也成立。