研究员|王晨
国产GPU领域,迎来新的万卡级算力需求。
10月31日,摩尔线程、惠山招商集团与国内L4级自动驾驶无人车头部企业新石器签署战略合作协议,依托无锡(惠山)国产智算中心,推动更大规模的自动驾驶模型训练。
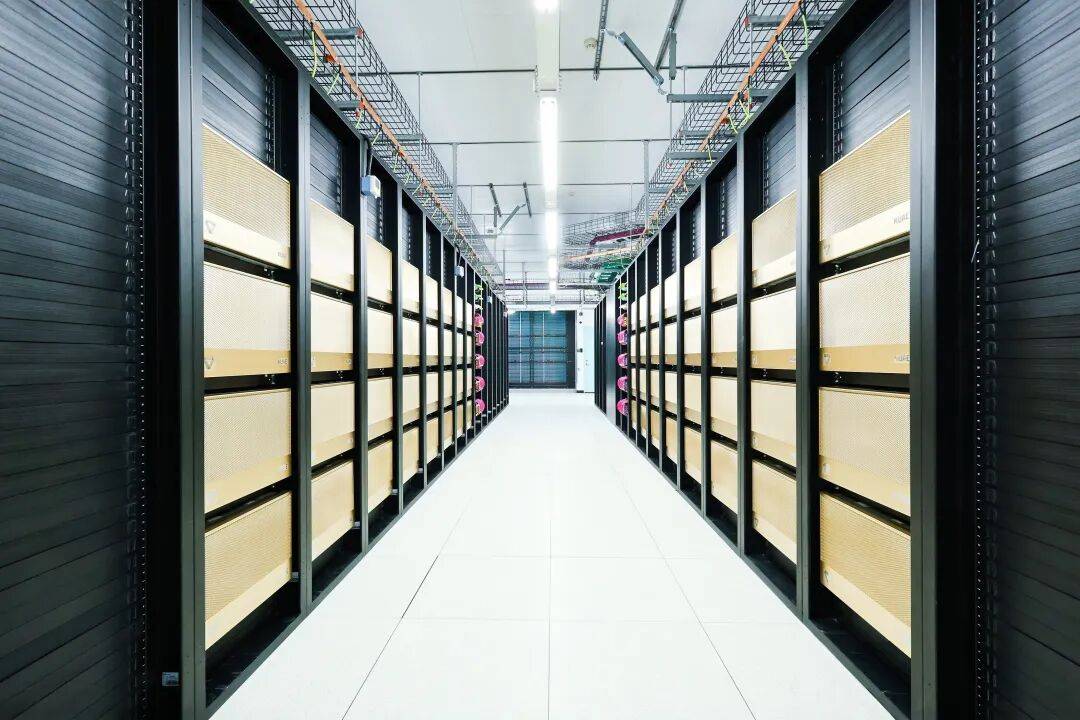
无锡(惠山)国产智算中心一期
摩尔线程称,这座以其全功能GPU为算力底座的中心,一期2000卡于今年6月点亮后,投运仅3个月即实现满载运行。新石器已基于摩尔线程AI训推一体智算卡MTT S5000,在该智算中心进行自动驾驶模型训练验证,算力需求接近万卡级。
不难看出,自动驾驶等物理AI应用,正在为国产GPU拓展了新的算力需求。
与此同时,摩尔线程现有智算业务的商业化也在加速。10月28日发布的三季报显示,公司第三季度营收15.52亿元,同比增长1773.92%;扣非归母净利润2007.24万元,首次实现单季扣非转正。收入规模扩大与单季扣非转正,表明摩尔线程的商业化进展正进一步转化为经营成果。
现有智算产品正在加速兑现经营成果,自动驾驶等物理AI应用则带来了进一步扩大业务的机会。对于刚刚跨过单季扣非盈利节点的摩尔线程来说,物理AI不是摩尔线程的“新战场”,而是全功能GPU能力天然对应的核心市场。如今自动驾驶的万卡级需求集中显现,意味着这个市场已从潜力变为现实。
01
收入加速增长
单季盈利之后还要看什么?
1773.92%的单季同比增幅醒目,但观察摩尔线程的增长,还需要把时间拉长一些。
财报数据显示,摩尔线程前三季度收入由上年同期的7.85亿元增至32.89亿元,同比增长319.15%。第三季度的高增幅虽然建立在较低基数上,累计收入规模的扩大,显示出业务增长的强劲动能。
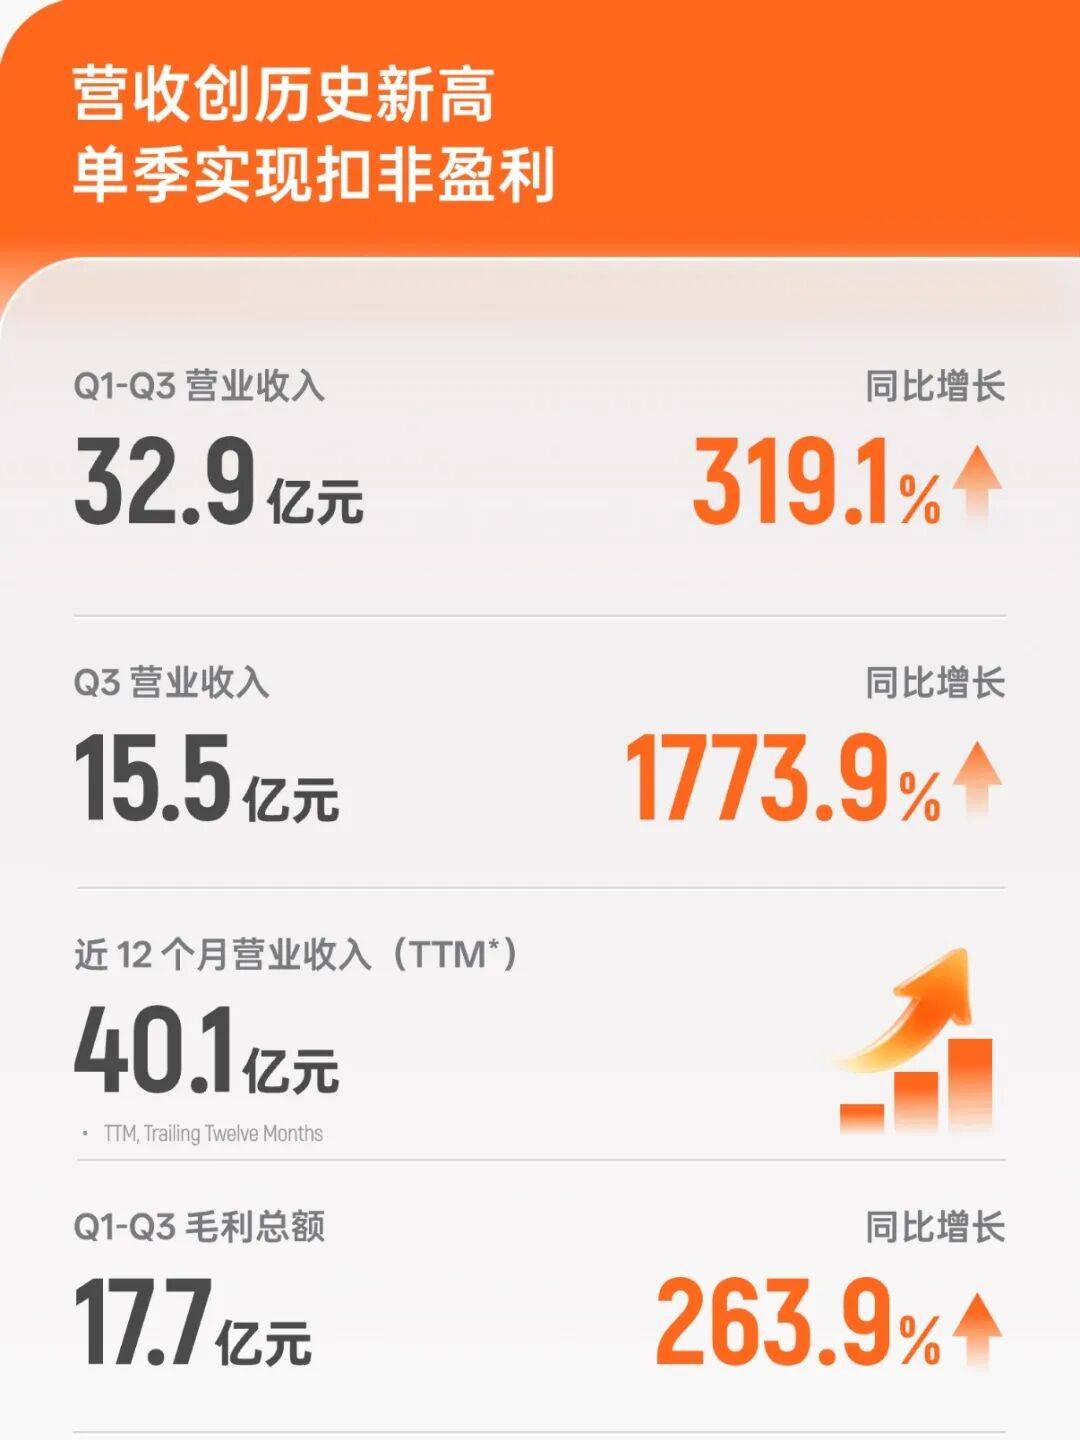
摩尔线程收入规模扩大,单季扣非转正。
公司在三季报中将增长归因为人工智能产业对算力及全功能GPU的需求增强,并称以MTT S5000为代表的智算产品,正加速进入互联网及云服务商、词元服务商、AI创新企业、运营商、智算中心等客户。
收入扩大带动了利润的改善。上半年,公司归母净亏损1156.31万元;第三季度单季归母净利润4926.04万元,使前三季度累计归母净利润转为3769.73万元,实现前三季度归母净利润扭亏为盈。
与此同时,摩尔线程在继续扩大研发投入。前三季度公司研发投入13.40亿元,同比增长55.72%;第三季度单季投入5.71亿元,同比增长87.89%。三季报称,公司正在围绕新一代全功能GPU“花港”架构产品等项目加快研发进度。
研发投入继续增长,单季扣非利润仍实现转正,这是这份财报中值得关注的信号。芯片迭代、软件适配和生态建设都需要持续投入,收入规模扩大,正在增强摩尔线程支撑这些投入的能力。
公司此前在IPO招股说明书中预计,最早于2027年实现合并报表盈利。此次季度层面的突破,是迈向持续盈利的一个阶段性进展。下一步,除了现有产品能交付多少,还要看已有技术能够进入多少新的应用场景,而物理AI正是摩尔线程积极布局的方向之一。
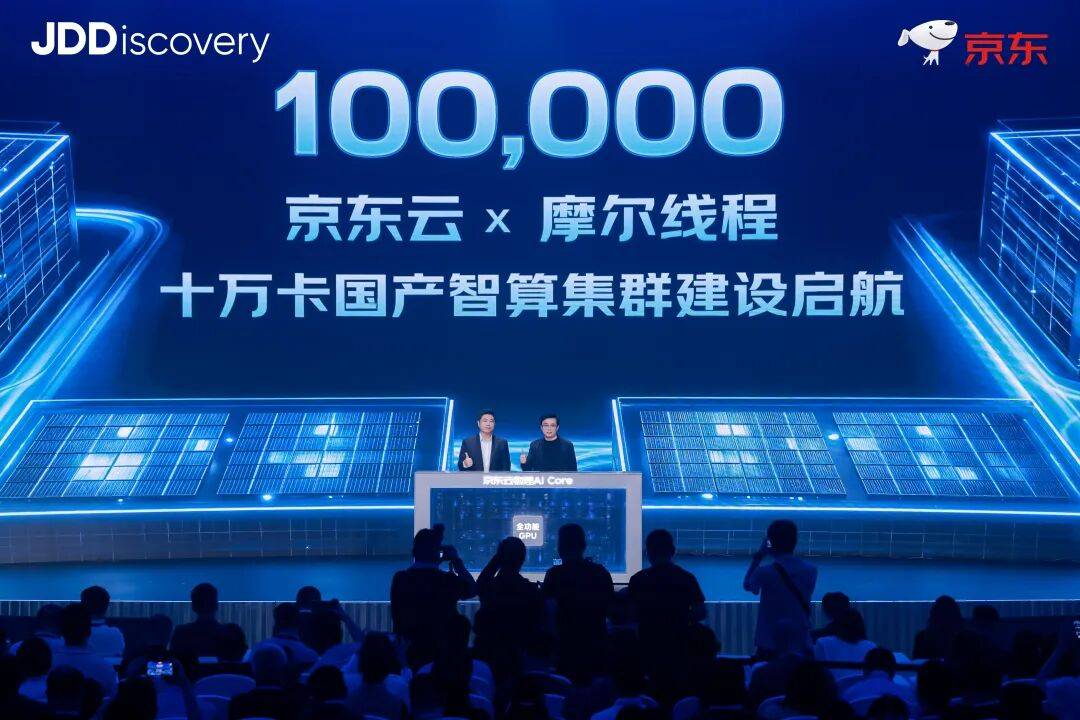
9月初,京东云宣布拟建设十万卡全功能GPU集群,该集群将以摩尔线程全功能GPU为算力底座,面向大模型训练、推理及具身智能等应用场景。
这一规划与摩尔线程此前提出的三大AI工厂布局形成呼应,在模型训练和推理之外,机器人等物理世界应用把仿真、渲染、控制执行与数据生成也拉进同一算力闭环——而这正是全功能GPU在统一架构下“算、渲、仿”协同的优势所在。
从惠山的新石器合作,到京东云的集群规划,物理AI带来的增量算力需求,在具体客户合作与集群规划中显现。对摩尔线程而言,这一趋势的积极意义在于,公司长期积累的AI计算、图形渲染和软件能力,迎来了更广阔的商业化空间:既有产品可以从模型训练进一步拓展至仿真、数据生产等环节,承接同一客户的更多任务,也进入新的行业市场。
在现有智算业务加速兑现收入与利润的基础上,这种技术积累与新增需求的契合,为摩尔线程继续扩大业务规模提供了新的动力,也让物理AI成为其培育第二增长曲线的重要方向。
02
物理AI为何要图形与计算的协同?
对于AI在物理世界的交互而言,让机器人抓起一个杯子,只是起点。
当AI从生成内容走向执行现实任务,决定应用价值的因素也随之变化。机器人完成一次抓取,距离它在不同工厂、面对不同物体时稳定完成任务,还有大量训练和验证工作。自动驾驶系统同样需要应对不断变化的道路、天气与交通参与者。
这使数据采集和反复验证成为物理AI扩大应用的重要成本。相比高成本的真机采集,虚拟环境不仅便宜,还能在危险及复杂场景中重复采集数据。因此,虚拟环境测试已经进入不少物理AI企业的实际研发流程。
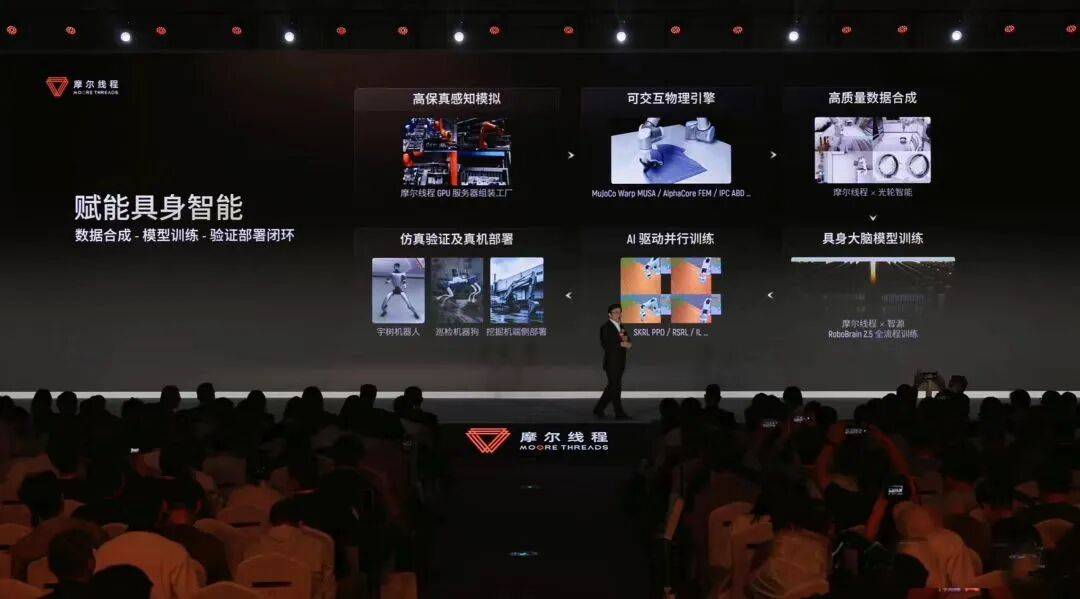
2026年5月,摩尔线程推出首个全栈国产化具身智能仿真平台MT Lambda。
以机器人运动控制训练为例,Figure今年1月介绍Helix 02时披露,其负责全身平衡与协调的底层控制器,在超过20万个并行仿真环境中训练。这类任务将现实中的反复试验,转化为可以并行运行的计算负载。
从更完整的物理AI开发流程看,这些负载不只涉及AI计算。模型训练与策略优化需要AI算力,用于学习数据、更新模型;让机器人“看到”虚拟场景,也需要渲染光照、材质、遮挡和几何细节,生成视觉观察;模拟抓取、行走时的碰撞与摩擦,则需要物理计算,为动作提供反馈。仿真环境生成观察和反馈,训练系统据此更新策略,再回到不同场景中验证效果,三类任务由此相互衔接。
这也为兼具图形渲染与通用计算能力的GPU打开了新的应用空间。客户需要的算力,既用于训练模型,也用于生产训练数据、检验模型表现。随着更多研发工作在虚拟环境中展开,GPU能够参与的环节随之增加。摩尔线程长期坚持的全功能GPU路线,恰好契合这一类客户的需求。
支撑这一能力的,包括摩尔线程在图形侧的长期积累。公司在推出数据中心AI加速卡的同时,持续布局消费级图形处理器,已推出S80等消费级图形显卡,在驱动、渲染技术和应用适配方面积累经验。这些图形产品研发与软件适配经验,与AI计算能力相结合,为摩尔线程拓展物理AI应用奠定了坚实的基础。
不过,企业采购时算的是整笔账。
更换算力平台,涉及已有模型、仿真工具和工作流程的迁移。代码改造需要多少人力、训练结果是否需要重新验证、系统调优会不会拖慢项目进度,都会影响最终选择。硬件性能和价格之外,这些工程成本同样决定企业是否愿意采用新的平台。
摩尔线程推出的MT Lambda具身智能仿真平台,便是在全功能GPU和MUSA软件栈之上,连接物理仿真、图形渲染和AI训练,将前述多类计算任务纳入统一的开发流程。随着适配工具和工程经验积累,企业采用国产GPU的额外成本才有机会下降,全功能路线也才能进一步转化为商业竞争力。
03
从模型到场景,
如何扩大物理AI朋友圈?
让我们把眼光放回惠山智算中心:据摩尔线程披露,包括新石器在内,该中心已有20余家客户开展测试或正式业务,训练业务占比超过62%。
同期,摩尔线程也在积极推进与多家具身智能领域的模型研发机构、仿真软件企业的合作。
在模型训练端,摩尔线程联合北京智源人工智能研究院,基于MTT S5000千卡智算集群与FlagOS-Robo框架,已完成RoboBrain 2.5具身大脑模型的完整端到端训练与对齐验证。北京大学EvoPhys团队也在S5000上完成了EvoPhys-World世界模型的原生全流程训练。
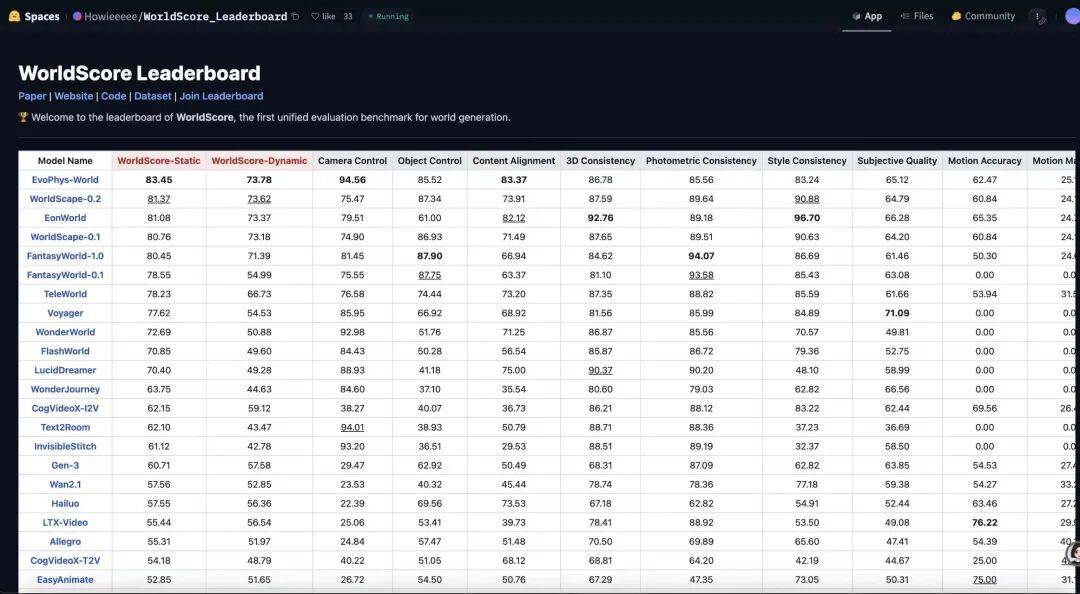
WorldScore实时榜单:EvoPhys-World 位列第一。
围绕物理模型训练所需的数据,摩尔线程还与光能智能开展了合作。光轮提供物理求解、仿真资产和数据生成工具,摩尔线程提供GPU及夸娥集群。据双方披露,光轮的物理求解器已适配MUSA架构。摩尔线程的GPU因此有机会从训练模型,进一步进入生产训练数据的环节。
在智能驾驶领域,五一视界SimOne 4.0已完成在S5000上的适配与优化,覆盖4DGS动态场景重建模型的训练、仿真推理和合成数据生成。
这是一条清晰的业务延伸路径:用已在智算市场交付的产品,承接新的物理AI需求,再通过软件适配和项目经验的复用,扩大应用范围。它也构成了看好摩尔线程后续增长的一个具体理由——现有业务正在兑现经营成果,长期积累的图形与计算能力,又迎来了新的商业化空间。
物理AI最终能带来多少新生意,还需要持续采购和交付来回答。但从2000卡满载运行,到万卡级扩容,惠山已经提供了一个可以跟踪的增长线索。随着更多项目从验证走向规模化使用,物理AI有望在摩尔线程现有智算业务之上,逐步形成新的增长来源。
(文中内容和观点仅供参考,不构成投资建议。投资有风险,入市需谨慎。)
编辑|王晓