距离 11 月 20 日,只剩最后两周。
11 月 3 日,Menlo Ventures 发布的《2026:企业 AI 现状报告》给出了一组值得所有技术决策者重新审视 2027 年的规划数字。截至 2026 年 9 月,其估算的企业 AI 部署支出已达 1768 亿美元,较上一年增长 5.4 倍。在 OpenRouter 的样本中,Agent 已消耗 80% 的 Token,约为人类直接使用量的 7 倍,企业在使用 AI上的投入,已经达到构建模型投入的 1.7 倍(扫文末二维码领取报告pdf)。
这意味着,企业 AI 的主问题正在发生变化,不再只是「是否要用 AI」,而是预算应该投向模型、Agent、应用还是基础设施?哪些能力需要自建,哪些可以采购或合作?当 Agent 以机器速度并行工作,现有研发体系、数据系统和治理机制能否接得住?
报告还发现,企业年初计划将 AI 支出提高至上一年的 1.9 倍,实际却升至 4.7 倍,相当于花掉了原预算的 2.5 倍。需求高速增长固然是积极信号,但对于 CTO、技术 VP、研发负责人和 AI 平台负责人来说,这也意味着如果没有清晰的技术路线、成本模型与治理边界,AI 投入越快,预算失控与重复建设也可能来得越快。
这正是由 CSDN 与奇点智能研究院联合主办的「2026 奇点智能技术大会」与「2026 C++ 及系统软件技术大会」希望在年末集中回答的问题。
11 月 20—21 日,70+ 位来自 OpenAI、腾讯、阿里云、蚂蚁、百度、小红书、字节、小米、京东、亚马逊云科技、上海人工智能实验室,以及高校、科研机构和开源社区的一线研究者与工程实践者,将围绕模型、Agent、研发范式、AI Infra、C++ 与系统软件展开分享。
这不是一份简单的日程罗列。我们从两场大会中筛出五条技术路线,把它们对应到技术管理者正在面对的五个关键决策:
- 下一代模型能力,究竟来自继续 Scaling,还是数据、强化学习与自进化闭环?
- Physical AI 值得在今天押注哪些能力,又有哪些长周期基础设施必须提前建设?
- AI Coding 如何从个人提效升级为可度量、可治理的组织生产力?
- Agent 怎样真正进入核心业务,并建立可验证的 ROI 与责任边界?
- 当 Agent 并发与推理成本持续上升,哪些 AI Infra 与系统软件必须优先重构?

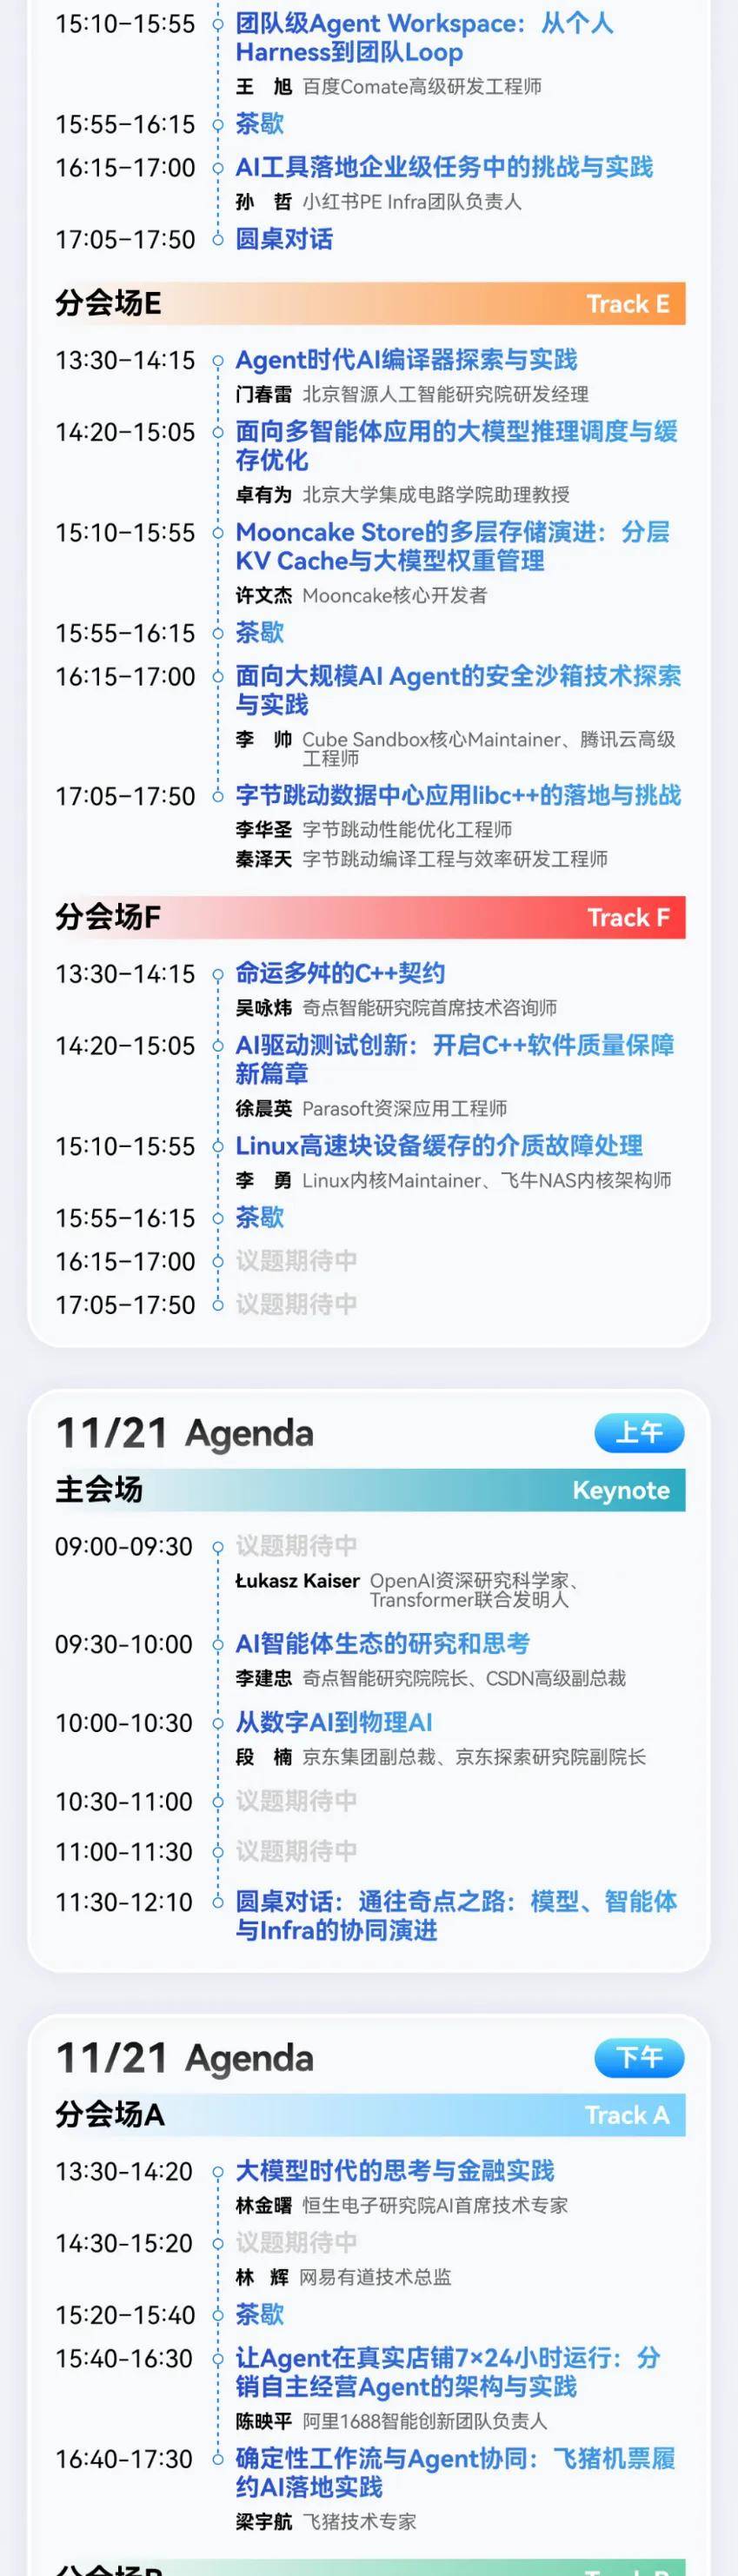
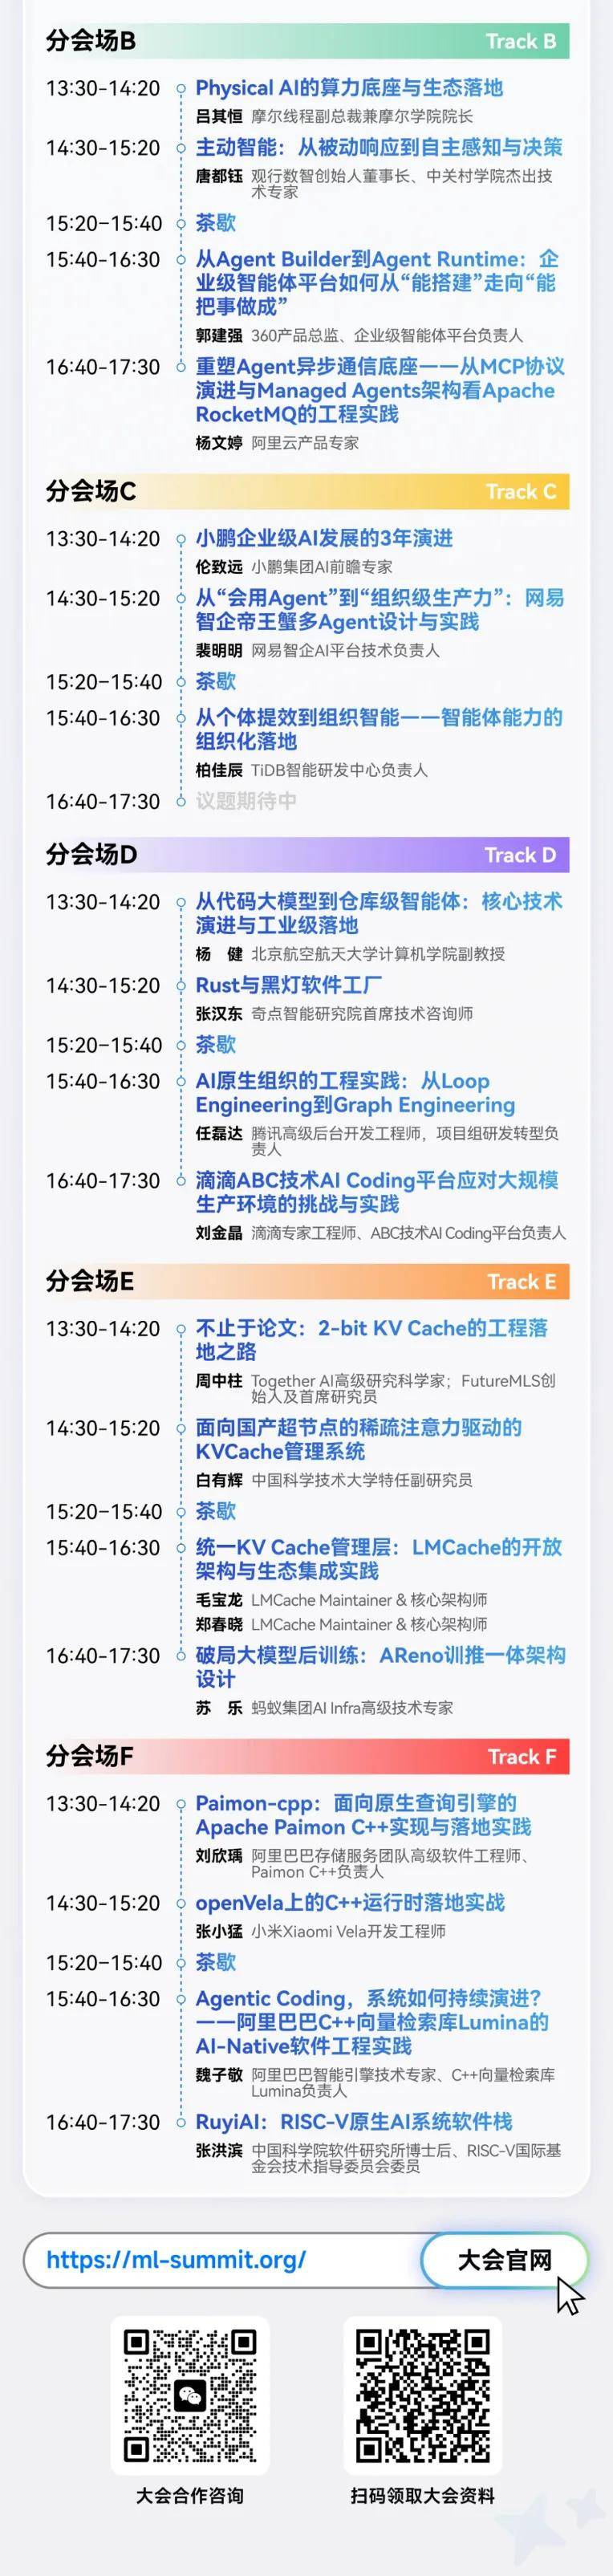
下面这五条路线,既是参会选题指引,也可以作为企业制定 2027 年 AI 技术规划的一张决策地图。
路线一:从 Agentic Scaling 到自进化,AI 开始参与下一代 AI 的构建
在 Benchmark 被不断逼近的情况下,我们不禁思考,模型的下一条增长曲线会出现在哪里?
一个越来越清晰的答案是让 Agent 参与数据生成、评测、训练与系统优化,让模型从真实反馈中持续学习,甚至让 AI 开始参与下一代 AI 的研发。
根据报告显示,采用后训练的 AI 构建者比例已从 6% 升至 10%,其中 91% 会借助外部合作伙伴完成相关工作。这个变化对技术负责人提出了一个现实问题,即企业究竟应该自建模型能力,还是围绕数据、评测、Harness 与行业反馈构建自己的差异化闭环?
在 2026 奇点智能技术大会「大模型技术:从 Agentic Scaling 到自进化」专题中,我们邀请了 12 位来自模型研究、强化学习、推理系统、Agent Harness 与产业实践一线的专家进行主题分享。
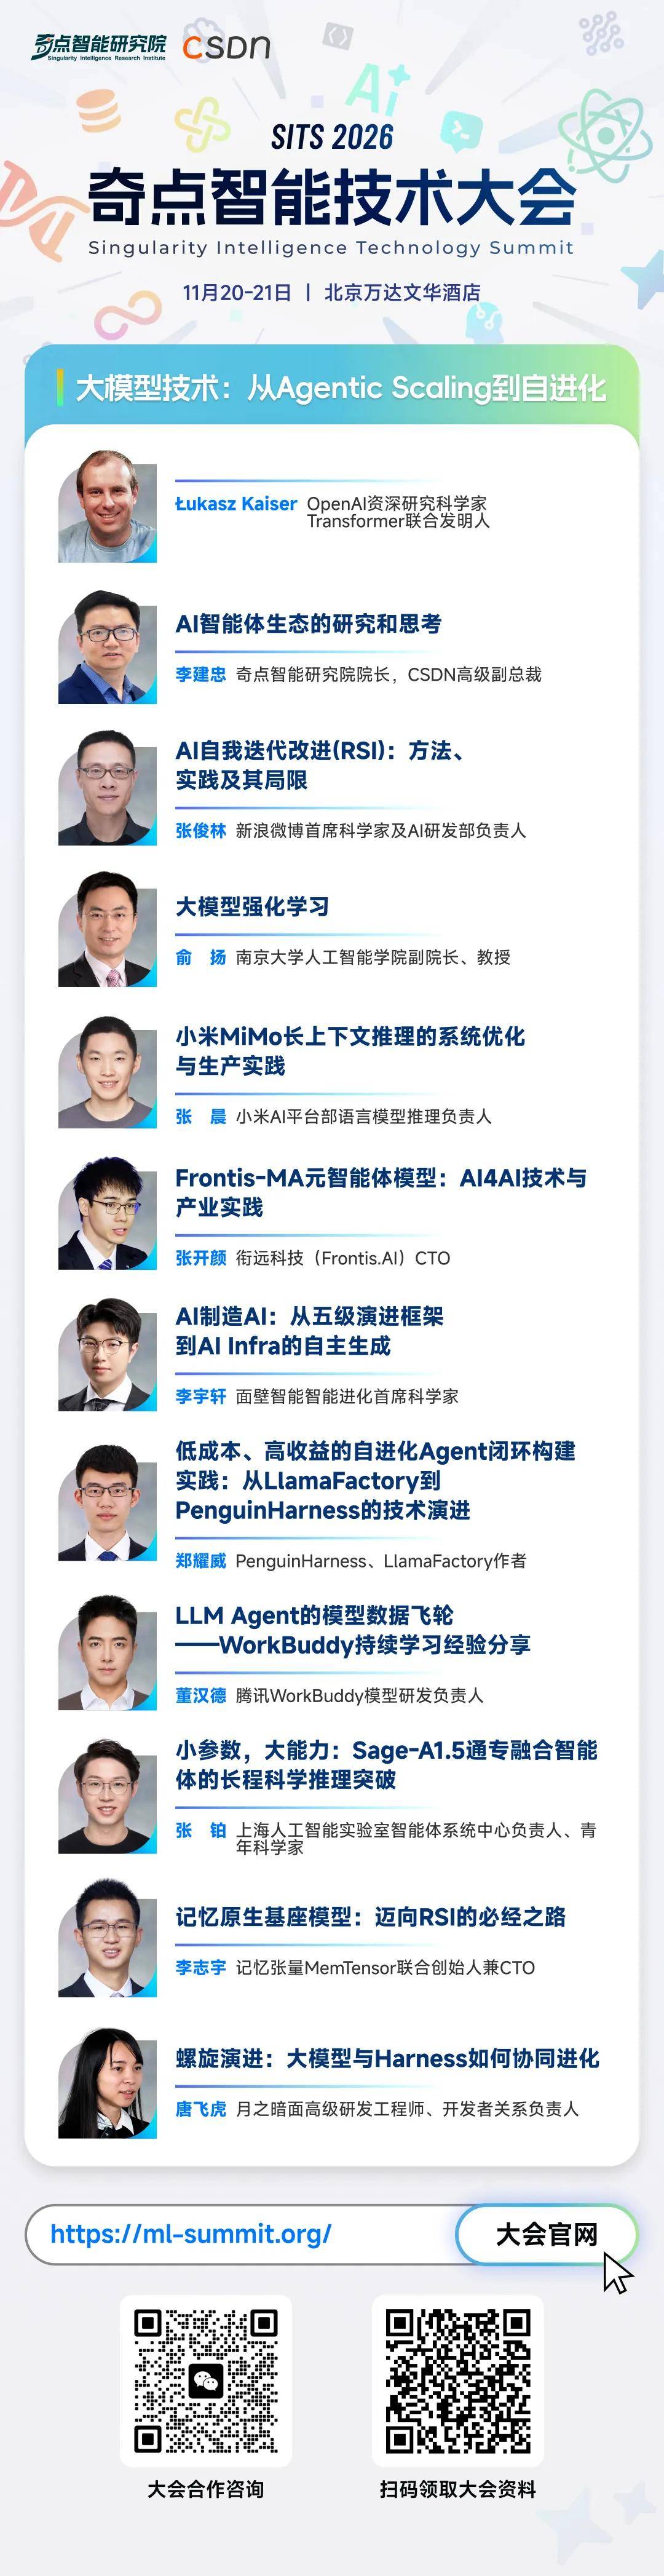
从大模型强化学习、RSI 与持续学习,到 AI4AI、记忆原生模型、数据飞轮和 Harness 演进,这 12 场分享共同回答的是当传统 Scaling 的边际收益逐渐下降,AI 能否通过任务、环境与反馈找到持续进化的新路径。
对技术决策者而言,这条路线的价值不只是判断“下一个模型会有多强”,而是厘清企业应该把壁垒建在哪里?是训练与后训练能力、专有数据、评测体系、持续学习闭环,还是能够将多种模型能力快速接入业务的工程平台。
路线二:从数字 AI 到 Physical AI,模型如何真正进入物理世界
机器人可以生成令人惊艳的视频,但在真实环境中,它仍要面对物体接触、动作误差、环境变化和安全边界。
Physical AI 的难点不只是再训练一个更大的模型,而是如何让本体、数据、世界模型与算力底座形成闭环。
本专题将从模型、本体、数据、世界模型、算力底座与多机协同等不同层面,拆解 Physical AI 从技术探索走向真实世界的关键环节。
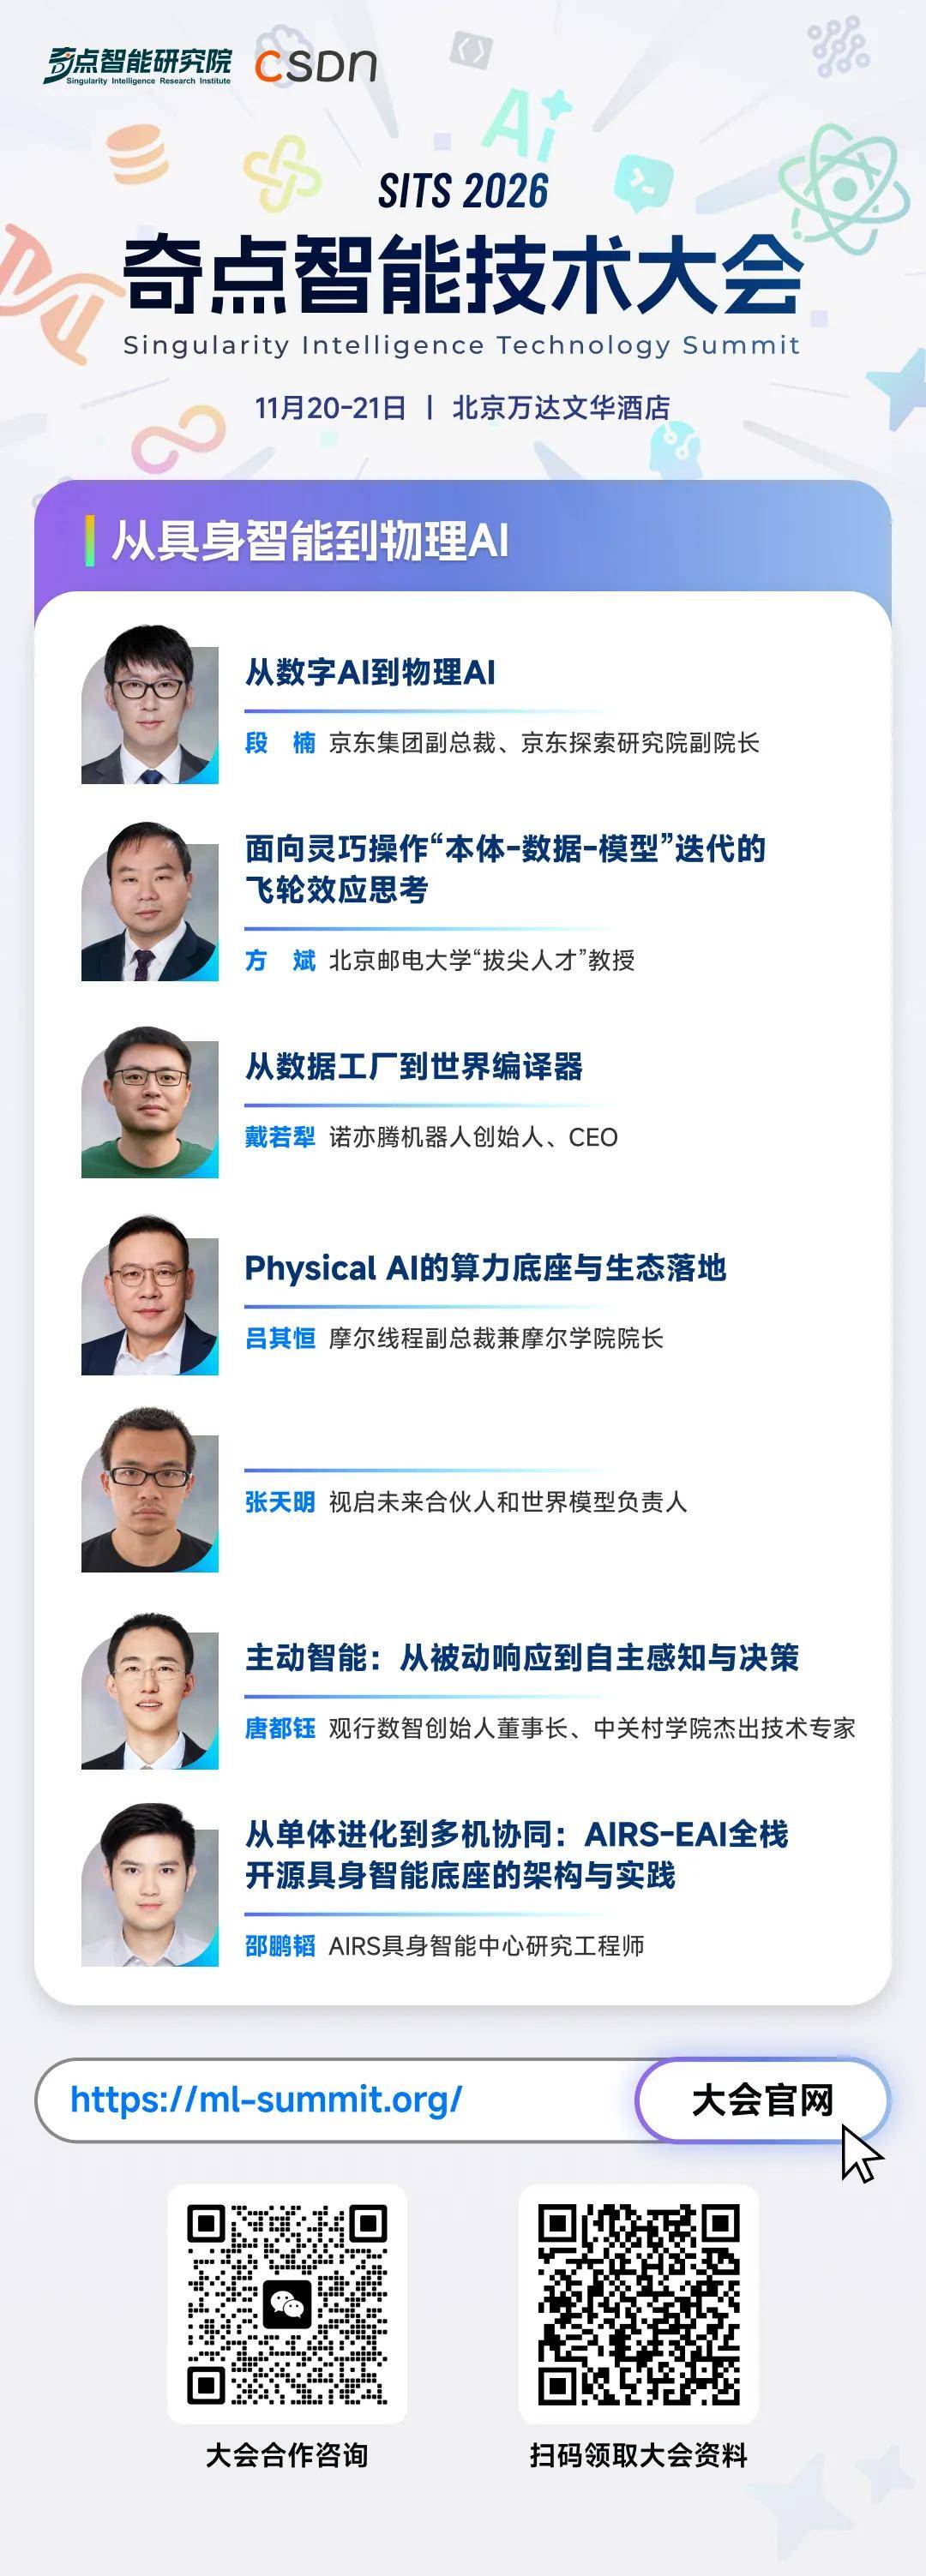
与这一专题相互呼应的,还有世界模型与多模态方向的动态场景世界模型、混元 3D、真实世界多模态交互,以及音乐、游戏和机器人模型将在同一现场展开讨论。
如果你正在做机器人、世界模型、具身智能、空间计算或多模态应用,这条路线能帮助你判断,Physical AI 走向真实部署,最缺的究竟是模型、数据、本体,还是整套工程系统。
路线三:AI Coding 从个人提效走向团队生产,研发体系能否接住代码洪流
当 AI Coding 生成速度超过人的阅读与审查速度,企业的知识、评测、Review、测试、CI 与组织机制能否同步升级?
报告显示,2026 年企业 AI Coding 支出已达到 340 亿美元,同比增长 7.7 倍,企业代码活动量同比增长约 5 倍。代码产能快速上涨,也同步放大了审查、构建、部署、维护与 SRE 的需求。对技术管理者来说,这已经不是要不要买一个编码助手的工具选型题,而是研发流程、质量门禁、效能指标与人才培养方式的系统重构。
「AI 原生软件研发:从 Harness 到 Loop」专题,将集中讨论 AI Coding 从个人工具走向大规模生产环境后暴露出的真实问题。
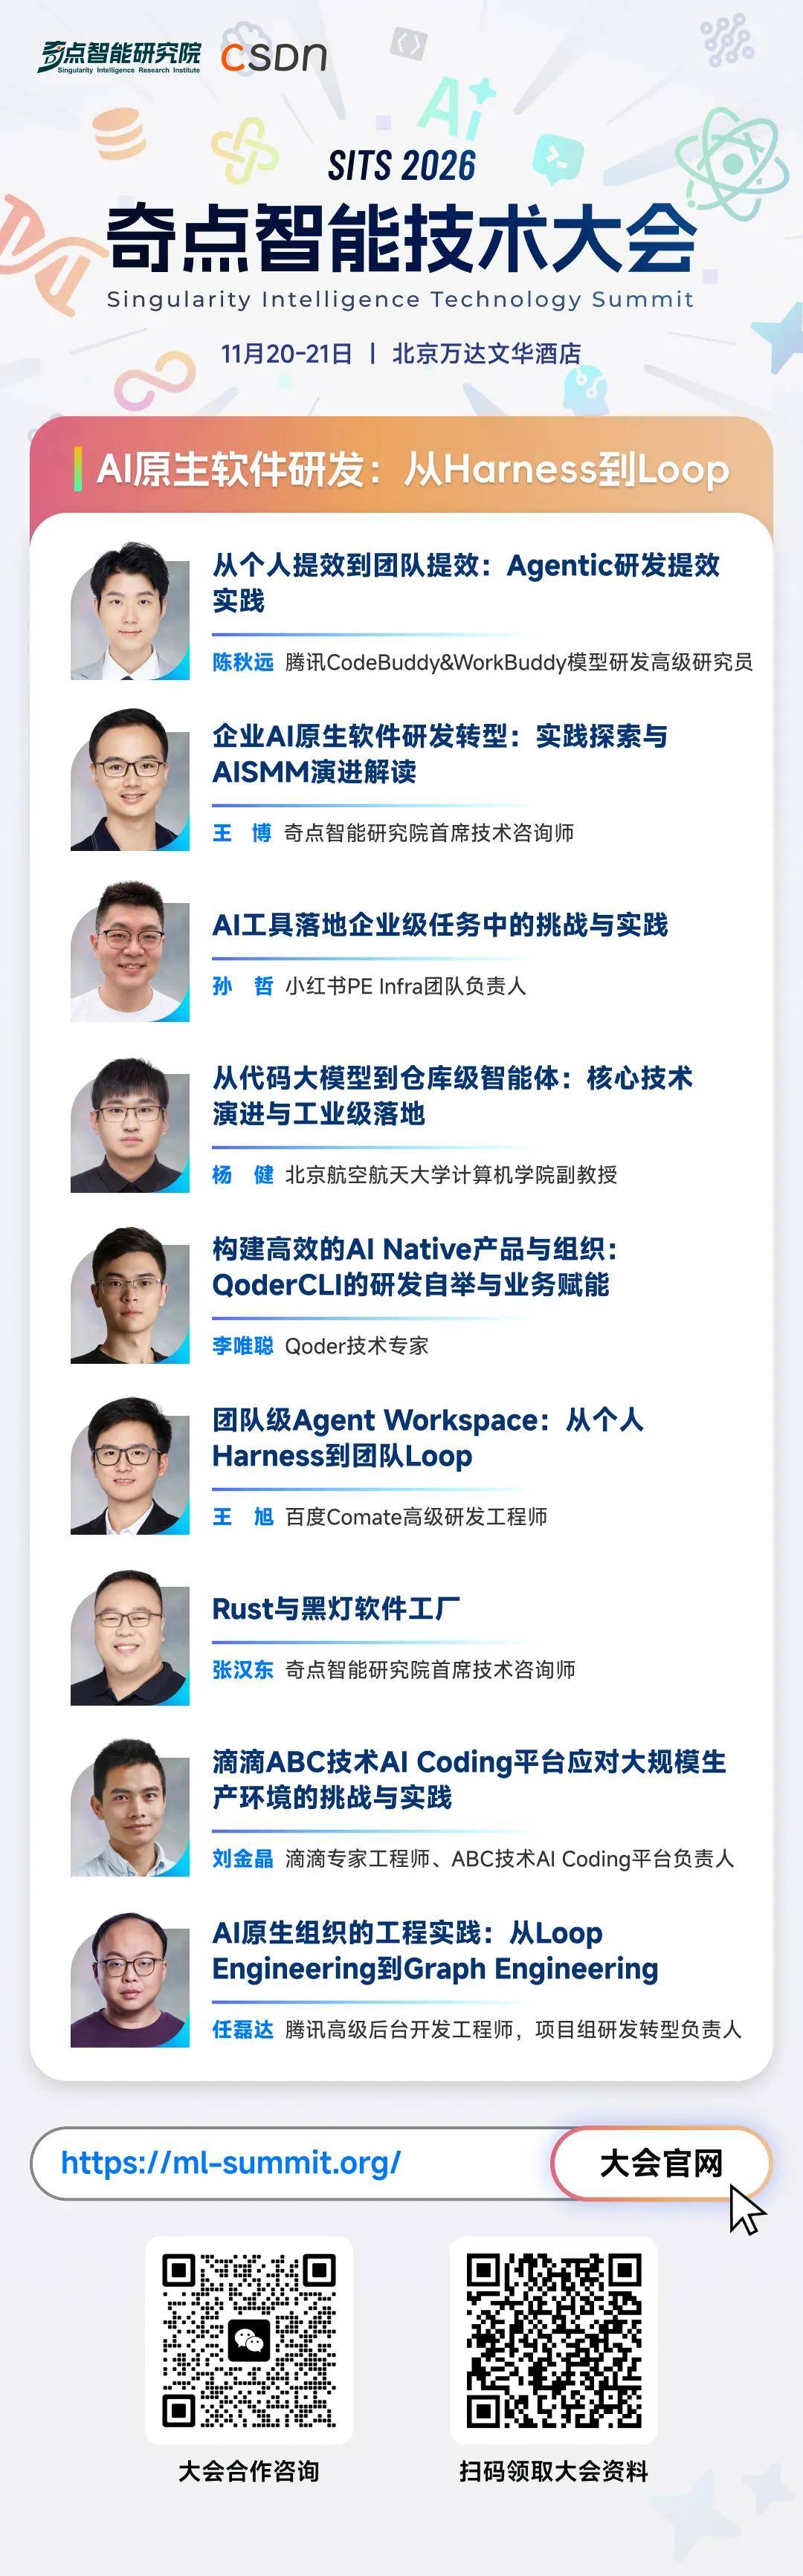
这条路线不会只展示 Demo,而会直面现实问题,如生成的代码由谁验证?Agent 如何获得团队上下文?知识如何避免快速腐化?个人效率为什么没有自动变成组织效率?当越来越多代码不再由人书写,质量、架构与责任边界应如何重建?
技术领导者可以重点带走一套新的效能判断框架。不再只看代码量、PR 数或 Token 消耗,而是关注需求交付周期、代码接受率、返工率、缺陷率、单位业务成果成本,以及人在关键架构和质量决策中的掌控力。
路线四:Agent 真正进入生产,拼的是长期运行能力
一个 Agent 能完成一次任务,与它能在真实业务里 7×24 小时稳定运行,是两件完全不同的事。
调查显示,企业 AI 增量支出中有 55% 来自新增预算,同时尚未出现大规模替换 CRM、HRIS 等核心系统的证据。换句话说,未来一段时间内,企业 Agent 更可能是接入现有系统、重组既有流程并创造增量价值,而不是把旧世界一次性推倒重来。
Agent 成功进入业务的三个前提有可以行动的环境、有足够完整的组织上下文,以及有可以验证的结果。这也解释了为什么企业落地不能只采购模型,还必须同步建设系统连接、知识工程、评测与治理能力。
在企业生产环境中,Agent 要面对权限、异步通信、任务恢复、人工接管、异常处理、评测回滚和可观测性。模型只负责局部智能,平台必须提供全局秩序。
在「AI +行业应用实践」专题中,阿里 1688 智能创新团队负责人陈映平将分享分销自主经营 Agent 如何在真实店铺中长期运行。飞猪技术专家梁宇航现场拆解确定性工作流与 Agent 如何共同进入机票履约。小鹏集团 AI 前瞻专家伦致远将复盘企业级 AI 三年演进,以及 700 个 Agent 如何经历价值淘汰。网易智企 AI 平台技术负责人裴明明将介绍多 Agent 如何从「会协作」走向可治理的组织级生产力。TiDB 智能研发中心负责人柏佳辰将回答为什么员工都开始使用 AI,企业却未必获得了组织智能。
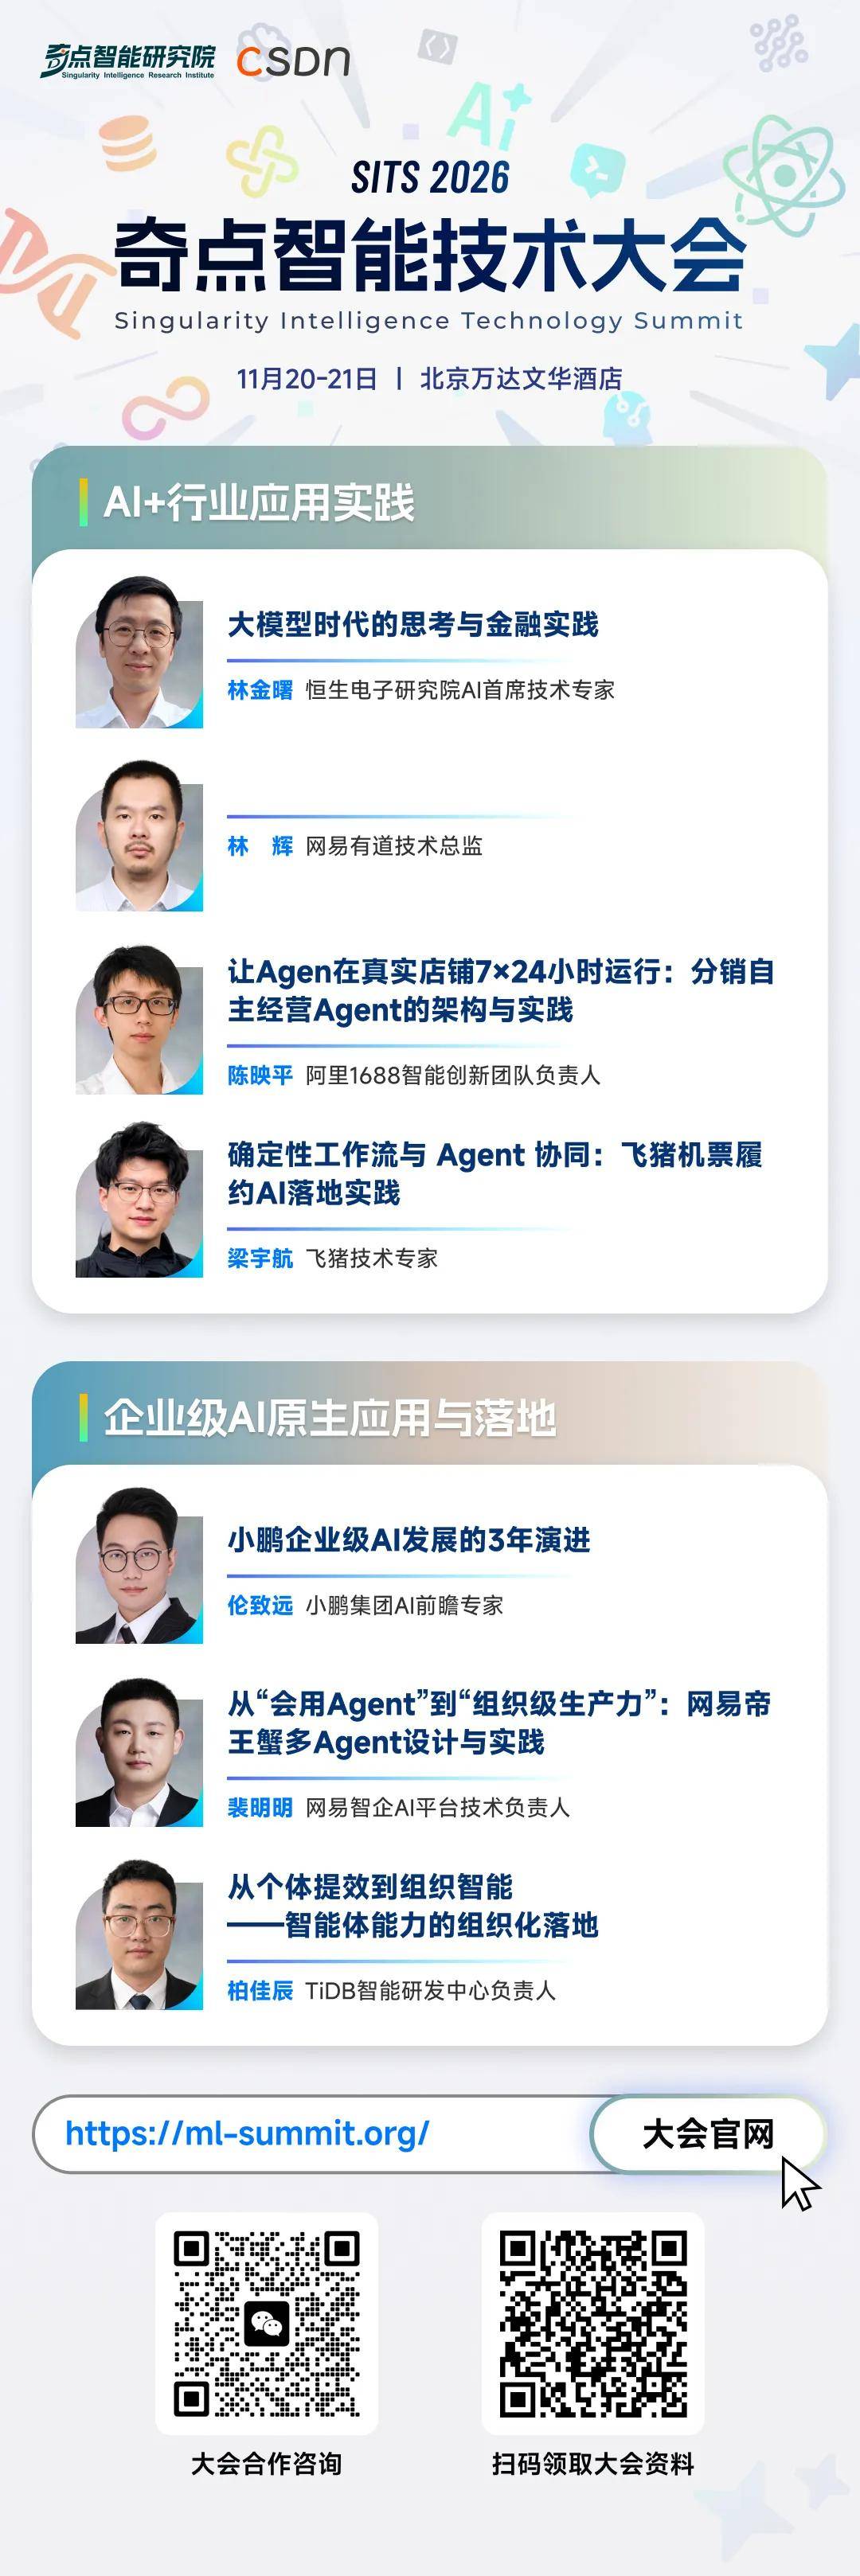
这些案例共同指向管理层必须回答的四个问题,那就是哪些场景值得优先投入,Agent 如何接入既有系统,价值如何持续度量,以及低价值或高风险的 Agent 如何被及时淘汰。
真正的生产落地,不是让 Agent 跑起来,而是让它在权限、成本、质量与责任可控的前提下长期创造业务结果。
路线五:模型越强,系统越重——AI Infra、系统软件来到同一个现场
一次 Agent 任务,用户看到的可能只是几秒后的答案。系统内部却要经历多轮模型调用、工具执行、上下文重算、缓存迁移和跨节点通信。
当请求规模、上下文长度和 Agent 并发持续增加,多加 GPU 不一定带来线性收益。真正决定吞吐、时延和成本的,开始变成推理调度、KV Cache、网络、存储、执行环境、编译器和运行时。
报告估算,2026 年企业 AI 部署支出中有 995 亿美元流向基础设施。74% 的 AI 构建者已经使用 Agent 编排工作流,32% 正在使用多 Agent。代码沙箱的采用率从 11% 升至 40%,搜索基础设施从 5% 升至 30%,浏览器基础设施从 4% 升至 14%。当 Agent 以机器速度并发执行、动态创建并释放资源时,面向人类使用节奏设计的传统基础设施,必然要被重新设计。
在「AI Infra 基础设施与 AgenticOps」专题中,亚马逊云科技首席应用科学家王鹤男将分享 Mooncake、SGLang 与 EFA 如何适配大规模 PD 分离推理。北京大学助理教授卓有为将讨论多智能体应用的推理调度与缓存优化。清华大学计算机系助理研究员、AgentENV 发起人闪英迪将拆解 Kimi K3 背后的超大规模智能体执行环境。SGLang 核心贡献者王书文将从 RadixAttention 讲到 Unified Radix Cache。中国科学技术大学特任副研究员白有辉将分享国产超节点上的稀疏 KV Cache 管理。LMCache Maintainer 毛宝龙与郑春晓将讨论统一 KV Cache 管理层。阿里云与蚂蚁的专家还将带来全栈根因诊断和训推一体实践。
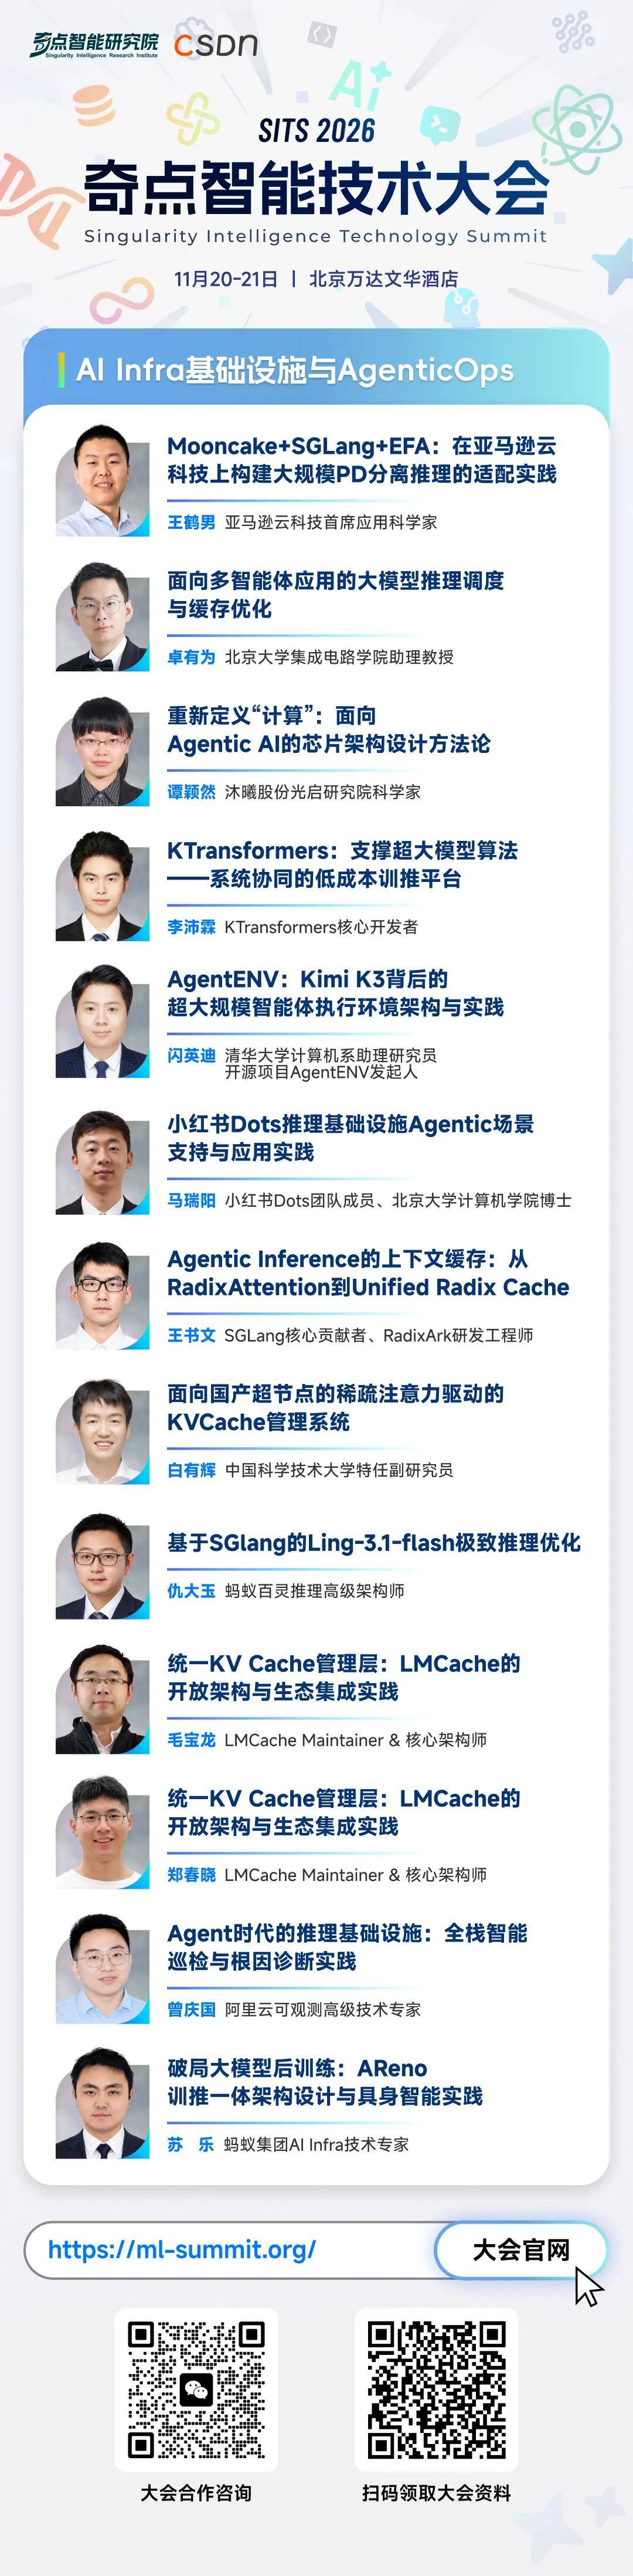
与此同时,C++ 及系统软件技术大会将把问题继续向下推进。
从 C++23 到 C++26、契约式编程与 AI 时代的编译器,到 RISC-V 原生 AI 软件栈、openVela C++ 运行时、2-bit KV Cache、Mooncake Store、数据中心 libc++ 迁移、Agent 安全沙箱和 AI 驱动测试,分享嘉宾来自 C++ 标准委员会、字节跳动、阿里云、小米、中国科学院、Mooncake、ONNX Runtime 等标准组织、企业与开源社区。
报告还显示,在其统计口径下,中国模型已经占开源模型支出的 89%。这并不等于中国模型占据整体企业市场,却释放出一个明确趋势。随着国产模型、开源模型和本土算力生态被更广泛采用,价值竞争会进一步下沉到推理引擎、编译器、运行时、网络、存储与芯片适配。系统软件不再只是后台成本中心,而会直接决定模型能否低成本、稳定地进入生产。
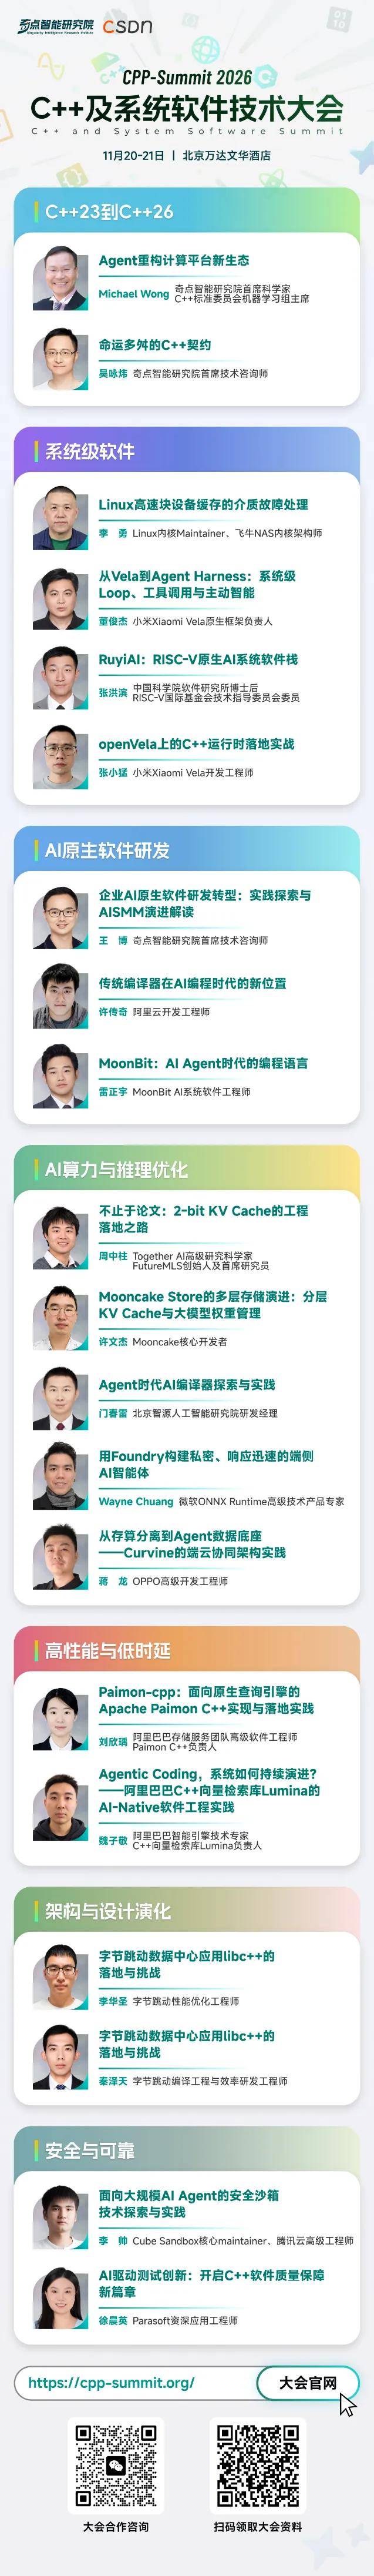
这条路线不仅适合 AI Infra、推理引擎、编译器、操作系统、存储、高性能 C++、端侧与芯片生态的一线开发者,也适合正在制定算力采购、云资源、平台建设与国产化路线的技术负责人。
它要回答的是模型之下那根「隐形钢梁」,如何继续扛住性能、可靠性与成本,以及哪些底层能力值得企业自建、共建或采购。
两天的现场价值,不只是听完多少场演讲。更重要的是,你可以带着企业真实问题,当面追问那些不会被写进产品文档的答案:
- 模型更新如此之快,企业应该押注单一模型,还是建设可替换的多模型架构?
- Agent 项目应该由业务部门、研发团队还是统一 AI 平台牵头?
- 哪些能力值得自建,哪些更适合采购、开源共建或生态合作?
- 如何把 Token、算力和平台投入,换算为可追踪的业务结果?
- 当 Agent 进入核心流程,权限、评测、安全、可观测性与问责机制如何补齐?
在企业 AI 预算增长速度已经超过多数组织的规划能力。下一阶段真正拉开差距的,不是谁更早接入一个模型,而是谁更早把模型、数据、Agent、基础设施与组织机制组合成一套可持续的 AI 生产力系统。
2026 年的 AI 技术变化太快,以至于年初的问题,到年末已经换了一套答案。也正因如此,这两天的线下聚集格外稀缺。模型研究者、Agent 开发者、企业技术负责人、AI Infra 工程师、系统软件专家,将在同一地点讨论同一条技术链上的不同难题。
让真正做技术的人,看见真正解决问题的产品
目前,大会企业合作与现场展示席位已进入最后确认阶段。
组委会面向大模型、云与算力、芯片、数据库、AI Infra、研发工具、安全、开源生态及企业级 AI 应用等相关机构,开放现场展位、产品展示、技术内容共创、品牌传播及生态合作等多种形式。期待与更多真正解决产业问题的技术企业,共同构建今年最后一个高质量 AI 技术交流现场。
11 月 20—21 日,两场大会年内不再加场。错过这一次,2026 年不会再有第二场。
如果这些问题与你正在做的工作有关,现在就该确定行程,而不是等到会后再从零散的朋友圈和二手总结里拼凑答案。





![神颜] 外形如何成为叙事工具,而不是唯一卖点(神颜一般指男人还是女人)](/img/13.jpg)