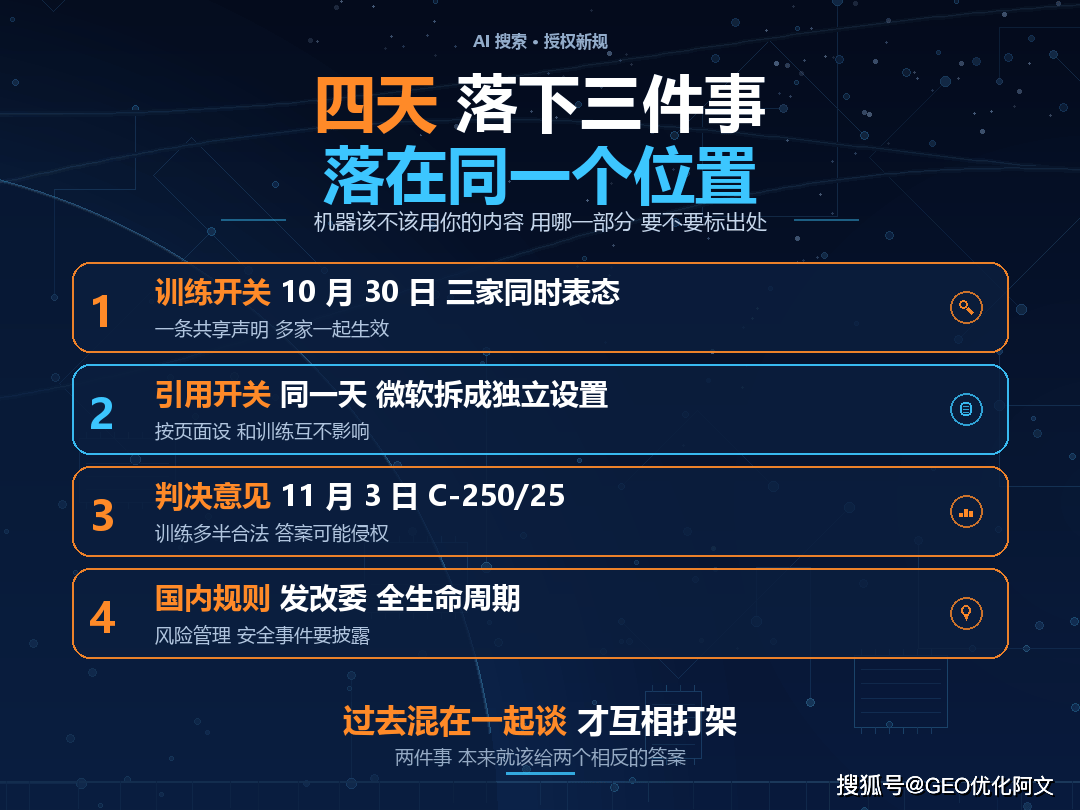
先说结论。挡 AI 爬虫这件事,今年已经不能一刀切了。10 月 30 日到 11 月 3 日,四天里三件事挤在一起,落在同一个位置上,就是机器该不该用你的内容、用哪一部分、用完之后要不要标出处。这三件事现在都有说法了,而多数人手上那套配置,还停在两年前的做法。
先把三件事按时间摆清。
第一件在 10 月 30 日。谷歌、微软、OpenAI 三家同日表态,支持 robots.txt 里一条共享的写法,一个独立的组,名字叫 __usage_ai-training,写法跟普通规则一样,下面接 Allow 或者 Disallow。它出自 IETF 的 AI 偏好工作组收到的一份草案。以前要挡住训练,得逐家写 GPTBot、Google-Extended、ClaudeBot,名单还在变长,漏一个就等于没挡。现在一条声明,对所有支持这一条的服务方同时生效。
第二件在同一天,微软走得更远。它把训练和引用拆成两个开关。训练管的是内容有没有被拿去喂模型。引用管的是内容能不能在它当场回答时被取用、能不能带出处和链接。两个开关分开设,互不影响。按官方公开说明,也都不影响在必应普通搜索里的收录。它还给了一条时间线,2027 年 2 月 1 日开始按新偏好抓取,3 月 1 日起不再把旧的 NoArchive 和 NoCache 当作 AI 偏好。还在靠这两个旧标签挡 AI 的站,到那时会被自动放开。
第三件在 11 月 3 日。欧盟法院佐审官就 Like Company 诉谷歌一案出具意见,案号 C-250/25。核心是一句话。用公开内容训练模型,一般落在文本与数据挖掘的例外范围内,合法。但聊天机器人检索到一篇新闻,把它的表达复用进答案再给用户,特定情形下可能侵犯出版者的邻接权。绕开付费墙或者反爬措施去取内容的,情形更重。这是一份意见,不是判决,最终判决大约还要半年。
同一天还有一条国内的消息。国家发改委提出,要推进覆盖人工智能全生命周期的规则,从数据、算力、算法到应用都算在内,会涉及国内几家主要的大模型公司,方向包括风险管理、安全事件和漏洞的及时披露,并且留出过渡期和行业试点。
三件事放在一起看,其实只讲了一件。
训练和引用,本来是两件完全不同的事,过去被混在一起谈,才出现了那么多互相矛盾的判断。训练是把内容变成参数,一次性,撤不回来,也带不来一次点击。引用是每次回答时临时去取,带着出处和链接,能带来人。对做内容的人来说,前者的成本基本只有一条,后者才是流量。所以不许训练和不许引用,本来就该给两个相反的答案。
反过来说,多数人的反应恰好是错的。
把 AI 爬虫全挡了,是我听过最多的一条建议,也是放在今天风险很大的一步。谷歌写得相当直白,站点用了这条共享声明、又没有单独写 Google-Extended,谷歌会当作你已经拒绝了 Google-Extended;而在它的文档里,Google-Extended 同时管着 Gemini 应用里的引用。你想关掉的只是训练,实际关掉的可能是连人带出处一起消失。微软那边也提示过,屏蔽引用会显著降低品牌在 AI 答案里的可见度,并且明说没有许诺收录、流量或者报酬。
再往下走一层,是版权这层常常记错的地方。
欧盟这份意见里真正要记住的一句,是版权保护出版物的具体表达,不保护它报道的事实。同一条规格、同一个地址、同一项服务范围,谁写都不算抄;但成段叙述、独创的比喻、自己拍的图,属于表达。这条线一划,应对方式就清楚了。不是去挡,而是把值得被引用的部分写成事实,把不愿被搬走的部分做成表达。挡是防守,写清楚是进攻。
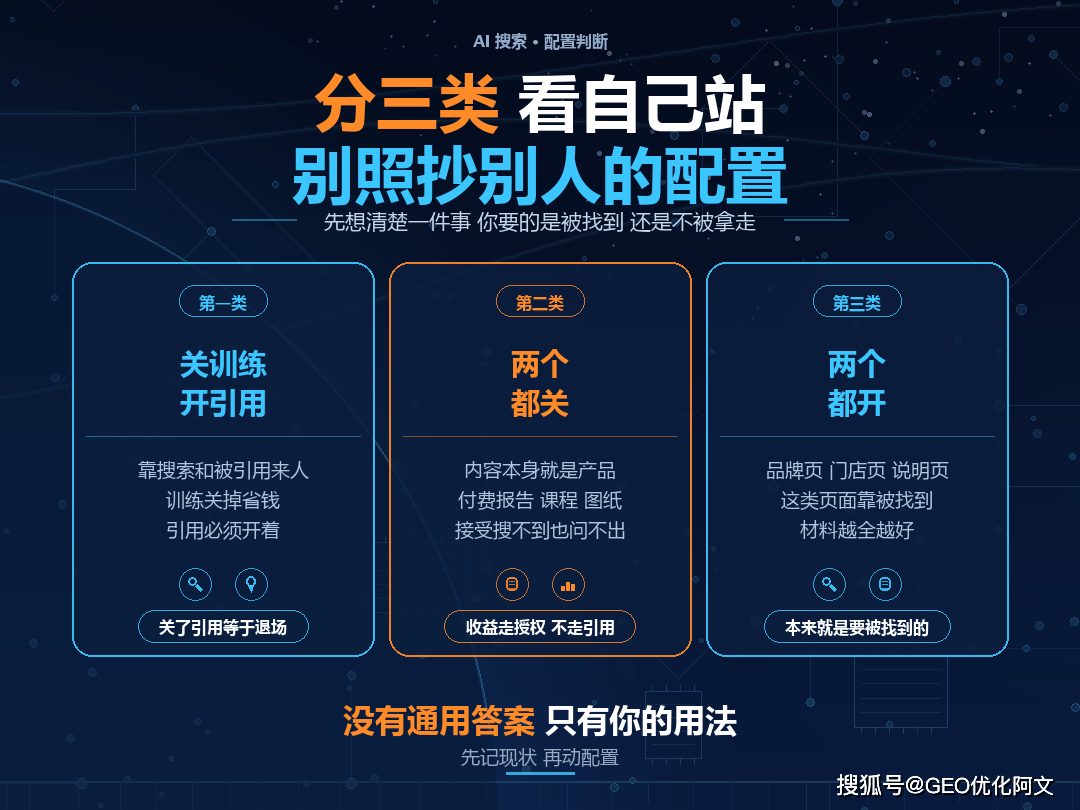
那么具体该怎么设,分三类看。
靠搜索和被引用来人的站,训练可以关,引用必须开着。这一条没有讨论余地,关了引用等于从答案里退场。内容本身就是产品的站,比如付费报告、课程、图纸,训练和引用都可以关,但要接受一个代价,既搜不到也问不出,这条路的收益得走许可和授权,不是靠被引用。主要是品牌页、门店页、说明页的站,两个都开着更合适,这类页面本来就是要被找到的。
有三种情况,建议先放着别动。
刚上线、页面还不到二十页的站,现在改配置改的是空的,机器手上没有你的材料,怎么设都一样。流量主要来自平台内推荐、跟搜索关系不大的,改了也感知不到,先把内容攒起来更有用。整站内容基本是转载和拼凑的,没有多少自己的表达,谈授权保护无从谈起,先有自己的东西,再谈怎么护。
真想动手,今晚就能做完三步。
第一步,打开自己域名下的 robots.txt。看有没有 User-Agent 一行是星号、下面紧跟一行 Disallow 斜杠。这一行是最常见的误伤,它把所有机器人一起挡了,包括搜索的,也包括 AI 的。真需要挡,写具体名字,别用星号一刀切。
第二步,在同一个文件里搜几个名字,GPTBot、Google-Extended、ClaudeBot、PerplexityBot。列出来了,说明这个站明确表过态,没列就是默认允许。这一步花不了一分钟,比凭印象判断靠谱。
第三步,把事实写成能被单独摘走的句子。成立时间、服务范围、资质编号、计价方式、退改规则,一句一条,别埋在大段抒情里。这不是专门给 AI 写的。人引用你的时候,也更容易引对。
有两个例子,恰好能从两头说明这件事。
有一家做氮气柜的公司,在苏州。官网产品页上只有图和一句品质可靠,容积、露点、材质这些参数全在业务员手里的表格上。结果 AI 回答里引的是第三方平台两年前挂的旧参数,还把一个单位写错了。后来他们把参数做成表格挂到页面上,改完两周再看,同一句问话的答案里多出了他们自己写的参数,单位也对上了。这里面没有玄机,机器没有材料,只能去别处找,找来的不一定对。
还有一家做办公用品配送的公司,在上海。他们把服务范围、起送量、送到时效写成条目,被别的号整段搬走过一次。搬得走的是表达,搬不走的是事实,所以他们没去挡爬虫,而是把条目写得更细,让人搬走之后还是得回原页面核对。这两家的处境不一样,动作却指向同一件事,把事实放在能被读到的地方,比把门关紧有用。
往后看一年,我有三个判断。
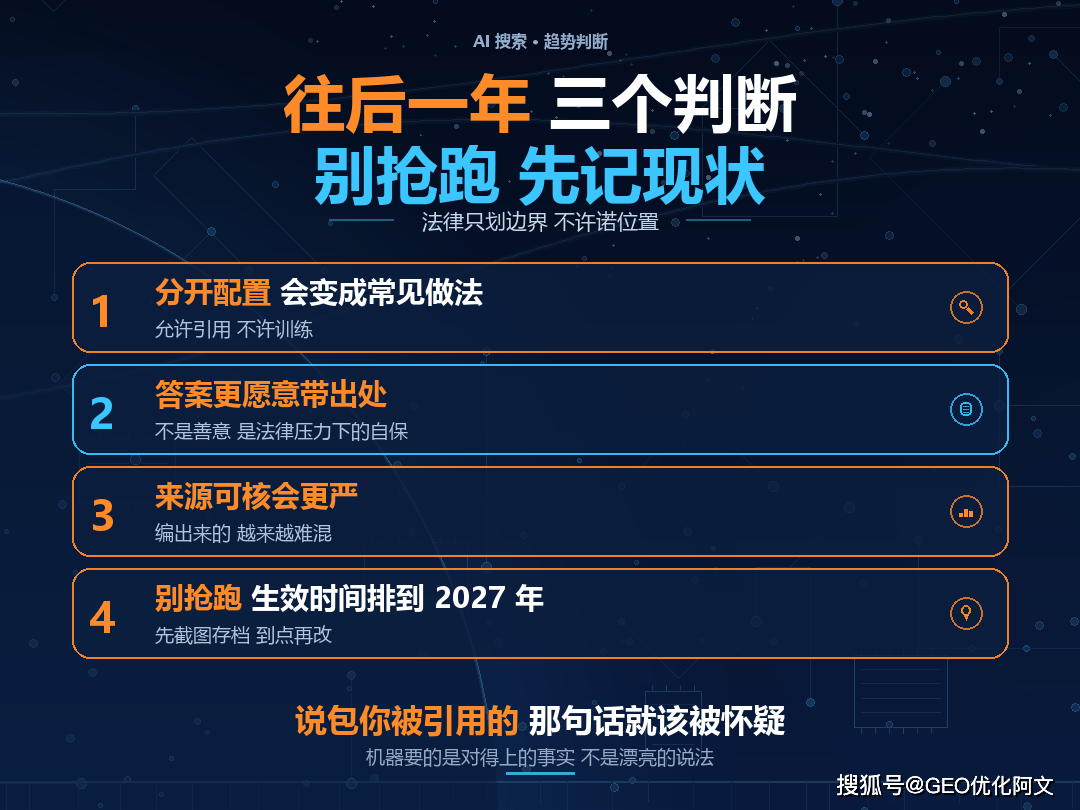
先说一条,允许引用、不许训练会成为中文站的常见配置。技术前提这周已经摆出来了,剩下的是各家落地的时间,以及国内平台跟不跟。
再说一条,AI 答案会更愿意带出处。这不是善意,是法律压力下的自保。欧盟那案子如果按意见判下来,带链接、少复述原文是更省事的合规路径,平台会主动往那边靠。
还有一条,编出来的来源会越来越难混。发改委这次提的是全生命周期,还要求及时披露安全事件,平台对来源可核的压力只会更大。
也要说清另一面。这些变化不等于做了就会被引用。引用与否仍然取决于问法、语料和平台自己的取舍,法律只划了边界,没有许诺位置。谁要说某个配置能让你稳进答案,那句话本身就该被怀疑。
还有一个时间上的提醒,别抢跑。
这三件事都还没到最终状态。共享声明只是 IETF 的一份草案,谷歌说 2027 年才支持;微软的新开关要到 2027 年 2 月才开始按新偏好抓取;欧盟那份是佐审官意见,不是判决。现在就大改配置,属于提前动手。更稳的顺序是先记录现状,截图存档,等生效时间到了再动,改完再看变化。
常见问题
问:把 AI 爬虫挡了,搜索收录会掉吗?
答:按谷歌和微软各自的公开说明,这两项设置不影响普通搜索里的收录。但挡掉引用会少一批人和出处,这一层影响是实打实的。
问:别人整段搬了我的文章,能主张赔偿吗?
答:国内走著作权这条路,能主张的是表达被照搬,事实和数据本身很难主张。先存好发布时间、原文链接和逐段对比截图,这是后面所有动作的前提。
问:小店没有官网,这些跟我有关系吗?
答:有关系,但顺序不一样。没有官网的,先在点评类平台、地图、行业平台上把营业时间、服务范围、计价方式填准,那些页面就是机器读得到的事实来源。
回到开头那句。这一轮变化里,方向是清楚的,机器越来越需要能对得上的事实,而不是漂亮的说法。让认真做事的人被看见,靠的从来不是把门关紧,是把自己的事写得让人没法写错。
—— GEO优化阿文
本文由 AI 辅助整理,事实与判断由本人核对。