又是一年进博会,Token经济进入狂飙突进时代,中国馆里的“镇馆展品”也在悄然发生着变化。沐曦股份作为本届中国馆唯一入选的国产GPU企业,没有把自家的主推芯片单独摆上展台,而是搬来了曦景S600超节点与“沐曦股份X东方算芯”异构双擎算力机柜两套系统级装备。
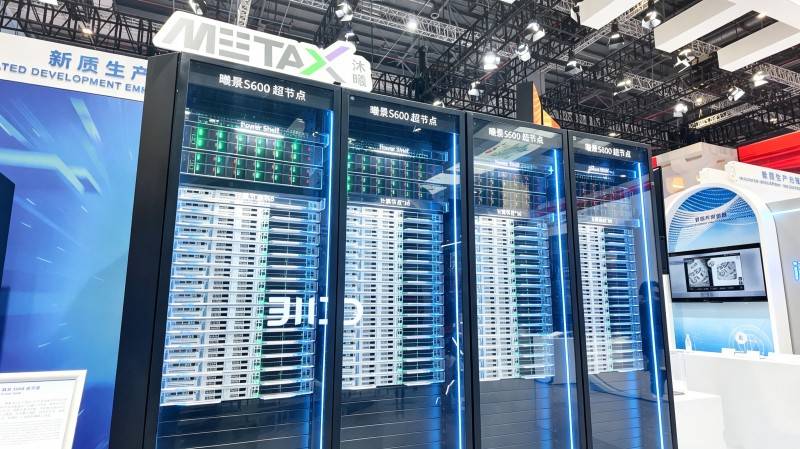
曦景S600超节点面向大模型训练与推理、智算中心建设,搭载沐曦曦云C600全国产旗舰GPU,配合自研MXMACA软件栈平台与MetaXLink高速互联技术,单机柜支持128卡全交换、无带宽收敛的互联架构,具备高带宽、灵活扩展、稳定可靠等特性,支持内存语义和低时延数据通信,并可Scale out横向扩展至万卡集群。其工程巧思集中在部署端:高密正交整机柜采用“三0”设计——计算节点0线缆、交换节点0线缆、计算与交换节点间0线缆,结合解耦模块化架构,机房无需改造即可快速部署,直接压低大规模智算集群的部署与运维成本,为智算中心、政企、金融、科研等行业提供高性能、大显存、高可靠的国产智能算力底座。
异构双擎算力机柜则把目光投向推理侧。
沐曦与东方算芯联手推出面向云端推理的国产双芯异构融合方案,打破传统单类芯片Scale-up的思路,以异构集成让不同计算特性各展所长。在混合专家模型架构(MoE)的AE分离场景中,注意力(Attention)与专家网络(Expert)在物理上解耦,实现“双芯分治”:曦云C600承担上下文关联计算等计算密集型任务,东方算芯DF1000承担稀疏激活等访存密集型任务,同时击穿“访存墙”与“计算墙”,端到端实现推理时延的代际跨越。在投机解码(Speculative Decoding)加速方案中,该方案又转为“双芯合璧”:DF1000以极致低延迟流式生成草稿候选,C600以澎湃并行算力批量执行精审校验,共同实现模型加速。更关键的是,芯片、模型、推理框架与云平台按统一目标联合优化,异构融合由此落到产业协同,形成可复制的国产云端推理新范式。
同构与异构,一套装备解决“算得快、扩得开、落得下”,另一套解决“推理省、时延低、协同得起来”——两条路线在进博会中国馆同台亮相,展示的是一套可部署、可扩展、可复制的自主可控的算力底座。这,也许就是沐曦股份“唯一入选”进博会中国馆GPU企业背后更实在的分量。