引言:从一条完整的原子量子计算物理实验流程说起……
如果把量子计算比作一场在暴风雨里进行的精密手术,那么量子纠错不是那把更锋利的手术刀,而是整间手术室的恒温、恒湿与无菌系统。没有它,刀再快也没有意义。
这篇长文从一条完整的中性原子实验流程出发:先说明为什么必须纠错,再拆开“编码—校验—解码”的内核,然后沿硬件、算法、指标与路线图逐层展开。文中方括号数字为参考文献序号;文献信息经 Crossref / DOI 核验,数据截至 2026 年 11 月。
一、为什么必须纠错:量子计算是一只漏水的桶
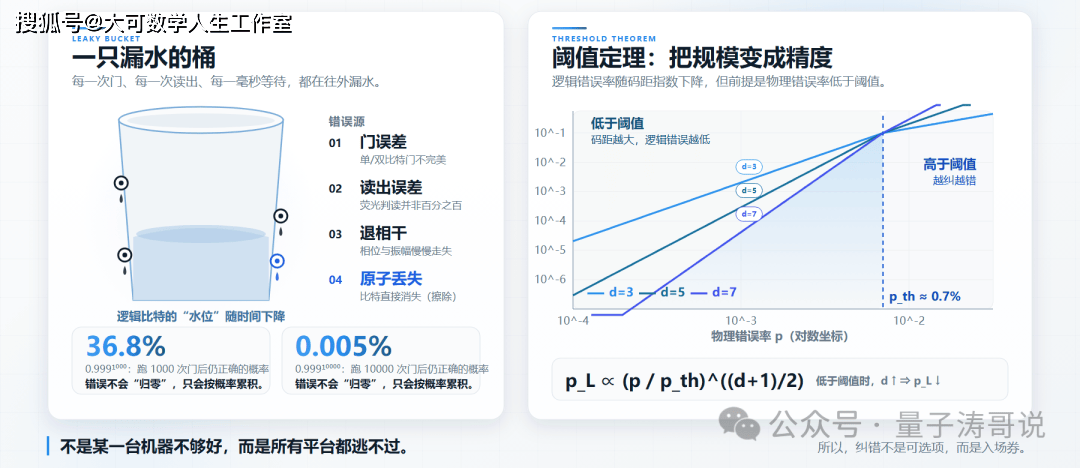
图 1 量子纠错的必要性:错误随门数累积,只有低于阈值、增大码距,才能把逻辑错误压下去。
先说结论:不是某一台机器不够好,而是所有平台和路线都逃不过。
超导、离子阱、中性原子,今天物理门与读出的错误率大多落在 10⁻⁴–10⁻³ 量级。单比特门约 99.9%,两比特门约 99%–99.5%,读出约 99%–99.9%;中性原子还多一项特有的麻烦——原子会丢。一个有实际意义的算法,动辄需要上百万次门操作。错误按概率累积:99.9% 的门连续跑 1000 次,整体成功率只剩 36.8%;跑 10000 次,只剩约 0.005%。
经典计算有办法。用三个比特存一位信息,坏了就投票,多数说了算。量子计算没有这条路:未知量子态不可克隆,这是不可克隆定理划下的硬线;更麻烦的是,直接测量数据比特会让叠加态坍缩——你想检查“有没有错”,检查这个动作本身就把计算毁了。
于是纠错在这里撞上一个悖论:要在不看答案的前提下,判断答案有没有被写错。
出路在 1990 年代中后期被找到了。Shor 与 Steane 先后提出量子纠错码[1,2],Kitaev 提出基于任意子的拓扑码(toric code),后来发展为表面码[3,5];随后的阈值定理给出了更关键的一句话:只要物理错误率低于某个阈值(表面码大约在 0.5%–1% 之间,具体取决于噪声模型),把码距 d 加大,逻辑错误率就会按 (p/p_th)^((d+1)/2) 的速度指数下降[4,17,18]。这句话是整座量子计算大厦的地基——它意味着“用更多比特换更低错误率”在原理上成立,剩下的全是工程。
近两年的实验给出了两个坐标。2024 年 12 月,Google 用 105 个超导比特跑了码距 3、5、7 的表面码,展示逻辑错误率随码距增大而指数下降,抑制因子约为 2.14[15]。需要说明的是,Google 在 2023 年已用 d=3、5 的器件展示过类似的随码距下降[21];2024/2025 年的工作把码距推到 7,并给出了“低于阈值”的更完整证据。而在中性原子这边,2023 年底哈佛与 QuEra 团队用 280 个原子编码出 48 个逻辑比特(2024 年正式发表)[14]——让原子阵列可以批量地“生产”逻辑比特,而不只是一个一个地打磨。
二、纠错的本质:不是修复,而是隔离、记录、抵消
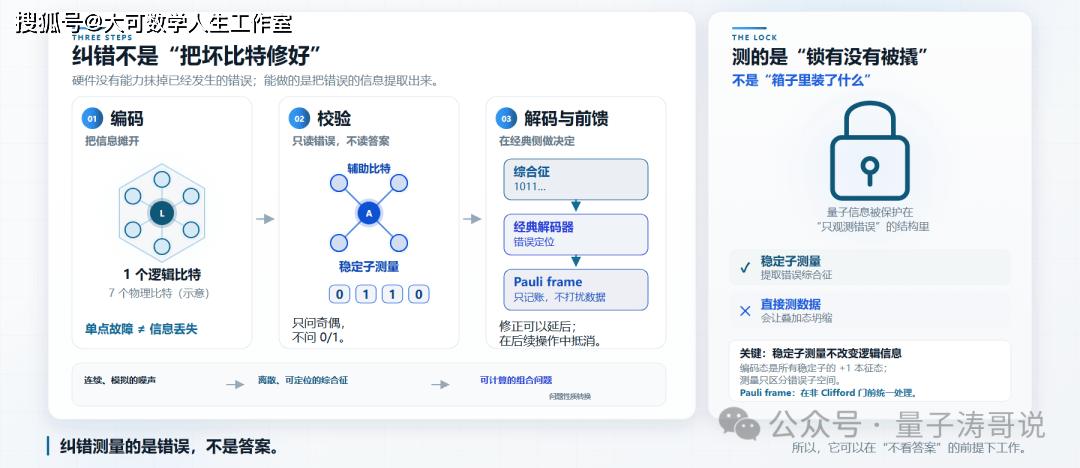
图 2 编码、校验、解码:把不可直接观测的噪声,转换成离散、可定位、可计算的综合征。
很多人对量子纠错的第一印象是“把出错的比特修好”。这个印象是错的。硬件并没有能力把已经发生的相位翻转抹掉,也没有能力让跑掉的原子回来。真正发生的是三件事。
第一件,编码。把一个逻辑比特的信息非局域地摊在一组物理比特上,让任何一个单独的物理比特都不承载完整信息。信息被“摊薄”了,单点故障就不再是致命的。
第二件,校验。引入辅助比特,反复测量一组稳定子——它只回答“这几个比特之间的奇偶关系对不对”,绝不回答“这个比特是 0 还是 1”。测量结果是几个比特的经典位串,业内叫综合征(syndrome)。
第三件,解码与前馈。经典计算机根据综合征反推错误发生在哪里,决定施加什么修正。修正不一定真的做一个门,也可以只在经典控制里“记一笔账”(Pauli frame),让它随 Clifford 门传播,并在下一个非 Clifford 门前统一处理。
为什么测稳定子不会破坏量子信息?因为编码后的逻辑态是所有稳定子的 +1 本征态,稳定子测量不会改变它;测量只区分“哪个错误子空间”,不区分同一子空间内的逻辑态。用一句通俗的话说:纠错测量的是“锁有没有被撬”,而不是“箱子里装了什么”。
一句话:纠错测量的是错误,不是答案。它把“要不要修、修哪里”变成经典侧可以计算的问题。
所以,量子纠错的本质是一次问题性质的转换:把连续的、模拟的、不可直接观测的噪声,转换成离散的、可定位的、可计算的组合问题。一旦转成组合问题,经典算法就能接手——这也是为什么今天最前沿的量子纠错研究,一半在物理实验室,一半在算法与工程团队手里。
代价也很诚实。一个逻辑比特要几十到上百个物理比特(具体取决于码型与码距),要反复测量、反复解码,线路时间被拉长,控制复杂度陡增。纠错从来不是免费的午餐,它是用资源换保真度。
三、把纠错放回流水线:错误究竟在哪一步发生
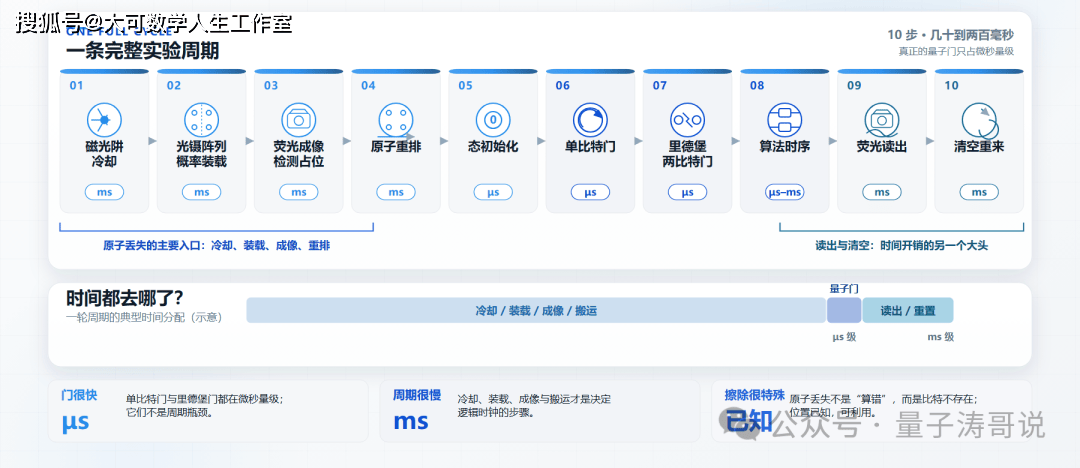
图 3 中性原子实验的十步流水线:量子门只占微秒,冷却、装载、成像与搬运决定逻辑时钟。
要讲清楚中性原子的纠错,得先看清楚它一条完整周期长什么样:磁光阱冷却 → 光镊阵列与概率装载 → 荧光成像检测占位 → 原子重排 → 态初始化 → 单比特门 → 里德堡两比特门 → 算法时序 → 荧光读出 → 清空重来。一轮下来几十到两百毫秒,而真正的量子门操作只占微秒量级,绝大部分时间消耗在冷却、装载、搬运和成像上。
错误就分布在这条线的每一段,只是形态不同。下面这张表,是我按整条流程逐段拆出来的:
表 1 中性原子实验流水线中的主要错误源
表格之外,有一个错误必须单独拎出来说,因为它决定了中性原子纠错的所有特殊性:原子会丢失。
这不是“算错了”,而是“这个比特根本不存在了”。业内把它叫作擦除(erasure)。在超导体系里,比特坏了通常表现为一次错误;在中性原子里,比特会直接消失,位置留下一个空阱。
听起来更糟,其实是更好。因为擦除的位置是已知的——成像一看,哪个阱空了,一目了然。而在纠错理论里,已知位置的擦除,其纠错容量远高于同等概率的随机翻转:一个码距为 d 的码,能纠正 (d−1)/2 个(向下取整)位置未知的错误,却能对付多达 d−1 个位置已知的擦除[6,13]。换句话说,中性原子把自己最致命的缺陷,变成了一条可以被利用的信息。
擦除的位置是已知的。它比“位置未知的翻转”更容易纠,也更适合被解码器利用。
这就是中性原子纠错的第一个战略判断:先别跟“翻错”死磕,先把“丢失”管住。
四、硬件怎么实现:把纠错循环插进流水线
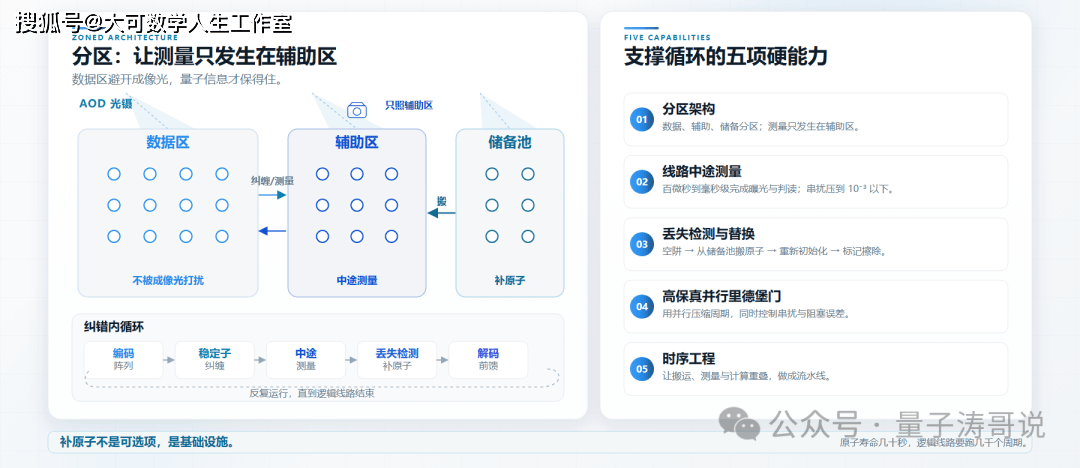
图 4 分区架构、纠错内循环与五项硬能力:数据区不被打光,丢失的原子可以补回来。
开启纠错之后,那条十步流水线并没有被推翻,只是被插入了一个反复运行的内循环:编码阵列 → 稳定子测量(辅助比特纠缠)→ 中途测量 → 丢失检测与补原子 → 经典解码 → 修正或记账 → 回到算法。
支撑这个循环,需要五样硬能力,缺一不可。
1. 分区架构
数据比特、辅助比特、储备原子放在不同区域,用 AOD(声光偏转器)光镊在区域之间往返搬运。这不是为了排版好看,而是为了让测量只发生在辅助区——数据区不被成像光打扰,量子信息才保得住。
2. 线路中途测量
只对辅助原子施加成像光,在百微秒到毫秒量级完成一次曝光与判读,串扰要压到千分之一以下。这是整个纠错循环里最“贵”的一步——它决定了纠错周期的时间下限,也决定了逻辑时钟能跑多快。
3. 丢失的实时检测与替换
成像发现空阱 → 从储备池搬一个原子过来 → 重新初始化 → 同时给解码器一个“此处发生擦除”的标记。超导芯片无法在运行中物理更换一个已经损坏的比特;中性原子可以换一个原子,接着往下算——这是它最容易被低估的优势。
4. 高保真的并行里德堡门
并行是为了压缩周期,但并行会带来串扰和阻塞误差,需要在阵列排布与脉冲设计上做折中。这里是当前中性原子的主战场:门保真度是决定可承受码距的关键变量之一;每一点提升,都会直接放宽纠错对码距和周期的要求。
5. 时序工程
门是微秒,测量和搬运是毫秒,所以纠错循环的节奏由后两者决定。优化的方向不是“把门做得更快”,而是“让搬运、测量和计算重叠起来”,做成流水线——这是工程问题,不是物理问题。
还有一条隐性约束:原子寿命。真空里的原子能活几十秒,一轮实验几十到两百毫秒,这意味着一条逻辑线路如果跑上几千个纠错周期,就必须把“算到一半原子没了”当成必然事件来设计。所以补原子不是可选项,是基础设施。
五、算法怎么实现:码、解码、编译

图 5 选码、解码、编译:可移动连接让非局域校验从“布线难题”变成“调度问题”。
硬件提供“能测量的能力”,算法决定“测什么、怎么算”。这一层分三步。
第一步,选码
表面码结构简单、阈值高,是当下的主力;但它开销大,一个码距 7 的表面码逻辑比特要约百个物理比特[5]。更高码率的量子 LDPC 码在理论上能把开销压下一个数量级,代价是需要非局域的校验连接[16]——这恰好是中性原子的长处:原子可以搬,连接可以临时建立。非局域校验在别的平台是布线难题,在中性原子是一个调度问题。这可能是中性原子在算法层最被低估的一张牌。
第二步,解码
输入是综合征位串,输出是错误推断。工程上用最小权重匹配、并查集、置信传播+有序统计(BP+OSD)等解码器;针对中性原子,还要专门做擦除感知解码,把“已知丢失”当成高置信度信息喂进去,纠错能力能明显提升[6,13]。近两年神经网络解码器被用来压延迟;但真正的瓶颈往往不在算法复杂度,而在“能不能在下一个逻辑门之前算完”。
第三步,编译
逻辑线路要被摊到空间上:哪里存、哪里算、哪里测。逻辑门用格子手术或码形变实现[20];非 Clifford 门要靠魔术态注入与蒸馏[19],而蒸馏本身是个巨大的资源黑洞。一个算法最后往往不是被保真度卡住,而是被“为了一个 T 门要占用几千个物理比特”卡住。
这里还有一个常被误解的点:修正不一定当场做。在两个 Clifford 门之间,错误可以只在经典侧记账(Pauli frame),随 Clifford 门传播;到下一个非 Clifford 门前再集中处理。这条规则极大地放宽了对解码延迟的要求,也是中性原子这种“慢平台”能够实用化的关键技巧之一。
六、目标:什么叫“真正能用的逻辑比特”
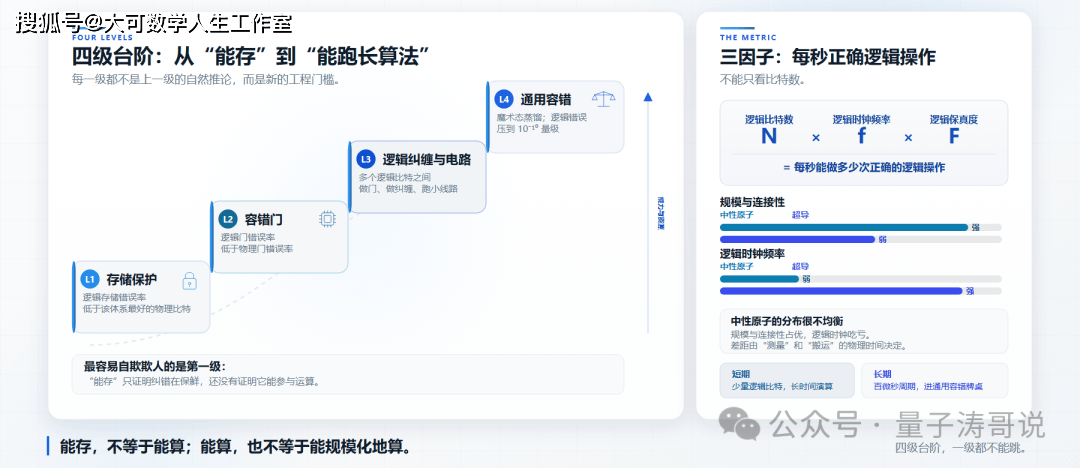
图 6 四级台阶与三因子:能存不等于能算,能算也不等于能规模化地算。
可以按四级台阶来理解这件事。每一级都不是上一级的自然推论,而是新的工程门槛。
第一级,存储保护。逻辑比特的存储错误率低于该体系最好的物理比特。这是“纠错真的起作用了”的最低门槛,也是最容易自欺欺人的一级——很多演示只证明了“能存”,没证明“能算”。
第二级,容错门。逻辑门错误率低于物理门错误率,说明纠错不只是保鲜,还能参与运算。
第三级,逻辑纠缠与逻辑电路。多个逻辑比特之间做逻辑门、做纠缠、跑小规模逻辑线路。到这一级,“逻辑比特”才从一个名词变成一种资源。
第四级,通用容错。加上魔术态蒸馏,把逻辑错误率压到算法可接受的量级(常说的 10⁻¹⁰ 量级是其中一种目标,具体取决于算法与误差预算),能支撑 Shor 这类长算法。这才是“有用的量子计算机”的入场券。
衡量一个平台,不能只看比特数。真正的指标是三个量的乘积:逻辑比特数 × 逻辑操作频率 × 单次逻辑操作保真度,也就是“每秒能做多少次正确的逻辑操作”。
中性原子在这三个量上的分布不均衡:规模与连接性占优,逻辑时钟频率吃亏——超导的逻辑时钟频率在兆赫兹量级,中性原子目前是赫兹到千赫兹。这个差距不是靠多买几台激光器就能填平的,它由“测量”和“搬运”这两步的物理时间决定。
所以中性原子的路线图,本质上是一道选择题:是“用规模换时间”,还是“用时间换规模”。短期看,它更适合“少量逻辑比特、长时间演算”的场景——量子模拟、组合优化、采样;长期看,只有当纠错周期被压到百微秒量级,它才更有竞争力进入通用容错的行列。
能存 ≠ 能算;能算 ≠ 能规模化地算。四级台阶,一级都不能跳。
七、路要怎么走
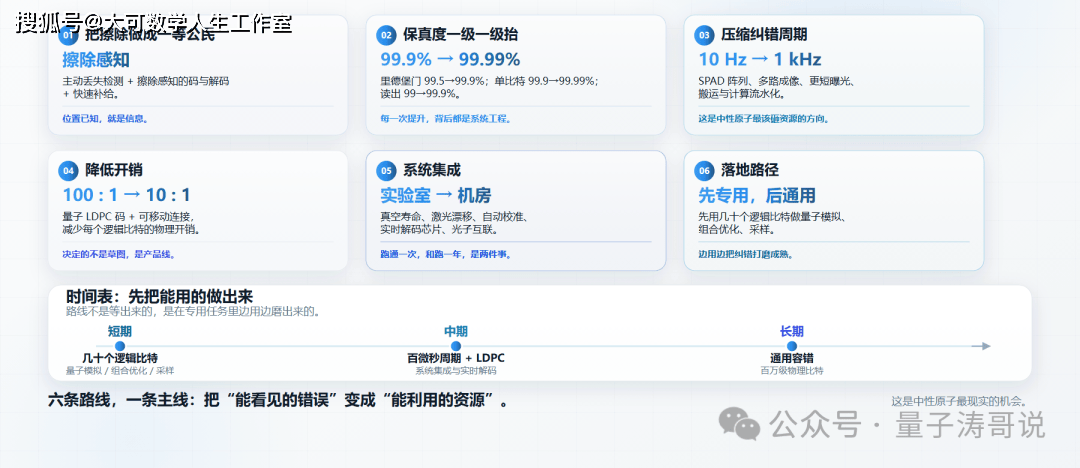
图 7 六条路线与三阶段时间表:先专用、后通用,在真实任务里把纠错磨成熟。
把前面的判断收拢,路线可以归纳为六条。它们不是六个孤立的方向,而是一条主线上的六个抓手:把“能看见的错误”变成“能利用的资源”。
第一,把擦除做成一等公民。主动的丢失检测(只探测占据/丢失,不读出数据态),配合擦除感知的码与解码,再配快速的原子补给。这条线做扎实,相当于把可纠正的擦除数从约 (d−1)/2(向下取整)提到 d−1,是所有投入里性价比最高的。
第二,保真度一级一级往上抬。里德堡门从 99.5% 到 99.9%,单比特门从 99.9% 到 99.99%,读出从 99% 到 99.9%。每一次提升,背后都是激光稳定性、原子温度、磁场屏蔽、脉冲设计的系统工程,而不是某一个点的灵光一现。
第三,压缩纠错周期。并行读出(SPAD 阵列、多路成像)、更短曝光、搬运与计算的流水化,目标是把逻辑时钟从十赫兹提到千赫兹。这是中性原子最该砸资源的方向,也是它和超导差距最大的地方。
第四,降低开销。量子 LDPC 码加可移动连接,把物理比特与逻辑比特的比例从 100:1 压到 10:1。这个比例直接决定百万物理比特能换来一万还是十万个逻辑比特——这决定了它是一条产品线,还是一张草图。
第五,系统集成。真空保持寿命、激光系统长期漂移、自动化校准、实时解码的 FPGA 与专用芯片、模块之间的光子互联。实验室里能跑通一次,和机房里能跑一年,是两件完全不同的事。
第六,落地路径。不必等“通用容错量子计算机”,先用几十个逻辑比特做专用任务:量子模拟材料与分子、组合优化、采样。边用边把纠错打磨成熟——这条路径比憋一个大招现实得多,也更符合中性原子当下的能力边界。
八、结语:看见错误,比消灭错误更重要
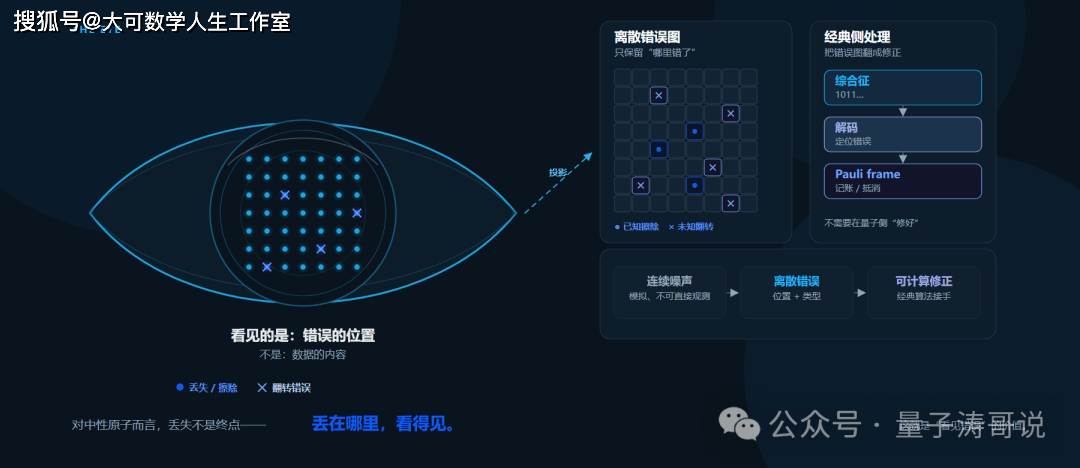
图 8 看见错误:把连续噪声翻译成可观测、可计算的离散错误图。
回到最初的问题:量子纠错究竟是什么?
它不是让原子不出错,而是让错误变得可管理。它把物理世界里的连续噪声,翻译成数字世界里的离散图案;把不可观测的量子信息,保护在“只观测错误、不观测答案”的结构里。
对中性原子而言,这条路的独特之处在于:它恰好是最“能修”的平台。原子能搬、能换、能补,丢失能被看见,连接能被重建。它不是最快的平台,但它可能是最容易把“纠错”从一个漂亮的演示,变成一个真正系统的平台。
一句话收尾:在量子计算里,看见错误,比消灭错误更重要。
(鉴于作者能力有限,错误不可避免,欢迎拍砖)。
附:几个名词的简注
稳定子(stabilizer):一组彼此对易的算符;编码态是它们的 +1 本征态。测量稳定子只提取错误信息,不暴露逻辑态。
综合征(syndrome):稳定子测量的经典结果位串,是“错误的地图”,不是“数据的答案”。
码距(distance):把一个码字变成另一个码字所需的最小物理错误数,等价于最小权重的非平凡逻辑算符。码距 d 的码可纠正 (d−1)/2 个(向下取整)位置未知的错误,或 d−1 个位置已知的擦除。
擦除(erasure):错误位置已知的错误;在中性原子里典型表现为原子从光阱中丢失。
Pauli frame:把 X/Z 修正记在经典控制里、不真的打一个门;它随 Clifford 门传播,在非 Clifford 门前统一处理。
魔术态蒸馏:用多个带噪声的态换一个高保真态,是通用容错的必备工序,也是资源消耗的大头。
AOD:声光偏转器(acousto-optic deflector),用于动态生成和移动光镊。
SPAD:单光子雪崩二极管(single-photon avalanche diode),用于快速、并行读出。
参考文献
说明:本文的物理图像与流程判断来自作者实验经验;所引文献用于支撑纠错码、阈值定理、里德堡门、原子重排与擦除纠错等关键论断,均为公开发表的原始论文、权威综述或经典教材。文献信息经 Crossref / DOI 核验,数据截至 2026 年 11 月。
[1] Shor P W. Scheme for reducing decoherence in quantum computer memory. Physical Review A, 1995, 52(4): R2493–R2496. DOI: 10.1103/PhysRevA.52.R2493.
[2] Steane A M. Error correcting codes in quantum theory. Physical Review Letters, 1996, 77(5): 793–797. DOI: 10.1103/PhysRevLett.77.793.
[3] Kitaev A Yu. Fault-tolerant quantum computation by anyons. Annals of Physics, 2003, 303(1): 2–30. DOI: 10.1016/S0003-4916(02)00018-0. arXiv:quant-ph/9707021.
[4] Knill E, Laflamme R, Zurek W H. Resilient quantum computation. Science, 1998, 279(5349): 342–345. DOI: 10.1126/science.279.5349.342.
[5] Fowler A G, Mariantoni M, Martinis J M, Cleland A N. Surface codes: towards practical large-scale quantum computation. Physical Review A, 2012, 86(3): 032324. DOI: 10.1103/PhysRevA.86.032324.
[6] Grassl M, Beth T, Pellizzari T. Codes for the quantum erasure channel. Physical Review A, 1997, 56(1): 33–38. DOI: 10.1103/PhysRevA.56.33.
[7] Saffman M. Quantum computing with atomic qubits and Rydberg interactions: progress and challenges. Journal of Physics B: Atomic, Molecular and Optical Physics, 2016, 49(20): 202001. DOI: 10.1088/0953-4075/49/20/202001.
[8] Browaeys A, Lahaye T. Many-body physics with individually controlled Rydberg atoms. Nature Physics, 2020, 16(2): 132–142. DOI: 10.1038/s41567-019-0733-z.
[9] Barredo D, de Léséleuc S, Lienhard V, et al. An atom-by-atom assembler of defect-free arbitrary two-dimensional atomic arrays. Science, 2016, 354(6315): 1021–1023. DOI: 10.1126/science.aah3778.
[10] Endres M, Bernien H, Keesling A, et al. Atom-by-atom assembly of defect-free one-dimensional cold atom arrays. Science, 2016, 354(6315): 1024–1027. DOI: 10.1126/science.aah3752.
[11] Bluvstein D, Levine H, Semeghini G, et al. A quantum processor based on coherent transport of entangled atom arrays. Nature, 2022, 604(7906): 451–456. DOI: 10.1038/s41586-022-04592-6.
[12] Evered S J, Bluvstein D, Kalinowski M, et al. High-fidelity parallel entangling gates on a neutral-atom quantum computer. Nature, 2023, 622(7982): 268–272. DOI: 10.1038/s41586-023-06481-y.
[13] Scholl P, Shaw A L, Tsai R B-S, et al. Erasure conversion in a high-fidelity Rydberg quantum simulator. Nature, 2023, 622(7982): 273–278. DOI: 10.1038/s41586-023-06516-4.
[14] Bluvstein D, Evered S J, Geim A A, et al. Logical quantum processor based on reconfigurable atom arrays. Nature, 2024, 626(7997): 58–65. DOI: 10.1038/s41586-023-06927-3.
[15] Google Quantum AI. Quantum error correction below the surface code threshold. Nature, 2025, 638(8052): 920–926. DOI: 10.1038/s41586-024-08449-y.
[16] Bravyi S, Cross A W, Gambetta J M, et al. High-threshold and low-overhead fault-tolerant quantum memory. Nature, 2024, 627(8005): 778–782. DOI: 10.1038/s41586-024-07107-7.
[17] Nielsen M A, Chuang I L. Quantum Computation and Quantum Information. 10th Anniversary Edition. Cambridge: Cambridge University Press, 2010. ISBN 978-1-107-00217-3.
[18] Roffe J. Quantum error correction: an introductory guide. Contemporary Physics, 2019, 60(3): 226–245. DOI: 10.1080/00107514.2019.1667078.
[19] Bravyi S, Kitaev A. Universal quantum computation with ideal Clifford gates and noisy ancillas. Physical Review A, 2005, 71(2): 022316. DOI: 10.1103/PhysRevA.71.022316.
[20] Litinski D. A game of surface codes: large-scale quantum computing with lattice surgery. Quantum, 2019, 3: 128. DOI: 10.22331/q-2019-03-05-128.
[21] Google Quantum AI. Suppressing quantum errors by scaling a surface code logical qubit. Nature, 2023, 614(7949): 676–681. DOI: 10.1038/s41586-022-05434-1.