本篇是《Redis Stream 深度:消费者组、Pending 队列与死信处理》的姊妹篇。上一篇把「怎么消费、怎么确认、怎么建组」讲完;这一篇只讲确认之后的事——pending 怎么回收、失败怎么重试到死信、以及 Stream 到底该不该当 MQ。命令表、rax 结构、位点与有界保留在上一篇,本篇不重复。
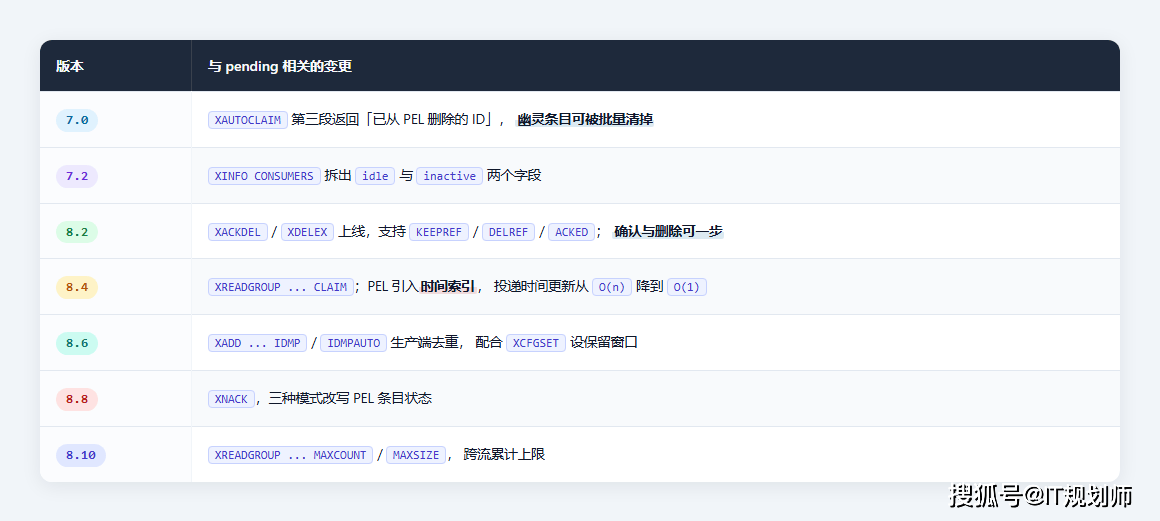
0. 版本基线与四个术语0.1 版本节点
读写属性与 ACL 分类不要凭命令名推测:XACKDEL / XNACK 这类会写 PEL 的命令都属于写命令,XPENDING / XINFO 属于读。ACL 分类之间是「或」关系,只给账号 @write 时执行不了属于 @stream 的 XNACK。
实测边界:7.x 的行为(XAUTOCLAIM 三段、XPENDING 四形态、XCLAIM JUSTID、XGROUP DELCONSUMER、XTRIM 与 PEL、XINFO CONSUMERS 字段、下文两段 Lua)都在 Redis 7.4.2 上实跑核对;8.2 / 8.4 / 8.6 / 8.8 / 8.10 只按官方文档与官方博客核对,未在 8.x 实例实测,上线前以目标版本的 COMMAND DOCS 与实际返回为准。
这几条之所以单列,是因为它们改的都是「确认之后」的语义:7.0 之前幽灵条目只能人工捞;7.2 之前分不清「消费者挂了」和「消费者只是暂时没活干」;8.2 之前必须两步操作;8.4 之前巡检成本随 pending 条数线性上涨;8.10 之前多流读取的总量根本控不住。版本差一年,运维工作量差一倍。
redis 代码块里的 # 行是注释,但 redis-cli 用管道读 stdin 时不识别 #(会报 ERR unknown command '#'),整段执行前先滤掉注释行:grep -v '^[[:space:]]*#' cmds.txt | redis-cli ...。
0.2 四个术语
- entries-read:组已投递的逻辑序号,随投递推进,也会被 SETID 改写。
- lag:entries-added - entries-read 的估算差,XINFO GROUPS 里可能是 NULL。
- delivery-count:这条消息被投递了几次,只在 PEL 里,不等于业务失败次数。
- idle:从最后一次投递或认领到现在的毫秒数,它只是时间戳差值,不是超时器。
0.3 与前一篇的分工
前一篇负责「一条消息怎么被读到、怎么被确认」;本篇负责「确认之前卡住时怎么办」。两篇的流名与消费者命名可以对照着看,代码可以拼接使用。
1. 为什么 pending 是分水岭「Stream 能当队列」与「Stream 能当可靠队列」之间只隔一件事:未确认的消息会不会自己消失。PEL 就是那道账,账不平,前面所有「至少一次」的承诺都是空话。
三处最容易先入为主的判断:
- 读到了就算消费了。读只把消息搬进 PEL,业务没执行、没确认,消息仍然活着;进程重启后它还在,但没人把它捞回来。
- pending 多了就是消费慢。可能是消费者崩了、卡在死循环、或者消息被 XTRIM 裁掉了正文成了幽灵条目——三种原因的处理方式完全不同。
- 投递次数多就是这条消息有问题。delivery-count 会因为巡检、认领、FORCE 而上涨,跟业务失败没有一一对应关系。
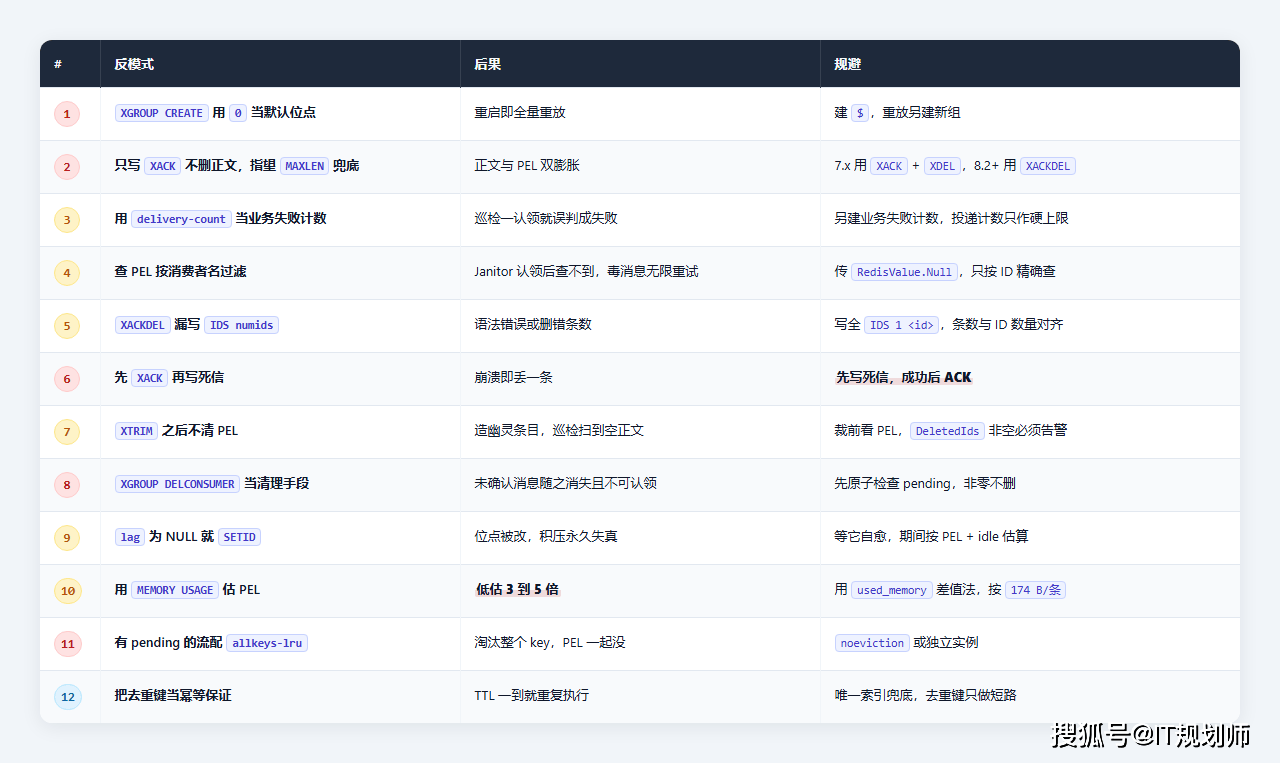
这三处落到具体条目,第 6 章的反模式表按「现象 + 根因 + 规避」逐条列,这里只做定位。
为什么会有「Stream 就是轻量 MQ」的印象?因为正常路径确实像:XADD 写、XREADGROUP 读、XACK 确认,四行命令就能跑通。分水岭只出现在异常路径——消费者崩了、消息卡住了、正文被裁了。正常路径的简单,掩盖了异常路径的全部工程量。
2. PEL 是一本独立账:状态机与六个业务影响2.1 两层 PEL 与四个字段
Redis 有组级 PEL(记录每个组里未确认的消息)和消费者级 PEL(记录这些消息归谁)。两层都指向同一批消息 ID,但删除任意一层都不代表另一层同步清掉,所以排查时要分清看哪一层。
XPENDING 明细每行四个字段:消息 ID、所属消费者、idle 毫秒、delivery-count。这四个字段决定了后续所有判断——超时看 idle、毒消息看计数、归属变化看消费者名。
排查时先定层:XPENDING <key> <group> 给组级概要,XPENDING <key> <group> - + 10 <consumer> 给某个消费者的明细,XINFO STREAM <key> FULL COUNT 10 把两层一起摊开。三者数字对不上,通常说明有消费者被 DELCONSUMER 删过——那批消息已经不在任何一层里了。
2.2 状态流转
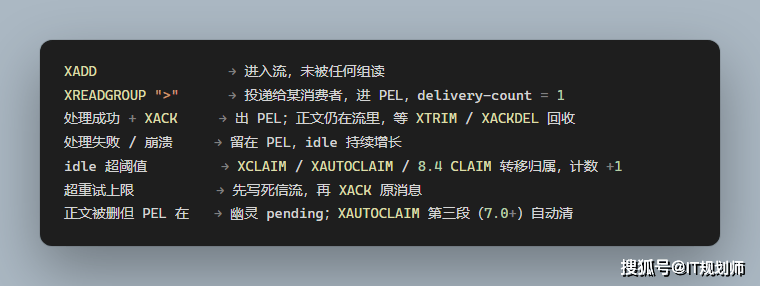
2.3 影响一:至少一次,幂等是前提
XREADGROUP 的语义是至少一次:崩溃、认领、重复投递都会让同一条消息被执行两遍。所以业务副作用必须自带幂等键,最省事的是用业务主键(订单号 + 事件 ID)建唯一索引,而不是指望「Stream 保证只执行一次」。
幂等键有两种选法,取舍不同:只写业务主键(订单号)最稳,但同一订单的不同事件会被当成重复;只写事件 ID 更细,但要求生产端能稳定生成、且在重放时不变。多数系统用「业务主键 + 事件类型」的组合,把唯一性交给数据库唯一索引,Redis 去重键只当快速短路。
2.4 影响二:PEL 是独立内存开销,不会随时间自己缩小
PEL 条目在 ACK 之前一直驻留内存;它不会因为时间流逝或反复投递而变少,只有 XACK 与 XACK DEL 系列才让它缩小。增长路径有三条:消费速率低于生产、异常分支漏写 ACK、死信不处理导致失败消息永久挂着。它还会拖慢巡检扫描,所以「PEL 总数」比「流长度」更该进告警。
单条开销有两种口径,别混:
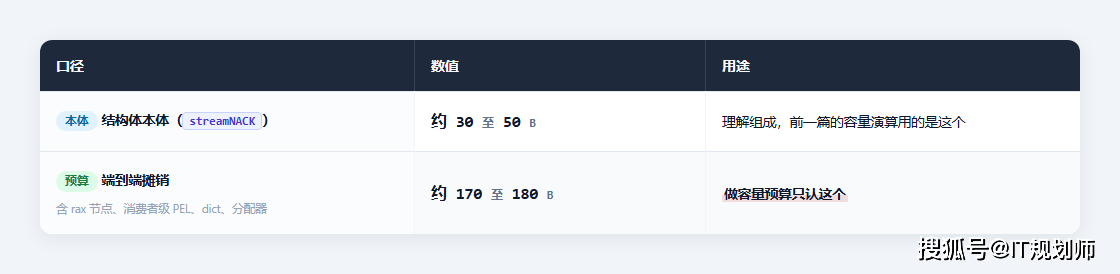
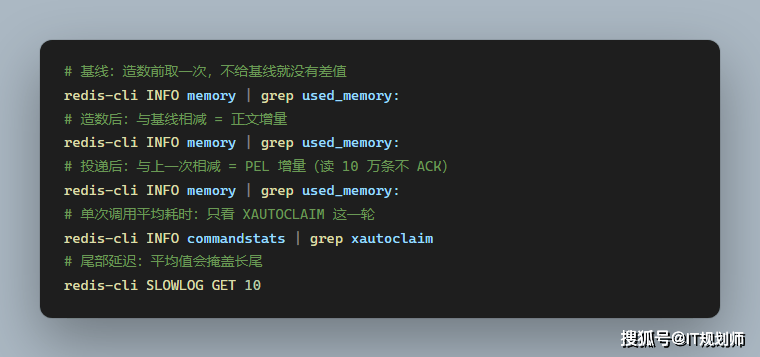
后者来自官方博客的差值法实测:插入 20 万条后读入 PEL,内存从 6.80 MB 增到 41.53 MB,增量 34.73 MB,折合约 174 B/条;8.4 的时间索引再加 3.55 MB(3.55 / 41.53 约 8.5%),同一口径约 17.8 B/条。只按 30 至 50 B 做预算会低估 3 到 5 倍,一次消费者故障就能顶爆内存。
8.4 的时间索引换来了什么:在此之前每次投递都要沿 PEL 链表找到记录再改时间,pending 多时是 O(n);加了索引之后按时间定位,接近 O(1)。代价是每条 pending 多 17.8 B,以及写路径多一次维护——一笔典型的「用内存换 CPU」。它也让「按 idle 排序找毒消息」从全表扫描变成范围查询。
2.5 影响三:一套「可见性超时」,但阈值要你自己定
XPENDING 看 idle、XCLAIM 按 min-idle-time 认领,组合起来等价于 SQS 的 visibility timeout。但 idle 不是超时器:Redis 到点不会自动判死、也不会自动重投,超时完全是业务定义的阈值。
下限要大于正常处理耗时的 p99 加 ACK 往返,经验取正常耗时的 3 到 5 倍(处理 300 ms 取 5 至 10 s,处理 30 s 取 90 s 左右)。上限是能容忍的最长恢复延迟;若允许重试 N 次,第 k 次重投的等待量级约为 k × min-idle-time,据此反推。
阈值设错有两种典型故障。设太短:消息还在处理就被抢走,同一事件被执行两次,日志里能看出重复但错误率指标不动。设太长:消费者真的崩了也要等很久才有人接管,表现为「积压不降、idle 一直涨」。两者都不体现为报错,只能从 idle 分布里看出来。
2.6 影响四:投递计数不等于业务失败次数
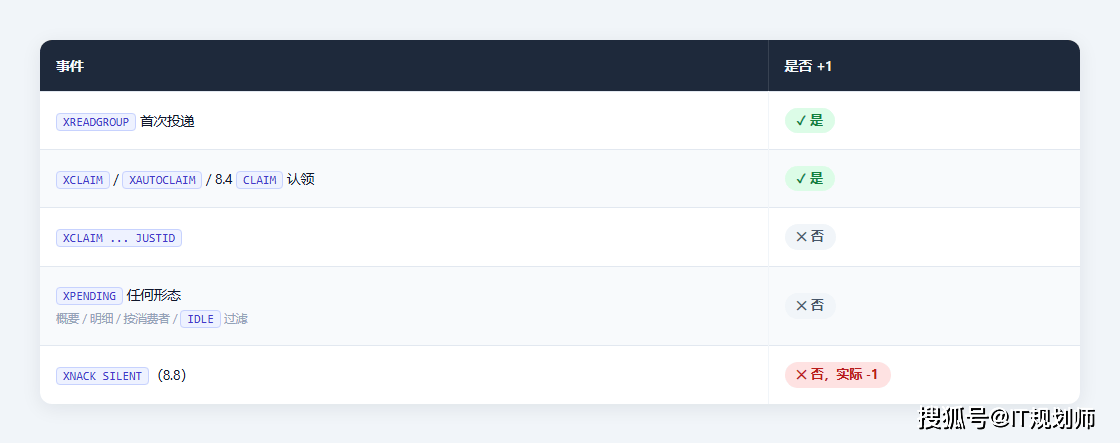
结论很直接:重试判据用业务失败计数,投递计数只作硬上限。两条都测过——XPENDING 连读三次,计数仍是 1;IDLE 过滤把 idle 归零但不改计数,而且它只筛不排,返回仍按 ID 升序。
2.7 影响五:幽灵 pending 有两条读取路径
正文被 XDEL 或 XTRIM 删掉、PEL 却还在,就成了幽灵:XPENDING 还能看到它,XREADGROUP 按具体 ID 读回来是空正文,投递计数照样涨。清它有两条路——XAUTOCLAIM 的第三段返回会把它从 PEL 删掉(7.0+),或者自己扫 DeletedIds 后补 XACK。XTRIM 只动正文不动 PEL,所以「裁剪」本身就是造幽灵的动作。
识别方法最省事的是对照两条命令:XPENDING 里能查到某个 ID,XRANGE <key> <id> <id> 却返回空数组——这种组合基本可以断定正文先被删了。巡检看到它,不要重试业务,直接清 PEL 并告警。
2.8 影响六:集群、副本与持久化的四条硬边界
- 集群:Stream key 不会自动分片,大 key 只落在单分片;要么业务上分片(orders:{shard}),要么提前迁走。
- 副本:主从复制的是命令流,XAUTOCLAIM 的扫描在从库上不能替你分担——读扩展对 PEL 巡检无效。
- 持久化:AOF everysec 下最多丢 1 秒的写入,但那 1 秒里可能正包含 XACK,「确认丢了」比「消息丢了」更难查。
- 内存淘汰:maxmemory-policy 一旦触发淘汰,Stream 可能被整个 key 删掉,PEL 随之消失且不可恢复;有 pending 的流必须配 noeviction 或独立实例。
这四条的共同点是都不会在正常路径上暴露:集群不均只表现为某个分片内存先满;副本延迟只表现为故障切换后少量重放;AOF 丢的那 1 秒只在崩溃那刻才出现;淘汰更是静默删 key。四条都需要提前配置,事后补不了。
2.9 不可逆操作
XGROUP DELCONSUMER 会连同该消费者名下未 ACK 的消息一起丢掉,删完 XPENDING 返回 0 / nil / nil / nil,消息再也认领不回来;XGROUP SETID / XSETID 改位点会造成大范围重放或永久丢消息。这两类操作要么双重校验,要么干脆不碰,重放请新建一个组来做。
2.10 八行骨架:自己看一眼
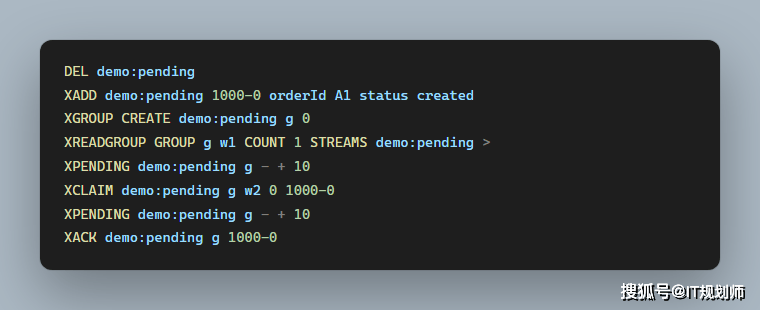
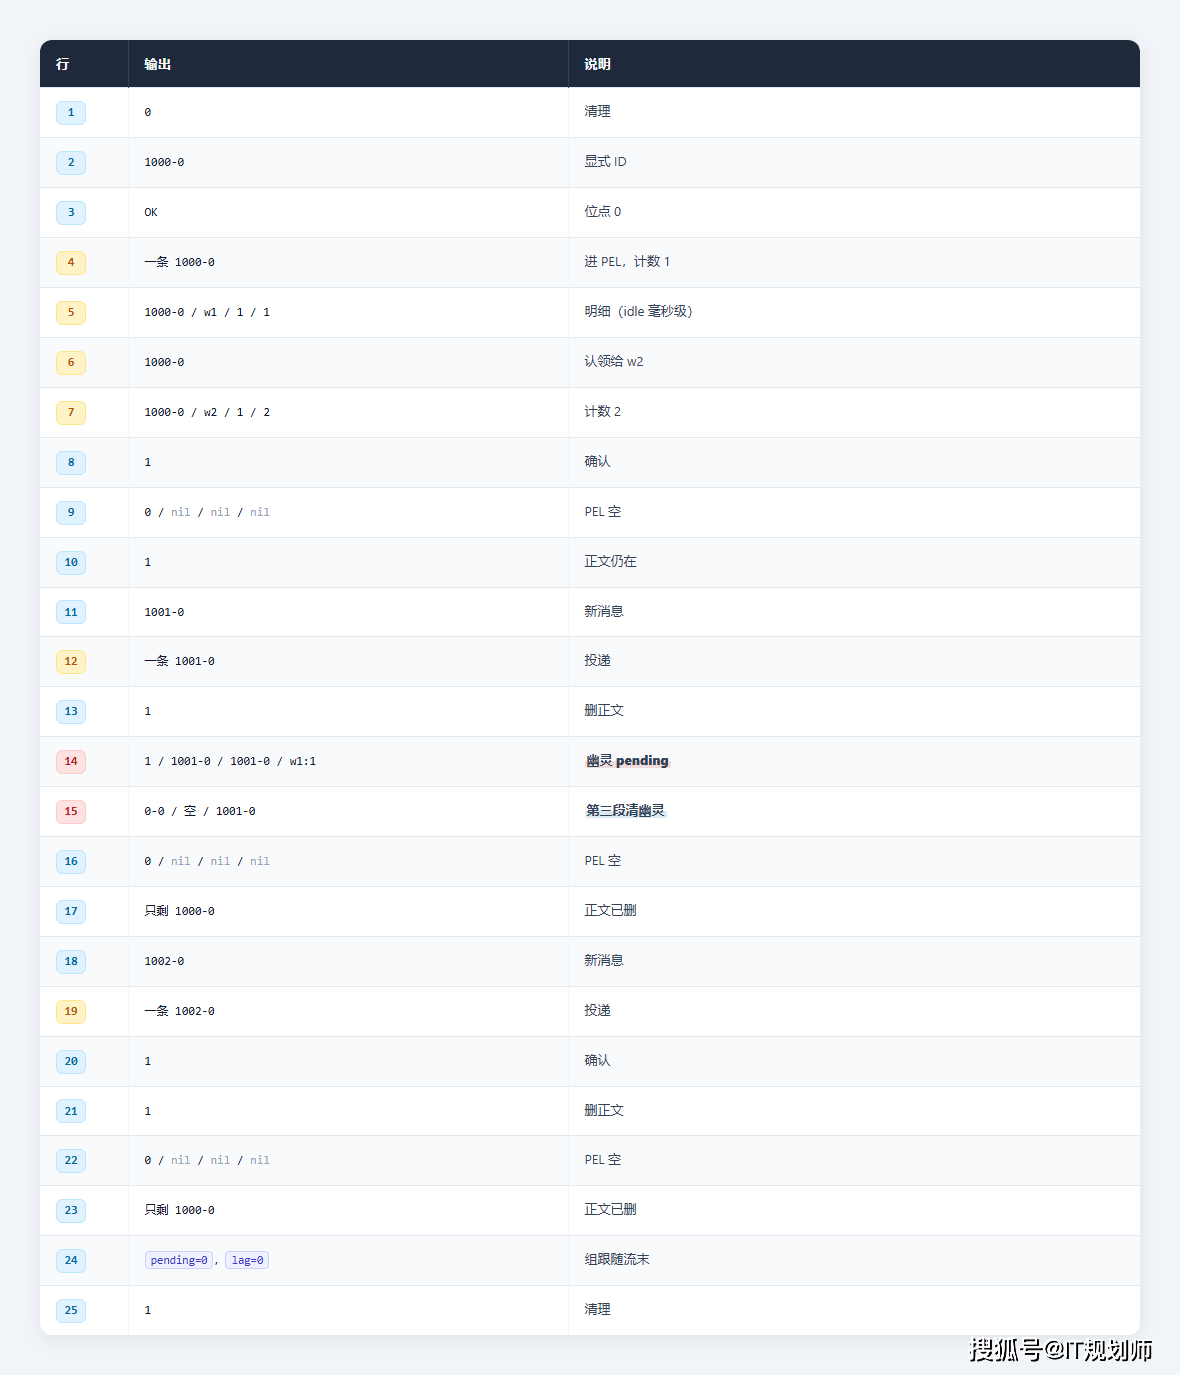
预期依次是:1 → 1000-0 → OK → 一条投递 → 1000-0 / w1 / idle 1 / 1 → 1000-0 → 1000-0 / w2 / idle 1 / 2 → 1。idle 是毫秒级计时,实测为 1(随机器与执行速度可能为 0 或 1),后文一律按实测值写。第 7 行计数从 1 变 2,就是「认领会让计数上涨」的直接证据;第 5、7 两行都是 XPENDING,计数不变,就是「查询不改计数」的直接证据。本块不写注释以便整段管道执行。
3. 命令与客户端:能做什么、版本差在哪3.1 XPENDING 的四种看法
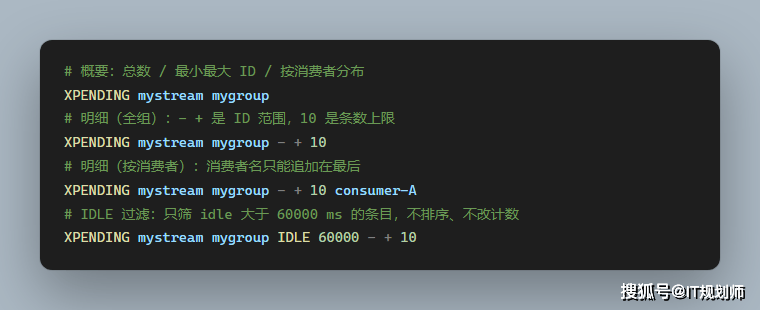
四种形态都不改投递计数,这是最容易误判的一点。要按 idle 找毒消息,用第四种;要确认某条消息归谁,用第三种。
概要形态最容易被误用成「积压监控」:它给的是未确认总数,不含那些还没被任何消费者读到的消息。真实积压要把 lag 一起看,只盯 PEL 会把「生产太快」误判成「消费太慢」。
3.2 XCLAIM 与 XAUTOCLAIM
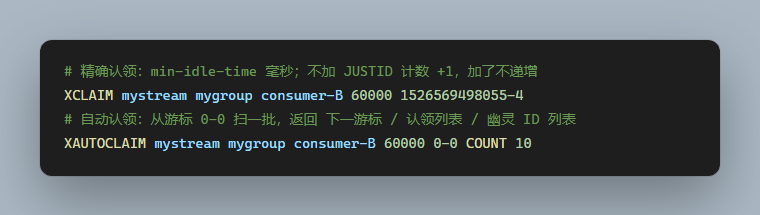
XCLAIM 是单条、要你知道 ID;XAUTOCLAIM 是批量、给你一个游标自己往下扫。生产巡检用后者,重试单条用前者。COUNT 的扫描上限是它×10,别指望 COUNT 10 就只扫 10 条。
XCLAIM 还有两个修复型参数:FORCE 允许认领不在 PEL 里的 ID,用于修 PEL 与正文不一致;LASTID 把组的 last-delivered-id 一并推进。它们都是修复手段,正常重试路径不要碰。
3.3 8.2:确认与删除合成一步
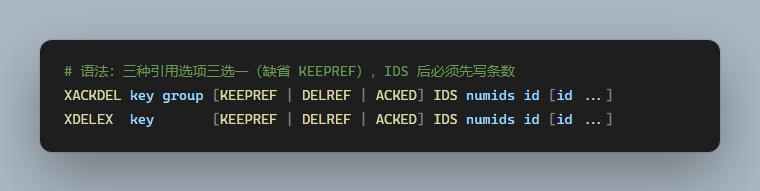
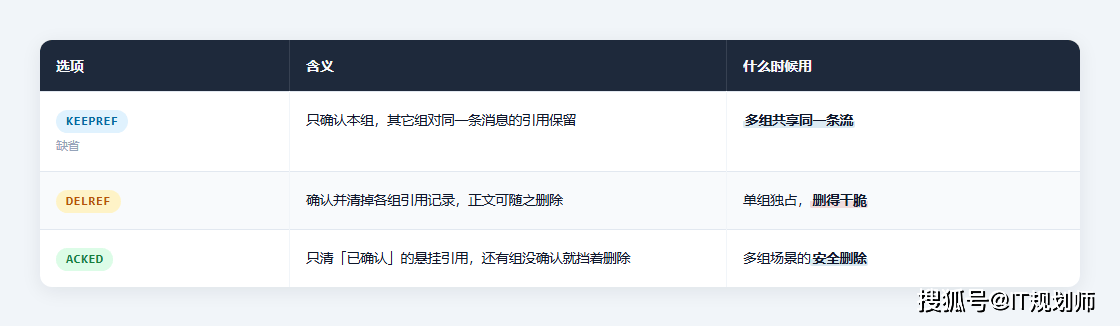
7.x 只能 XACK + XDEL 两步走,中间崩溃就留幽灵;8.2 起一条命令原子完成。IDS numids 里的 numids 必须写,这是最常漏的参数。
返回值表达的是「删掉了多少」,不是「成功与否」:部分 ID 不存在时不报错,只是少删。多组场景先用 XPENDING 确认各组状态再选选项,否则容易出现「以为删了、正文其实还在」的错觉。
3.4 8.4 的 CLAIM 与 8.10 的上限
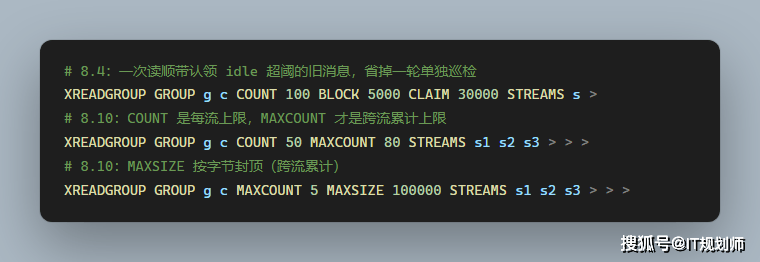
官方基准把 CLAIM 的收益量化成 22.5 倍:20 万 pending、1 千条 idle、COUNT=1000、重复 1000 次,单次往返 54.671 ms 对 2.426 ms。这个倍数不是通用常数——它取决于一次扫描里真正可认领的条数 n 与扫描上限 k 的比值,n/k 越小,省下的往返越少。量和版本都对不上时,别拿它当承诺。
有了 CLAIM 是不是就不需要 Janitor?单实例、单流的轻量场景可以省;只要涉及多实例或独立告警,Janitor 仍然要有——CLAIM 只解决「顺带认领」,不解决「谁负责监控与上报」。
3.5 8.8 的 XNACK
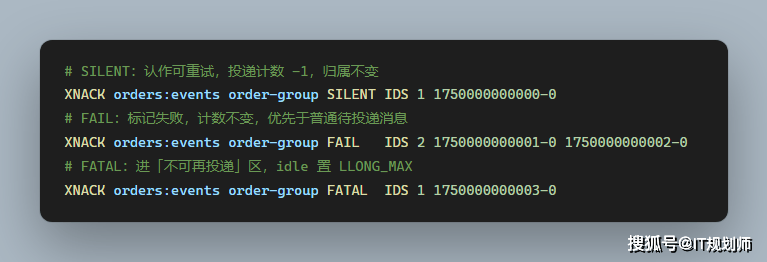
它的价值是把「这条没处理成」这件事写回 PEL,而不是靠业务侧计数推断。ACL 上只有 @stream,只授了 @write 的账号执行不了。
别把它当「重试开关」:SILENT 只是把计数减 1,不会让消息提前可投递;什么时候能被再投递,仍由 min-idle-time 决定。
3.6 .NET 签名与六个坑
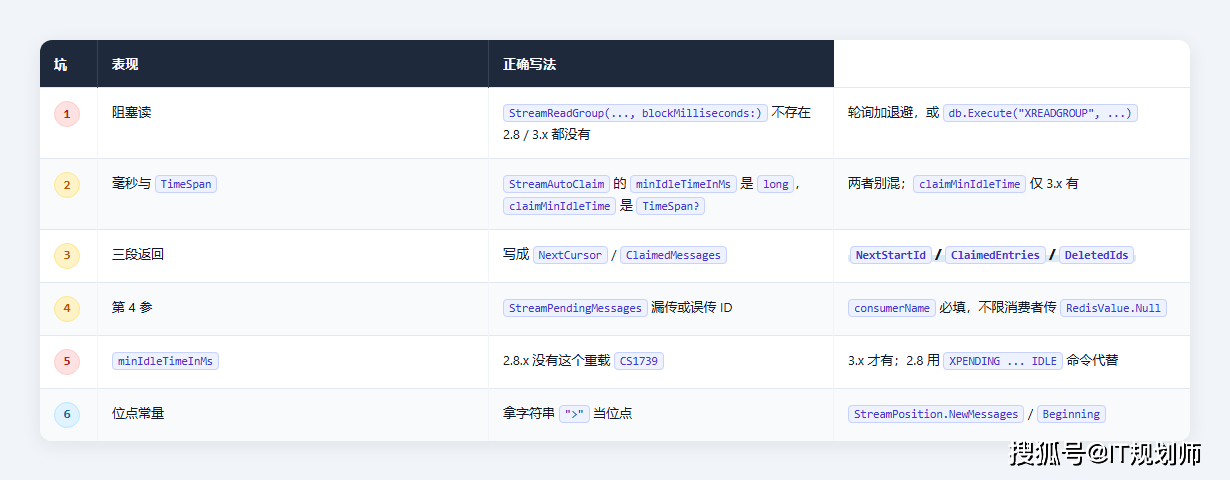
六个坑里四个是「参数名或类型对不上」,两个是「语义理解偏差」,都属于编译期或第一次上线就能撞到的类型。把这张表贴进项目 README 比读官方 XML 快。
坑 4 最典型:正文里按 ID 精确定位时,StreamPendingMessagesAsync(_stream, _group, 1, RedisValue.Null, minId: id, maxId: id)——第 4 参省掉会直接编译失败(2.8.x 报 CS7036、3.x 报 CS1501)。
4. 生产闭环:主循环、巡检、死信、容量与监控4.1 三层
主循环管「读」和「处理」,Janitor 管「超时回收」,死信流管「放弃」。三者共用同一套幂等与失败计数,任何一层单独加上去都会漏。少 Janitor,卡住的消息永远等不到第二次机会;少死信,重试会变成无限循环;少统一幂等,前两者都在制造重复执行。
4.2 主循环

三点值得单说。第一,建组用 $ 而不是 0:用 0 会在重启时把历史消息全量重放一遍,正确做法是建成 $ 后靠 Janitor 回收历史(0 只用于有意重放)。第二,查 PEL 必须不限消费者,否则 Janitor 认领过的消息查不到,计数永远为 1。第三,死信与 ACK 的顺序不能反。
还有一处容易被忽略:BatchSize 不要设大。一次拿 10 条的吞吐不比拿 100 条低多少,但单批过大会让 idle 分布失真——排在队尾的那几条还没开始处理,计时已经在走,巡检会把它们当成「卡住的」提前抢走。
4.3 Janitor
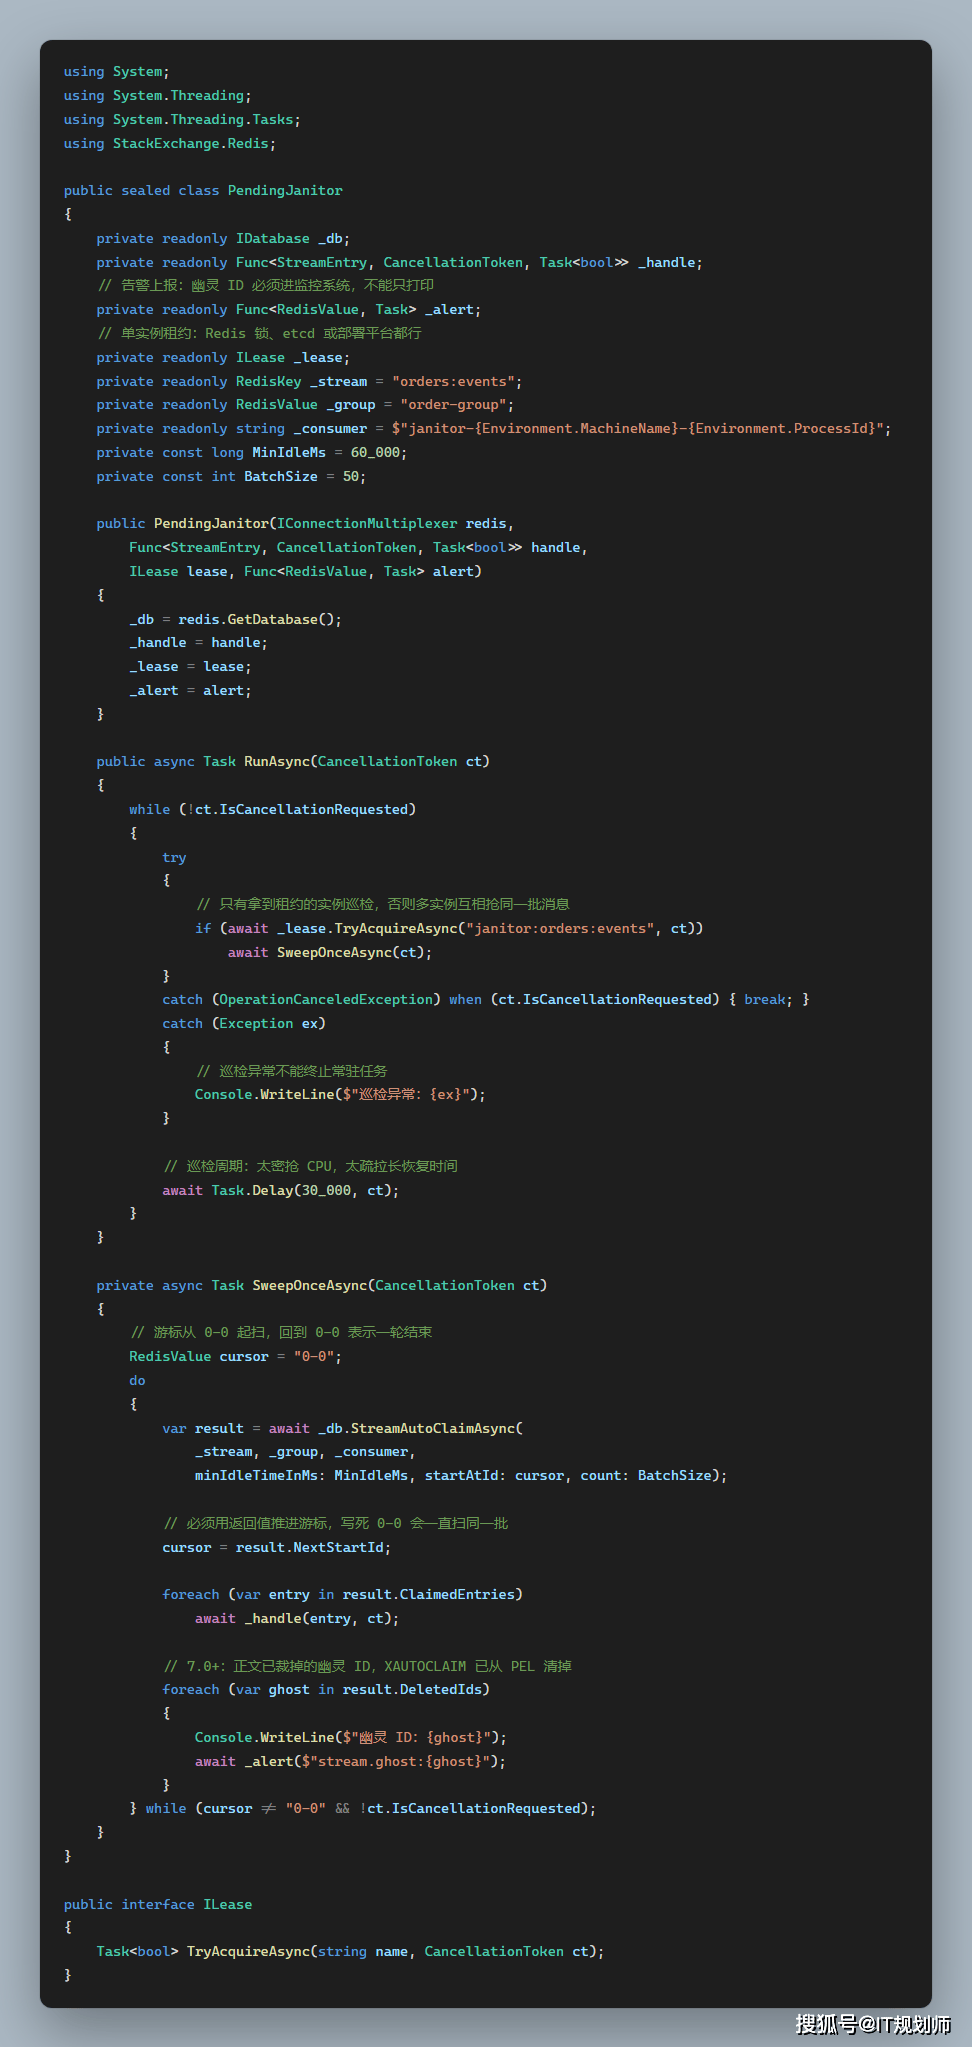
SweepOnceAsync 里有两个必须守住的细节:游标用返回值推进;DeletedIds 非空说明有消息被裁剪吃掉过,这是「MAXLEN 设小了」的告警信号,必须上报而不是丢掉。Janitor 与主循环共用 ProcessSafelyAsync,所以死信判定不会出现两套。
4.4 死信闭环的五条规则
- 先写后删:死信成功写入才 ACK 原消息,顺序反了崩溃就丢一条。
- 写全上下文:原始 ID、完整字段、错误信息、失败次数、时间戳。只写 ID 等于把排查工作推给未来。
- 死信流也要上限:MAXLEN ~ 100000,否则死信本身会变成新的内存炸弹。
- 死信要有消费方:写了没人看只是把丢消息推迟了;死信流的消费必须能告警、能重放、能人工接管。
- 转存也要幂等:同一条消息可能被两个实例同时写进死信,用原始 ID 做去重键。
字段设计比命令重要:至少要原始 ID、原始字段、错误、失败次数、写入时间。缺了原始字段,重放时只能靠猜;缺了失败次数,分不清是「第一次就炸」还是「重试 20 次才炸」。
4.5 安全删除消费者
删除前必须先确认没有 pending,否则未确认的消息随之消失且不可认领。检查和删除要原子:
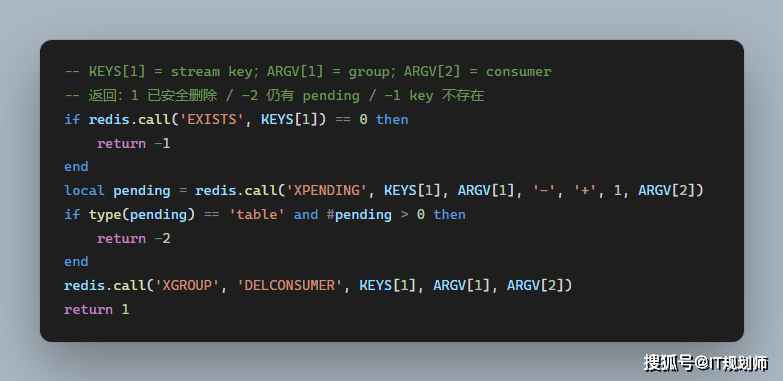
7.4.2 上三种输入分别返回 -2 / 1 / -1,与注释一致。
4.6 幂等与按业务主键保序
去重键(SET ack:{eventId} 1 NX EX 86400)只能做快速短路,TTL 一到、消息被认领,它挡不住重复;真正的幂等靠数据库唯一索引,而且去重键的置位与业务写入要在同一事务语义里,只在业务确认成功后才 ACK。
保序上,Stream 本身只保证同一条流内按 ID 有序,跨消费者不保证处理顺序。要按订单保序,只能用「同一主键路由到同一消费者」加单消费者串行;跨进程(Janitor 认领、扩容)仍要靠业务版本号兜底,所以去重、版本校验、主键路由通常要一起上。
版本号兜底的具体做法:消息体带业务版本(seq 或 updatedAt),落库时走 WHERE seq > 已存 seq 的条件更新,重复与乱序到达的写入自然被拒,不需要额外加锁。
4.7 容量估算

三组演算只给量级参考,实际值必须按 4.8 的方法自测后替换。20 万条 200 B 消息、1 万条 pending:正文约 40 MB、PEL 约 1.7 MB、时间索引约 0.18 MB;把 pending 抬到 20 万,PEL 一项就变成约 35 MB,比正文还大——这就是 2.4 节强调双口径的原因。
再给一组容易被漏算的:1 万条 100 B 消息、挂在 10 个消费组上、每组各 1 万 pending。正文约 1 MB,每组 PEL 约 1.7 MB,十组合计约 17 MB——PEL 是正文的 17 倍。多组共享一条流时,成本按组数线性叠加,这是预算里最容易缺的一项。
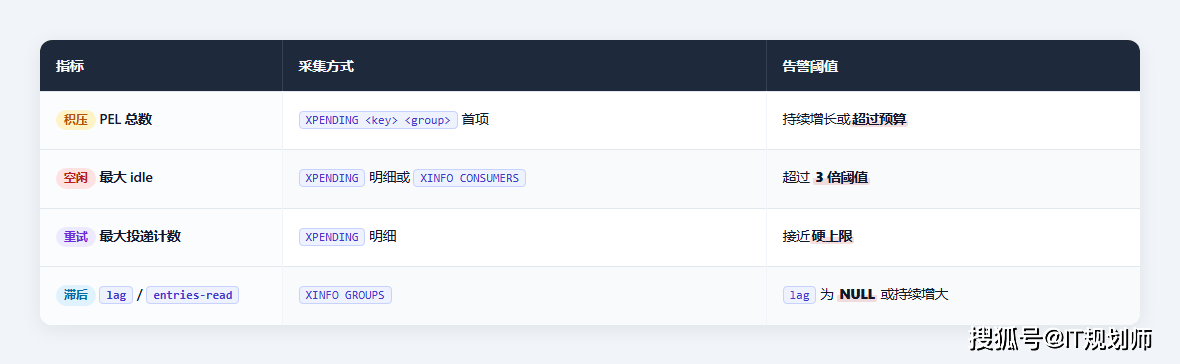
4.8 监控与自测
自测用差值法,不要信 MEMORY USAGE——它不算 PEL:
lag 为 NULL 时不要慌,也不要 SETID。NULL 的成因之一是组位点被改过,而它本身是暂时态:一旦该组把流里最后一条消息投递给成员,entries-read 会被重置为正确值,lag 自动恢复。NULL 期间按「PEL 总数 + 最大 idle + XLEN 增速」估算积压,告警降级为观察。采集频率不必高:PEL 总数 1 分钟一次、最大 idle 5 分钟一次、lag 跟 XLEN 一起采就够。巡检脚本自身也要限流,XPENDING 明细在大 PEL 上是重命令,按秒刷会把巡检变成新的负载源。
还要记住两条:只看 XLEN 会漏(消息全投递出去后 lag 可以是 0、XLEN 稳定,但 PEL 在涨);只看平均值会漏尾部(总量正常不代表没有几条 idle 极大的毒消息)。
5. 场景与选型:什么时候用、什么时候走5.1 延迟队列:ZSet 触发 + Stream 消费
ZSet 存「到期时间」,到点后原子取出写进 Stream 再消费。取出的原子性用一段 Lua 保证:
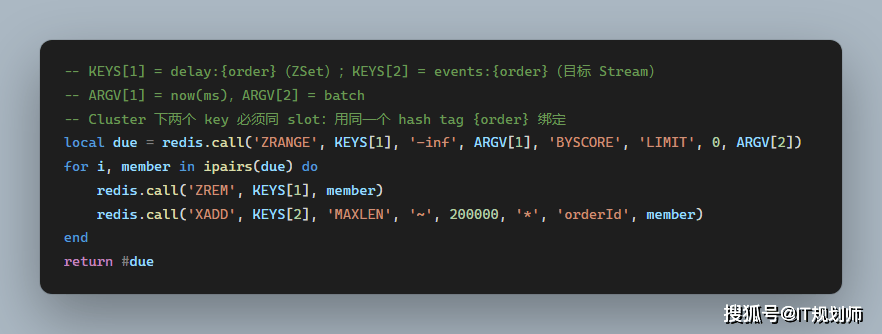
7.4.2 上到期两条、未到期一条时返回 2,ZCARD 剩 1,Stream 里正好两条——取出与删除在同一脚本里,不会出现「取到但没删」的重复触发。
5.2 三个专题的结论
- 事件溯源:一条业务事实一条消息,投影函数必须是纯函数,XRANGE - + 全量重放、XRANGE - <id> 定点重放都能复现同一状态。
- 消息体:超过数 KB 的对象放外部存储,Stream 里只放引用;大消息会把 rax 节点与复制缓冲一起推高。
- 物联网遥测:按设备哈希分片(device:events:{sh}),幂等键用 dev:ts,去重键只做短路,唯一索引兜底。
三个专题的共性是:消息只是载体,真正的成本在「怎么重放、怎么去重」。先把重放路径想清楚,再决定消息里该存什么——存了外部引用就必须保证引用可长期取回,存了全量就要接受内存成本。
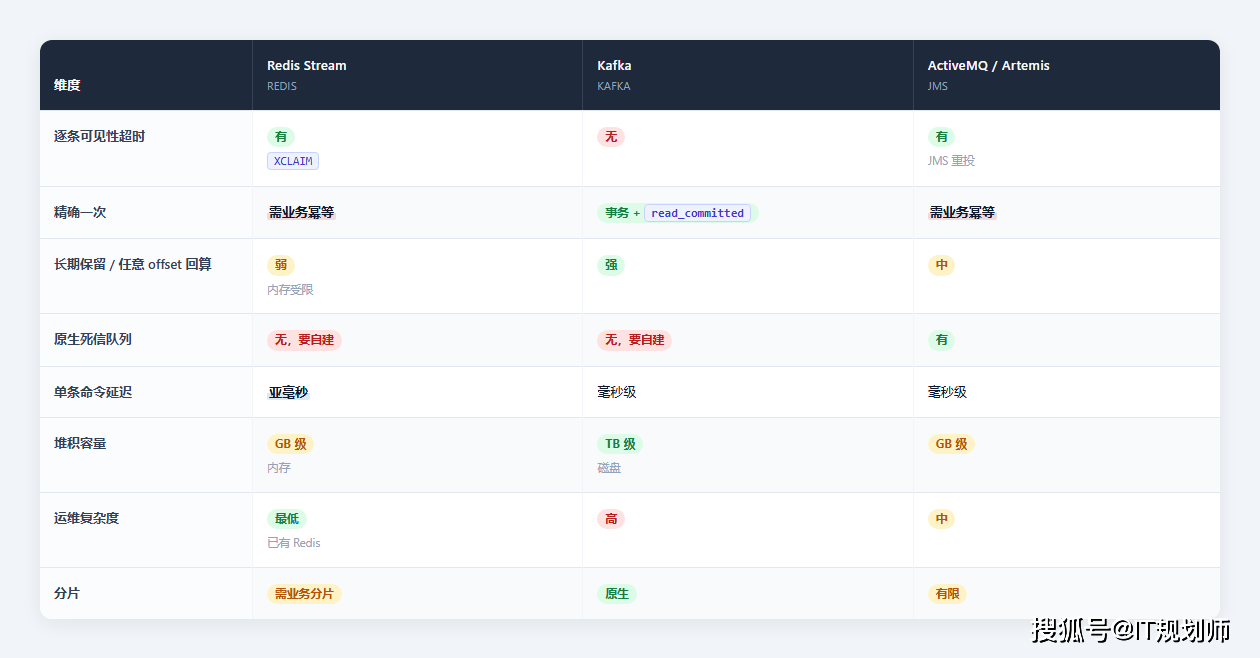
5.3 选型矩阵
5.4 三个反直觉的真相
- 省下的是 MQ,付出的是工程量。Stream 不用新组件,但巡检、死信、幂等、容量、监控这五件事全要自己写,算下来是「一个 MQ 换成一套代码」。
- COUNT 是每流上限,不是总量。多流同时读时用 COUNT 控总量会超预期,8.10 的 MAXCOUNT 才是跨流累计。
- XACKDEL 不是万能的。多组共享同一条流时,KEEPREF 让正文删不掉,得用 ACKED 或等所有组确认;单组场景才敢用 DELREF。
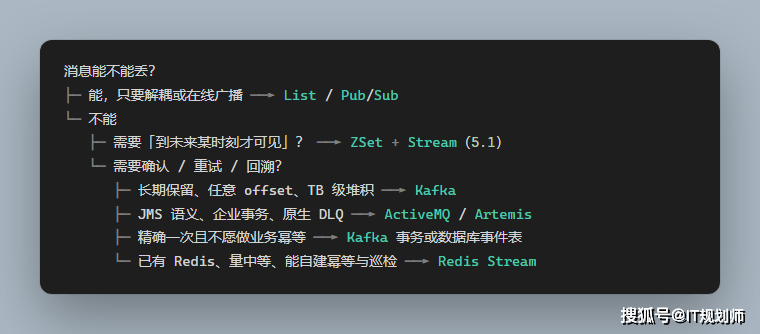
三条合起来是一句话:Stream 的甜点在「已有 Redis、量中等、愿意自建运维件」的交集里,离开这个交集就要交学费。
5.5 决策树
5.6 什么时候迁走
三条信号:单 key 内存超过实例预算的一半;pending 巡检的单次耗时进入秒级;业务开始要求精确一次或跨天回放。迁出路径是双写 + 位点对齐:新系统先只读不删,等 Stream 侧积压归零再切写,最后用原始 ID 核对一致性。
回滚方案要提前写:切流后保留 Stream 侧只读窗口至少一个巡检周期,确认新系统无遗漏再关写。没有只读窗口,回滚就等于再赌一次。
6. 反模式与上线自检6.1 十二条反模式
6.2 十八项上线清单
- 1. 建组位点确认为 $,重放走新组
- 2. MAXLEN / MINID 有值,且与容量预算对得上
- 3. maxmemory-policy 为 noeviction 或独立实例
- 4. 主循环无阻塞读,用轮询 + 退避
- 5. 客户端版本与 API 对齐(claimMinIdleTime / minIdleTimeInMs 仅 3.x)
- 6. 查 PEL 不限消费者
- 7. 失败计数与投递计数分离
- 8. 死信先写后 ACK,且带原始 ID 与错误
- 9. 死信流有消费方与告警
- 10. min-idle-time 大于 p99 处理耗时
- 11. Janitor 单实例(租约或部署约束)
- 12. DeletedIds 非空必须告警
- 13. 消费者删除走原子检查脚本
- 14. 幂等键为业务主键,唯一索引兜底
- 15. 按主键保序时确认路由规则
- 16. 监控采集 PEL 总数、最大 idle、最大计数、lag
- 17. 容量按 174 B/条 PEL 做预算
- 18. 8.x 命令在目标版本上复核过
清单按「配置 → 代码 → 运维」的顺序过:前 4 项不过就不用往下看,它们是塌方式的;中间 8 项决定异常路径能不能走通;最后 6 项决定故障时你能不能看见。
附录 A. 可判定验证脚本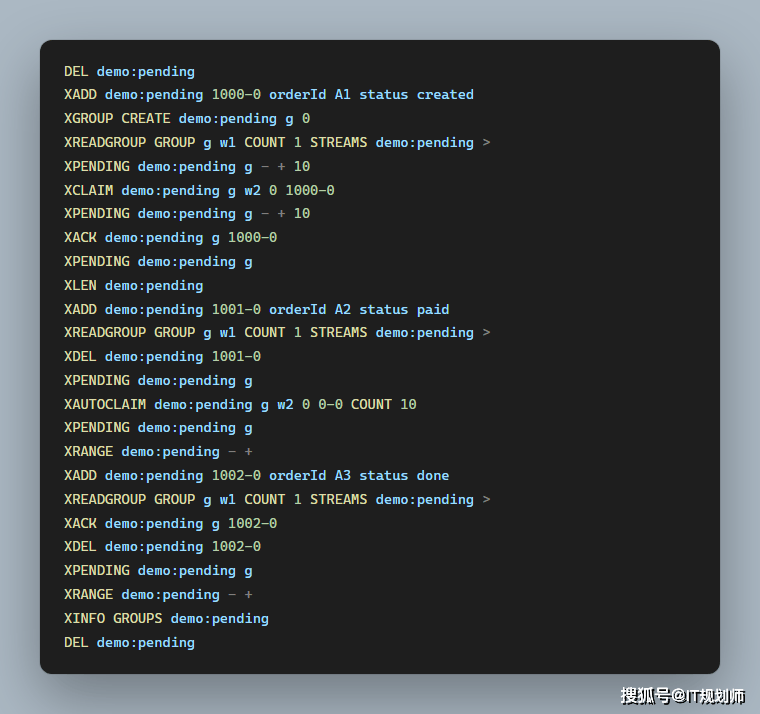
预期(7.4.2 实测全中;脚本与表格按行号对应,所以正文不写注释):