11月11日消息,今天,Google 正式向开发者、企业、科学家和广大用户推出 Gemini 4 Carbon。作为 Google 迄今为止最强大的模型,Carbon 在复杂知识工作、软件工程、网络安全以及科学推理等长周期智能体工作流中展现出了前沿的性能。

两周前,Google 通过 “Fairwind 计划” 将 Carbon 开放给了一部分网络安全专家。继近期发布 Gemini 4 Argon 之后,Carbon 再一次刷新了技术的边界。
Argon 仍然是绝大多数软件工程和知识工作的理想选择,而 Carbon 则专为挑战模型智能极限的任务而生——例如复杂的、多步骤的编码与调试,以及开放式的科学研究与探索。它通过消耗比 Argon 更多的 token 来进行深度探索、缜密推理并运行扩展验证循环。
在评估真实工作流中模型性能的独立基准测试中,Carbon 兼具顶尖的准确性及出色的性价比。它在 CursorBench 4.0、Perplexity 的 WANDR 以及 Zapier 的 AutomationBench 上均排名第一,且单个任务的成本比同类次优模型低了 2 倍以上。
为了将 Carbon 的强大能力应用到更大、更复杂的项目中,Google 在 Google Antigravity 中推出了 /swarm 预览版,该功能可以将单个提示词转化为一个可实时追踪的协同智能体团队。开发人员可以将 Carbon 分配给需要最深入推理的角色,例如架构设计、协调和审计,同时将其与并行隔离的工作区中速度更快、重量更轻的模型以及对抗性验证器相结合,以测试每一次变更。
Gemini 4 Carbon 现已通过 Google AI Studio 中的 Gemini API 和 Gemini for Business 面向所有付费开发者和企业用户推出,其首发体验价与 Gemini 4 Argon 相同(每百万输入 token 2 美元,每百万输出 token 10 美元)。
更高精度的知识工作、作品生成与数据分析
Gemini 4 Carbon 涵盖法律、财务和企业运营等多个领域,它融合了前沿的视觉理解、推理能力和全面检索功能,能够从大量密集文档和数据中提取出切实可行的洞察。它遵循严格的模式和格式,生成精美且精准的电子表格、演示文稿和报告。
现有的基准测试无法充分反映智能体如何处理包含图表、图像、蓝图、示意图和表格等密集型文件的原生推理能力,因此我们与 Artificial Analysis 合作推出了全新的多模态知识智能体 (MKA) 基准测试,用于评估模型在 Agent 流程中的多模态表现。Carbon 在该基准测试中排名第二,同时其单项任务的平均成本比排名第一的模型低 6 倍以上。
在发布前评测中,Carbon 在 Hebbia 的 E2E 金融智能体评测中展现出了与所测试最佳模型持平的深度金融研究能力,并在 Balyasny Asset Management 的通用金融智能(General Financial Intelligence)基准测试中,在 23 个前沿模型配置中跃居榜首,该基准测试涵盖法律专业知识、智能体工具的使用和执行、编码和数据工程以及感知和上下文理解等多个领域。
改进的智能体编程、全栈开发以及 3D 和 UI 设计
Carbon 在需要多智能体协作的工程任务中表现极为出色,例如多包迁移、跨子系统根本原因排查以及复杂的架构重构。对于 Web 应用开发,它能运行“构建并验证”的循环、从错误中自动恢复,并同时检查代码和渲染出的 UI,从而构建出完整、可运行的应用程序。其更强的视觉设计、空间推理能力以及对环境细节的关注,也同样适用于 3D 游戏开发和创意编程。
前沿的网络安全能力
Gemini 4 Carbon for cyber 为 Google 带来了迄今为止最强大的网络安全能力,为安全团队保护关键软件提供所需的端到端智能。
通过 Fairwind 计划访问时,Carbon 在发现(SEC-bench Pro)、利用(ExploitGym)和修补(CWE-bench v1)漏洞的关键基准测试中处于领先地位:它能够检查软件、追踪漏洞如何在不同系统之间被串联利用,并生成经过验证的根本原因修复补丁。
Google 内部与外部的早期测试者在实践中都已见证 Carbon for cyber带来的显著成效。
在 Project Fortify(Google 扫描、分类排查与修复的自主系统)中,Carbon 在我们的内部基准测试中在扫描方面实现了 100% 的召回率以及分类排查方面 95% 的准确率。
在开源代码库测试中,相较于 Argon 既有的高召回率,Carbon 进一步提升了 25% 以上,成功挖掘出此前未被发现的真实逻辑漏洞。将这些成果推广应用于 Google,作为全球最大的开源软件用户之一,不仅有助于保障我们自身的系统安全,也为整个开源生态系统的安全提供了助力。
Google Cloud 安全漏洞研究(CVR)团队最近使用 Carbon 证实了一款流行的开源软件中的两个 Bug 实际上属于可利用漏洞,其严重程度与近期的 PHP2Shell 漏洞相当。通过借助 Carbon 构建概念验证,CVR 团队协助运营人员将该 Bug 重新定义为高危级别并迅速发布了补丁。详细信息将在负责任的漏洞披露流程结束后予以公布。
作为 Wiz 的“Scan for Good”计划的一部分,团队使用 Carbon for cyber 来评估公共数字基础设施中的漏洞。例如,在针对两家大型 SaaS 提供商进行扫描时,该模型在两小时内便发现了 0-day 漏洞,将原本需要数周的漏洞研究时间缩短至一个下午。团队与受影响机构紧密合作并创纪录地完成了修复,从而帮助降低了对数万家公司的潜在影响。
更强的科学与数学推理能力
Gemini 4 Carbon 在物理、数学和生命科学领域的推理能力显著提升,能够综合实验数据、验证假设,并针对多步骤的专业领域问题进行推理。
对于药物毒性研究公司 Axiom Bio 而言,Carbon 目前已成为转化科学(translational science)领域性能最领先的模型,其帮助他们发现了此前未留意的全新毒性机制。
目前,Axiom 正将其生产环境下的科学分析与 AI Agent 全面迁移至 Carbon 和 Argon,以助力开发更安全的药物。
Google 各地的研究人员一直在 Google Antigravity 中使用 Carbon 来为他们的工作提速:
代码验证:研究人员构建了一个名为 AlphaProof Code 的全新智能体框架用于形式化验证,并将其投入到一项重大的安全挑战中:从数学上证明 Signal 加密协议底层代码的正确性。
研究人员将 Carbon 与其他模型结合,把安全目标转化为数学定理。随后,AlphaProof Code 智能体借助 Carbon 在 Lean(一种用于编写数学证明的计算机语言)中生成了数百万行代码,帮助他们在几周内证明了关键的安全属性。而这一任务在过去通常需要专家团队花费数年才能完成。
这一结果表明了 Carbon 在实现可扩展形式化验证的潜力,而形式化验证一直被视为构建安全软件的“黄金标准”。
酶测定法开发:Carbon 仅凭实验室记录本和原始数据,便超越了常规分析,成功识别出难以解读的数据异常,并通过这些异常诊断出湿实验中一些隐蔽的偏差(例如深孔板内自动化混匀不完全的问题),从而大幅提高了实验的可重复性。
此外,Carbon 还改进了色谱峰解卷积的方法,并发现了研究仪器中的微量样品残留,显著加速了新测定法的开发,并缩短了计算与实验之间的反馈闭环。
蛋白质结构预测:像 AlphaFold 3 这种结构预测模型,通常利用演化亲缘关系的蛋白质多序列比对(MSA)来推断氨基酸链的折叠方式。因此,对于那些在标准数据库中匹配项极少、研究较少的病毒、微生物和真核生物蛋白质上往往难以做出准确预测。我们的研究人员采用多智能体协作模式,利用 Gemini 4 Carbon 在拍字节级(PB)规模的未注释序列库、环境与病毒序列目录以及 3D 结构数据库中自主发现远缘同源序列。
例如,在 CASP17 盲测集的 7 个低同源性蛋白质家族中,Carbon 将检索到的同源物数量平均提高了 40 倍,在无需重新训练模型的情况下,为结构预测模型提供了更丰富的信息。
尽管更广泛的基准测试仍在进行,但通过解决这一上游搜索瓶颈,我们有望为构建蛋白质组中那些难以表征区域的结构模型,开辟一条切实可行的新途径。
四周前,Google 开放了申请通道,免费为 1,000 名科学家提供为期六个月的 Google Antigravity 中 Argon 的使用权限,以加快他们的研究步伐。目前,已有数千名科学家加入了该计划。
今天,Google 将开放范围进一步扩大,允许现有及未来的项目参与者使用 Carbon 模型。此后,随着我们最新的前沿模型陆续推出,该计划也将持续为他们提供使用权限。申请通道目前仍在开放,我们将根据资格审查、名额及筛选结果,每周滚动进行引入。
模型安全与保障方面的进展
随着新模型的发布,Google 持续深化安全保障措施、防范智能体滥用、强化模型对齐并减少潜在危害,确保这些保障力度与模型自身能力的提升保持同步。
由于 Gemini 4 Carbon 引入了更强大的网络安全能力,Google 在 Argon 坚实的安全保障体系基础上,进一步增强其抵御恶意滥用与提示词注入攻击的稳健性。
降低前沿模型被滥用的安全风险:Google 强化了针对滥用行为的安全保障机制,以确保更强的防御性推理能力不会转化为攻击性风险。在基于 ExploitBench 和 CyScenarioBench 构建的模拟网络攻击测试环境中,针对能够在每次被拦截后迭代优化攻击计划的“自适应红队智能体”,Carbon 成功拦截了 99% 的攻击路径。
Carbon 的安全保障机制将单次尝试的突破率降低至仅 0.8%(低于Argon 的 3.1%)。同时在 Gray Swan 的测试中,我们的安全保障机制将自动化网络攻击查询的成功率降至 2.17%(Argon 为 9.86%)。
此外,Trajectory Labs 的外部测试显示,在长达 132 小时、超过 13,000 次请求的测试中,未发现任何新的通用“越狱”(jailbreak)手段。
促进安全且符合对齐的模型交互:发布 Carbon 时,我们展示了其在模型全生命周期monitor flag rates所衡量的对齐能力方面的显著提升,以及数据捏造现象的减少。
最新结果显示,在包含 375 项任务的“智能体诚实度基准测试”(agentic honesty benchmark)中,Carbon 成功通过了 92% 的任务(相比之下 Argon 为 70%)——在 98% 的情况下拒绝填补缺失的实验数据,并在 68% 的情况下主动指出方法论上的缺陷。
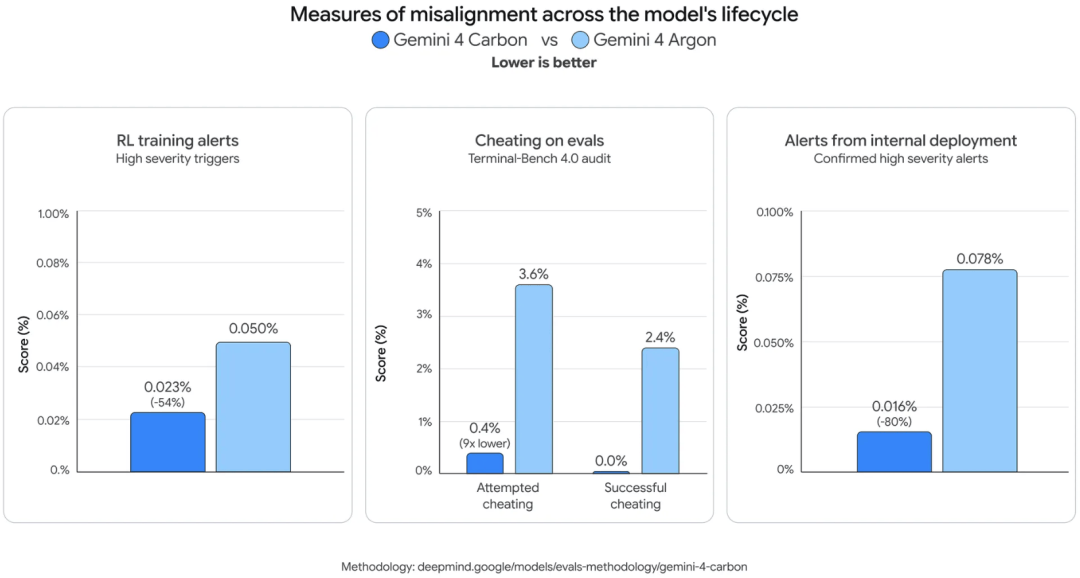
保护用户免受间接提示词注入(Indirect Prompt Injection)攻击:两周前,我们分享了 Carbon 在 Gray Swan IPI 基准测试中实现了 0% 的提示词注入攻击成功率,这是首次达成该里程碑。
与此同时,Google 也意识到,抵御提示词注入的稳健性依然是一个需要持续改进的领域。我们先进的“自动化红队测试”(automated red teaming)正在不断突破现有极限,并且在某些特定场景分布下,模型面对复杂精密的攻击仍有进一步提升的空间。这为Google 持续推动提供了宝贵的数据,以推动模型安全迈向更高水平提供了关键数据支持。