11月12日,百度世界2026主论坛上,百度应用模型研发部负责人贾磊正式发布两款文心应用模型——文心闪电深度思考模型与文心一镜微表情大模型,同步上线百度智能云千帆平台,面向企业客户及合作伙伴开放 API 服务。
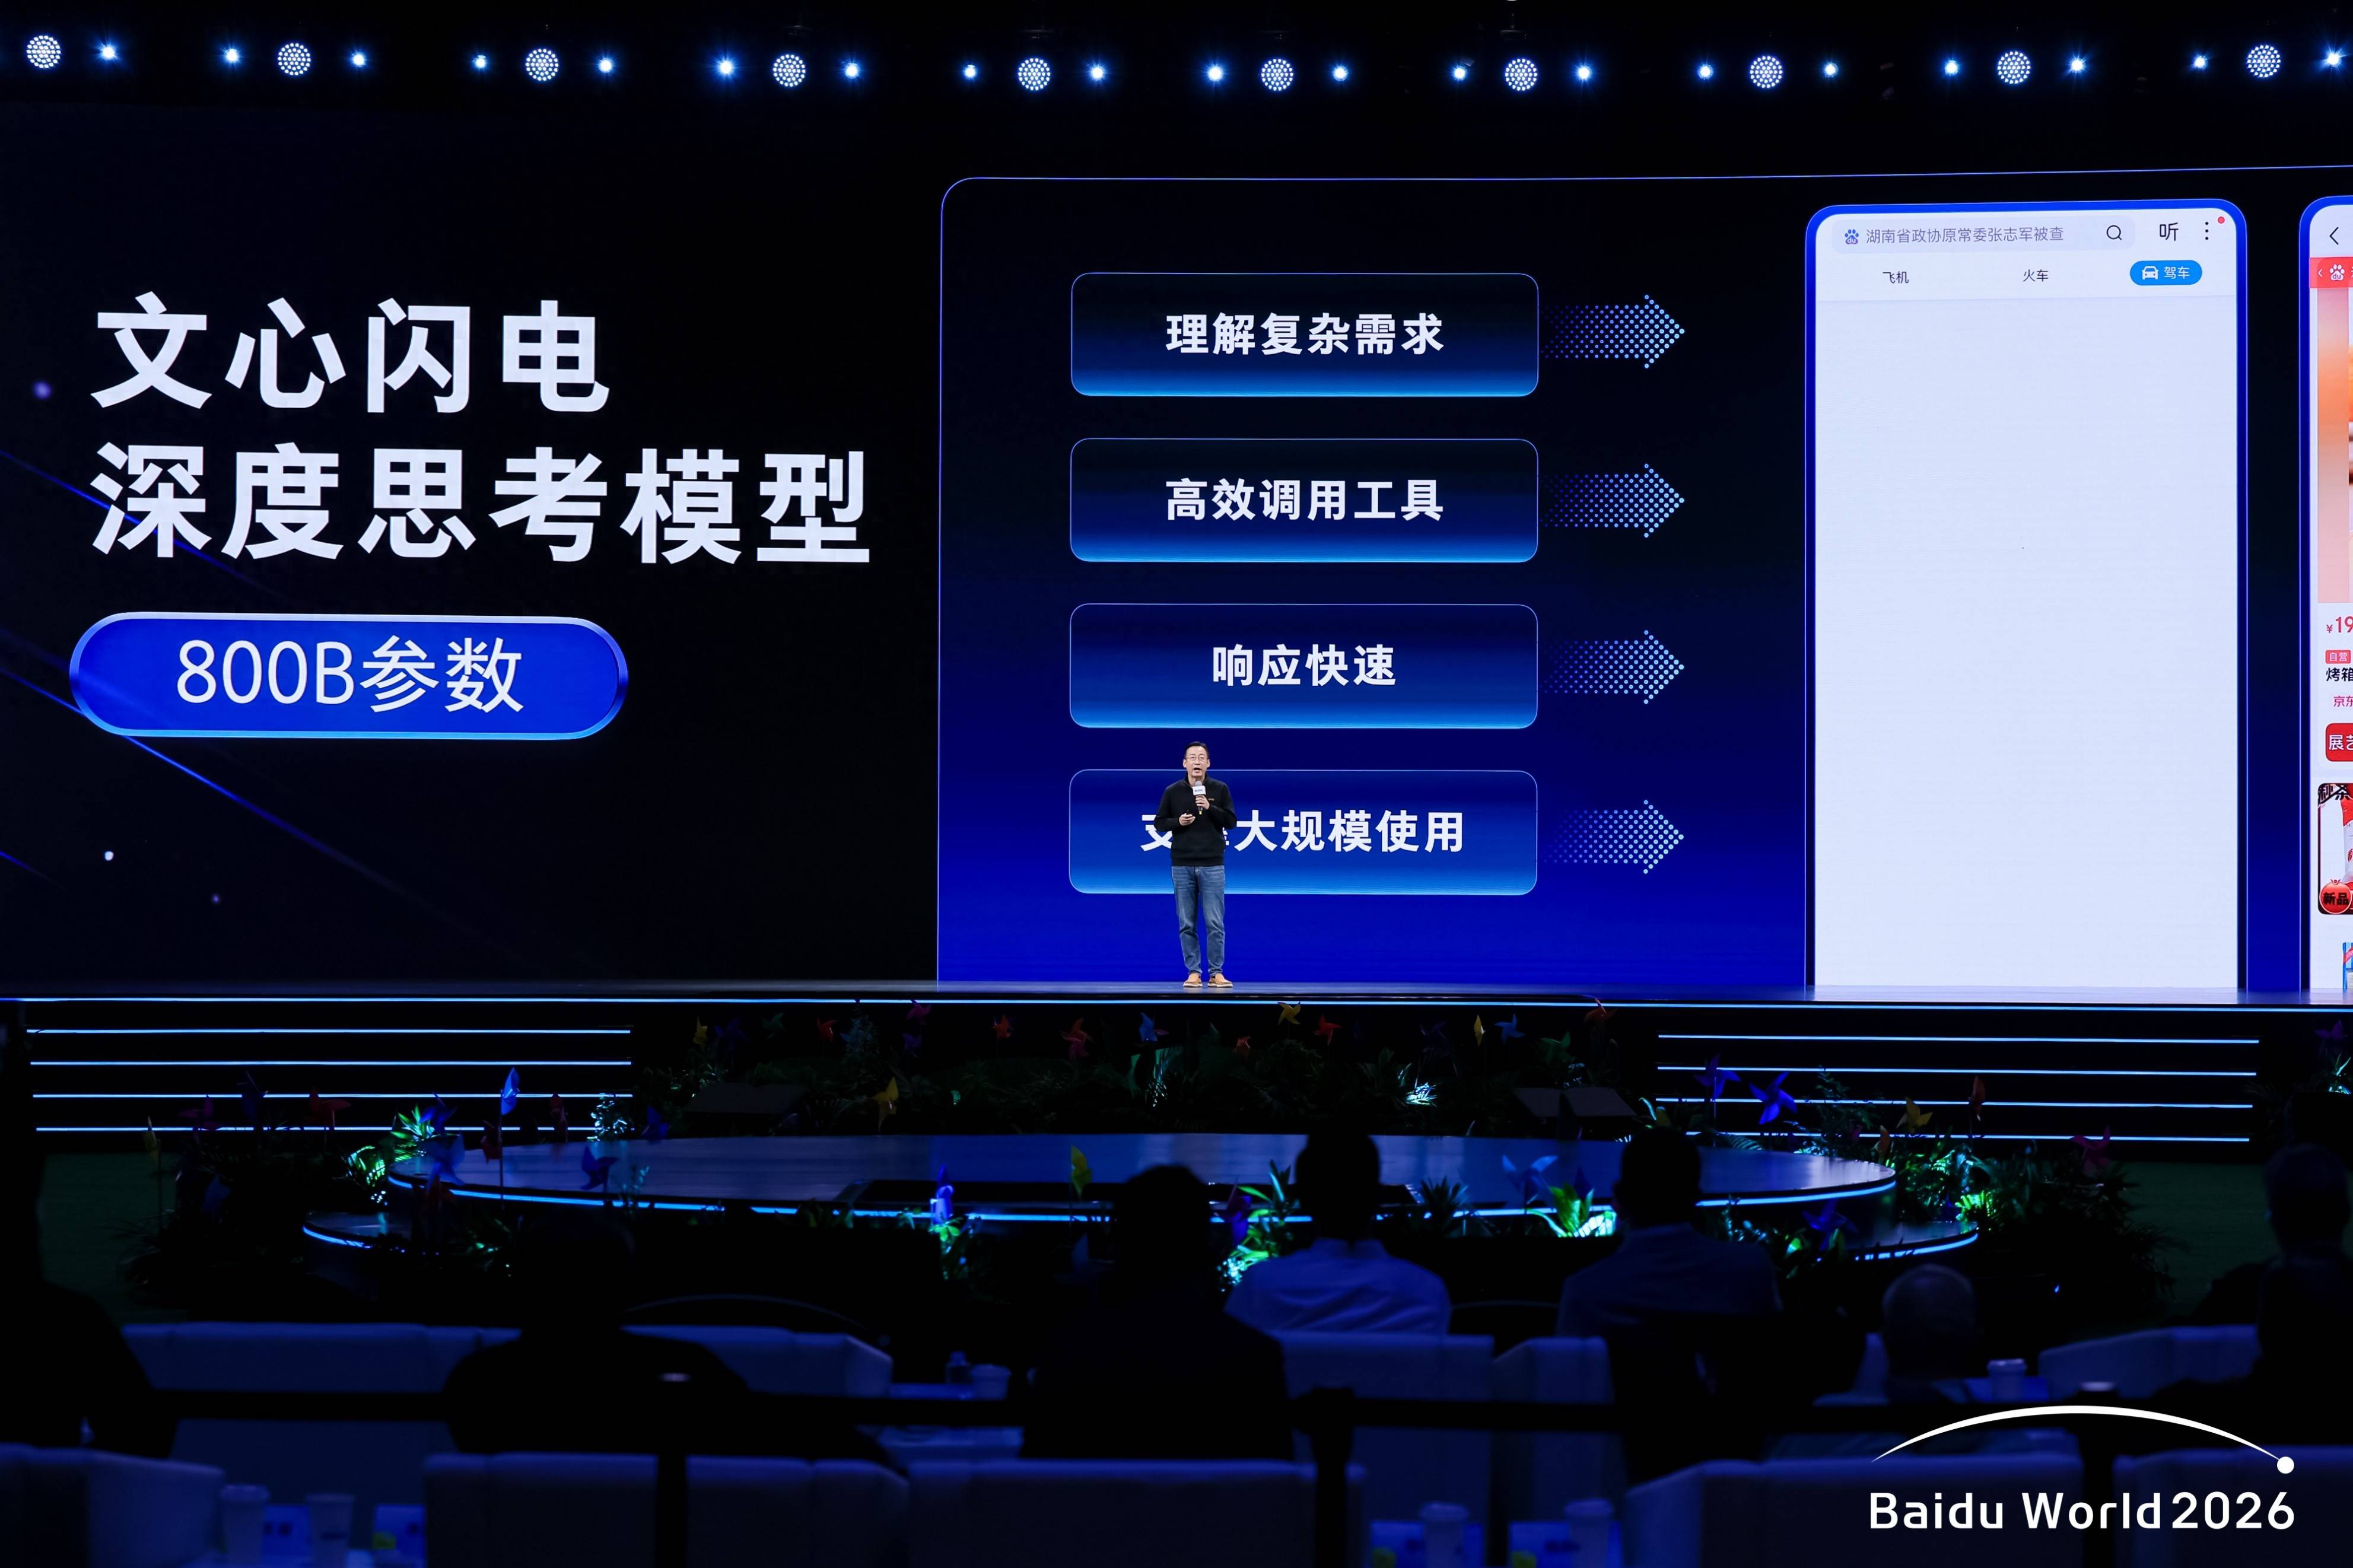
文心闪电深度思考模型在研发之初是为百度搜索使用的。百度搜索支持语音、图像、文字等多种输入,不仅提供信息答案,还能连接智能体、调用工具完成复杂任务。这要求模型既具备复杂需求理解、推理和工具调用能力,又能快速响应、支撑海量用户请求。
为此,百度对传统的Transformer 架构进行大胆创新,独创了基于反馈式 KV 压缩的稀疏注意力技术——百度稀疏注意力注意力技术(Baidu Sparse Attention,BSA)。该技术能够在解码过程中,根据历史输出和状态,进行反馈式历史记忆信息(KV)压缩,能够在模型效果和历史记忆存储耗费之间做最佳折中。在保证模型效果的同时,大幅度降低推理成本。BSA具有广谱的适配性,与DSA、HCA等高压缩自注意力机制都能够兼容,广泛适用于各种结构的大模型。
与此同时,百度提出快慢思考协同的 Looping 方案:由快思考模型服务业务,慢思考模型作为判定模型持续提供反馈,优化快思考模型。文心闪电深度思考模型支持思考与非思考两种模式,除了支持搜索产品,这款模型在编程、推理、智能体和文本能力等多项公开测试中达到领先水平。
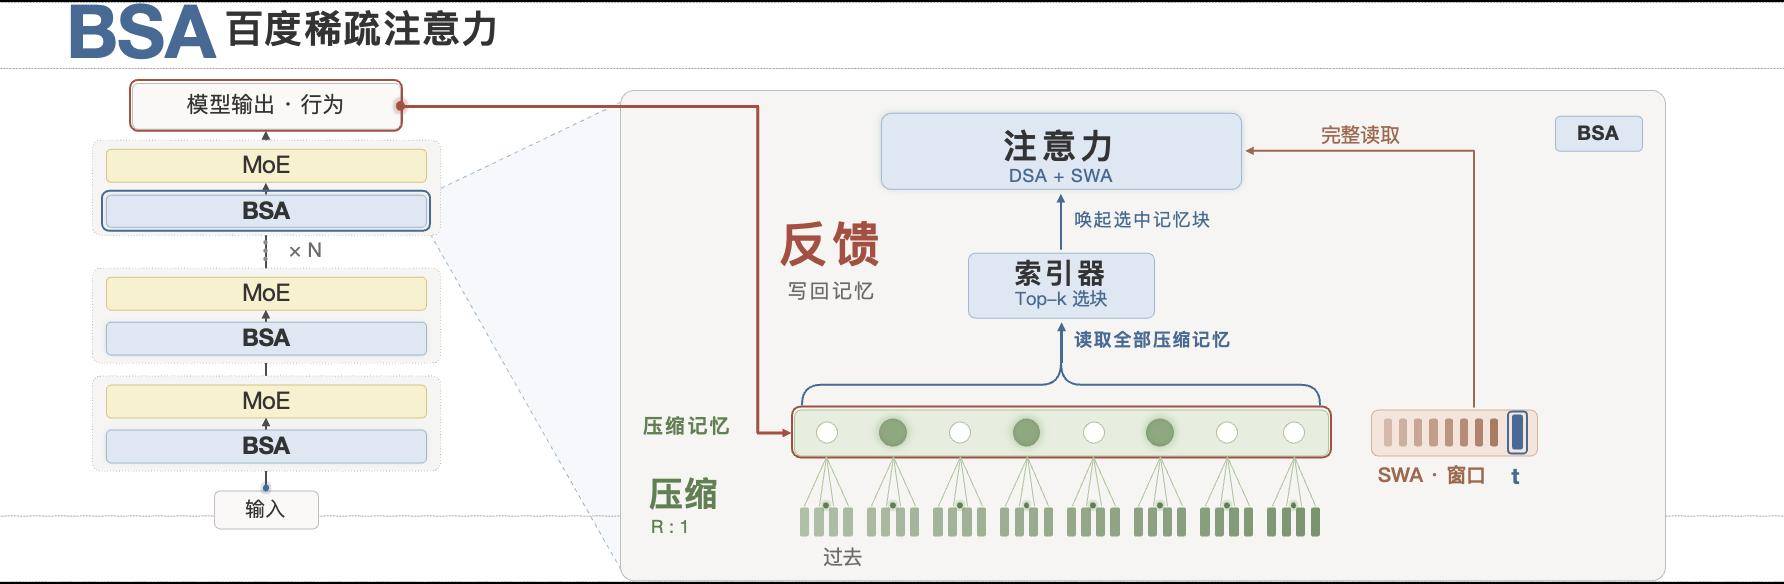
在推理效率方面,模型凭借 BSA 注意力机制,可在昆仑芯上实现单机八卡高速推理。通过与昆仑芯协同优化,模型 ROI 较同类芯片提升 50%,模型推理引擎成本降低 30% 以上。
文心一镜微表情大模型则专为高情感表现力的视频创作场景研发,采用文本、视觉、语音三态一体建模,支持长达 4000 字的文本驱动。通过覆盖 6 大维度、200 个子维度的细粒度描述体系,模型能够深入理解文本内容,精准刻画人物的面部表情、肢体动作与情绪变化,实现从复杂情感描述到人物表演的自然转化。
同时,文心一镜微表情大模型支持高表现力的长语音驱动,并创新研发篇章级配音技术。区别于传统以约 30 秒片段为单位独立生成音频、再拼接完成的方式,该技术能够基于完整剧本进行整体配音生成,深入理解语言情感与篇章节奏,实现声音一次生成、节奏连贯、音色统一,有效提升长视频的声音表现力与整体连贯性。
基于这些技术创新,文心一镜微表情大模型具备业界顶尖的情感表现力,在播客、短漫剧等场景达到行业领先水平。同时,模型兼具低成本与出片快的优势:视频生成成本较业界降低 50%,支持分钟级视频生产;极速版本可实现 1:1 实时生成,即 1 分钟的视频内容可在 1 分钟内完成生成,进一步降低创作门槛。