用人话讲明白线性回归
奶茶店广告费与营业额案例
目录
1前言与算法简述
2线性回归计算过程
3案例以及工具实现
1 前言与算法简述 奶茶店老板最近有点纠结。广告费花得多的日子,营业额好像也高一些,可周末本来就顾客多。多卖的钱,到底是广告的关系,还是周末带来的?
这就是线性回归能帮我们整理的问题。它根据一组观测数据,估计变量之间的线性关系。比如广告费每增加一些,营业额平均会相差多少。
这次用24天的模拟营业数据,先只看广告费,再把“是不是周末”也放进模型。两种结果放在一起,就能看出控制周末后,广告费的统计关联有没有变化。
第一个作用,估计变量之间的关系。回归系数告诉我们,在模型其他条件相同的情况下,解释变量每增加一个单位,因变量平均相差多少。
第二个作用,比较变量组合对结果的解释程度。模型可以加入合理的控制变量,再看看拟合效果和系数精度如何变化。要注意,回归发现统计关联,本身不能证明因果关系。
2 线性回归计算过程从数据到结论,可以顺着这条线走。
确定因变量和解释变量→ 拟合回归线 → 计算系数→ 检查不确定性 →比较模型与诊断残差
2.1 先看散点大致往哪边走
把每天广告费放在横轴,把营业额放在纵轴。每一天就是图上的一个点。
如果广告费较高的日子,营业额通常也较高,点云整体从左下往右上,说明可能存在正向线性关系。回归线就是用一条直线概括点云的平均趋势。
这里是“整体趋势”,不是说广告费高的每一天都必然卖得更多。天气、客流、促销、节假日等都可能让单日表现上下波动。
2.2 最小二乘法怎样画出回归线
简单线性回归可以写成:
yᵢ= β₀ + β₁xᵢ + εᵢ
yᵢ是第i天营业额,xᵢ是广告费,β₀是截距,β₁是广告费系数,εᵢ代表模型没有解释的部分。
回归线给每一天一个预测营业额。预测值和实际营业额之间的距离叫残差。
最小二乘法会选择一条直线,让所有残差的平方加起来尽可能小。
SSE= Σ(yᵢ − ŷᵢ)²
为什么要平方?正负残差相加会相互抵消,平方后都变成非负数,而且偏差大的点会受到更大惩罚。
多元回归也是同一个想法,只是再加入其他解释变量。模型会一起估计各变量系数,使残差平方和尽可能小。
2.3 系数该怎么读
在本例中,广告费单位是元。若模型估计广告费系数为3.4587,就可以说,在模型条件相同的情况下,广告费每增加1元,营业额平均高约3.46元。
“每1元”不够直观,可以换成100元。乘以100后,广告费每增加100元,对应营业额平均高约346元。
这是平均关联的表达,不能直接说多投100元广告就一定多赚346元。要判断广告效果,最好通过随机实验或其他更严格的因果识别设计。
2.4 标准误和置信区间说明什么
系数是根据样本估计出来的,换一批日子,结果会有变化。标准误描述这个估计值的不确定程度。通常标准误越小,系数估计越精确。
95%置信区间给出系数可能范围的估计。本例模型2广告费系数为3.4587,95%置信区间为[2.8037,4.1138]。换算成每100元,就是营业额平均高约280~411元。
p值用来衡量数据与“系数为0”这一假设是否相容。p值较小时,样本提供了反对系数为0的证据。它不表示结果为真的概率,也不说明实际效果有多重要。
本次采用HC3稳健标准误。它调整了标准误、t值、p值和置信区间的计算,对误差方差不齐的情况更稳健。但HC3不会自动解决时间序列相关问题。
2.5 加入控制变量,比较两个模型
模型1只放广告费。模型2再加入是否周末,0表示工作日,1表示周末。
模型1:营业额= 截距+ 广告费系数× 广告费+ 误差
模型2:营业额= 截距+ 广告费系数× 广告费+ 周末系数× 是否周末+ 误差
模型2的周末系数表示,在广告费相同的情况下,周末营业额平均比工作日相差多少。
R²表示模型解释了样本营业额波动的比例。调整R²会考虑解释变量数量。比较模型时,还可以看RMSE、AIC、BIC以及加入变量后的整体检验。
如果R²提高,不等于模型就一定适合,也不能证明解释变量造成了结果变化。还要看变量设定、残差和数据收集方式。
2.6 看看模型剩下的误差
模型用残差代表没解释的那部分。把残差对拟合值画出来,如果点大致围绕零线随机散布,通常是较好的信号。如果出现弧线,关系可能不是直线;如果呈喇叭口,误差波动可能随预测值改变。
日度数据还要留意时间顺序。相邻几天的营业额可能彼此相关。Durbin-Watson统计量明显偏离2时,应进一步检查序列相关。普通HC3标准误并不专门处理这种相关性。
3 案例以及工具实现3.1 案例介绍奶茶店广告费与营业额
店长记录了24天的数据。广告费每天50至325元,周末和工作日各12天。我们想了解广告费与营业额的统计关联,并观察控制周末后模型有什么变化。
这些都是教程模拟数据。日期编号只用于标记观测,不进入回归。营业额是因变量,广告费是核心解释变量,是否周末是控制变量。
3.2 使用工具与案例操作
第一步,在DabbitAI的SPSS工具箱选择“线性回归(最小二乘法)”,上传数据。
第二步,指定营业额为因变量、广告费为核心解释变量、是否周末为控制变量,保留截距。
第三步,分别估计两个模型,并使用HC3稳健标准误。模型1只包含广告费,模型2加入是否周末。
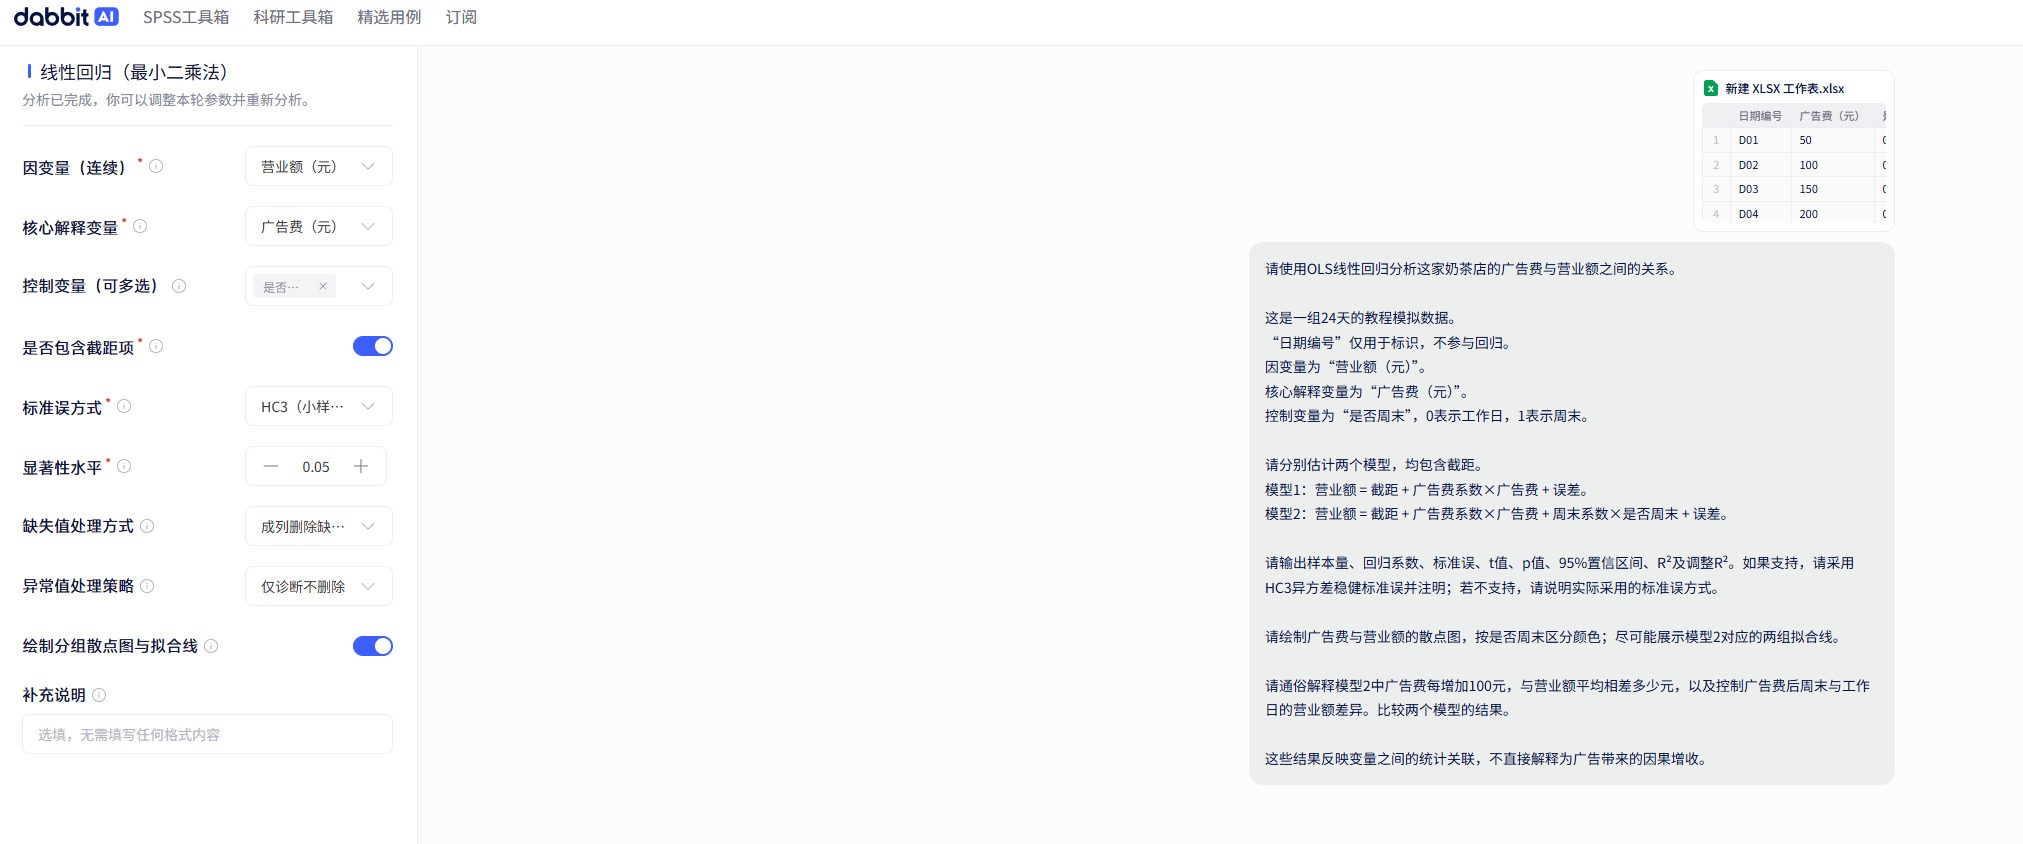
图1线性回归参数配置
配置页中已选择营业额、广告费和是否周末,截距开启,显著性水平0.05,标准误方式为HC3,并要求输出分组散点图与拟合线。
3.3 分析结果解读
输出结果1回归系数与模型对比
模型1没有控制周末,广告费系数为3.4587。模型2加入周末后,广告费系数仍是3.4587。换句话说,在这组模拟数据里,广告费每增加100元,对应营业额平均高约346元。
模型2的95%置信区间换算后约为280~411元。周末系数为540,表示广告费相同的情况下,周末营业额平均比工作日高约540元。
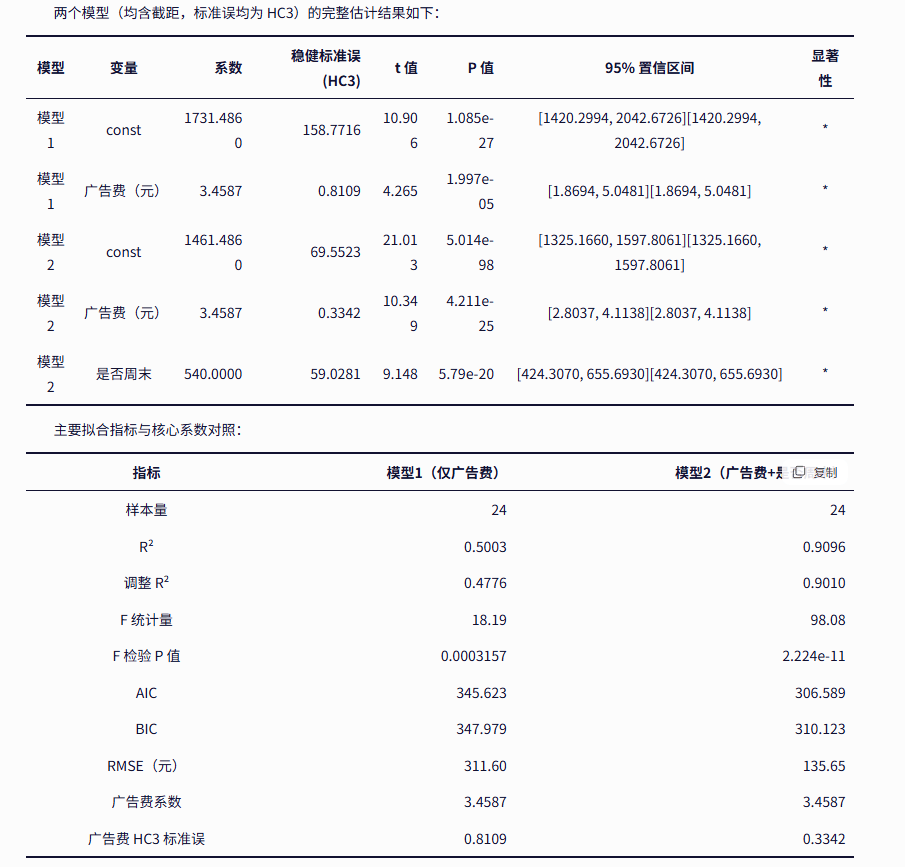
图2回归系数与模型拟合指标
模型1的R²为0.5003,模型2提高到0.9096。调整R²从0.4776提高到0.9010,RMSE从311.60元降至135.65元。嵌套F检验也显示加入周末变量显著改善拟合,F(1,21)=95.08,p=3.008×10⁻⁹。
输出结果2分组散点图与拟合线
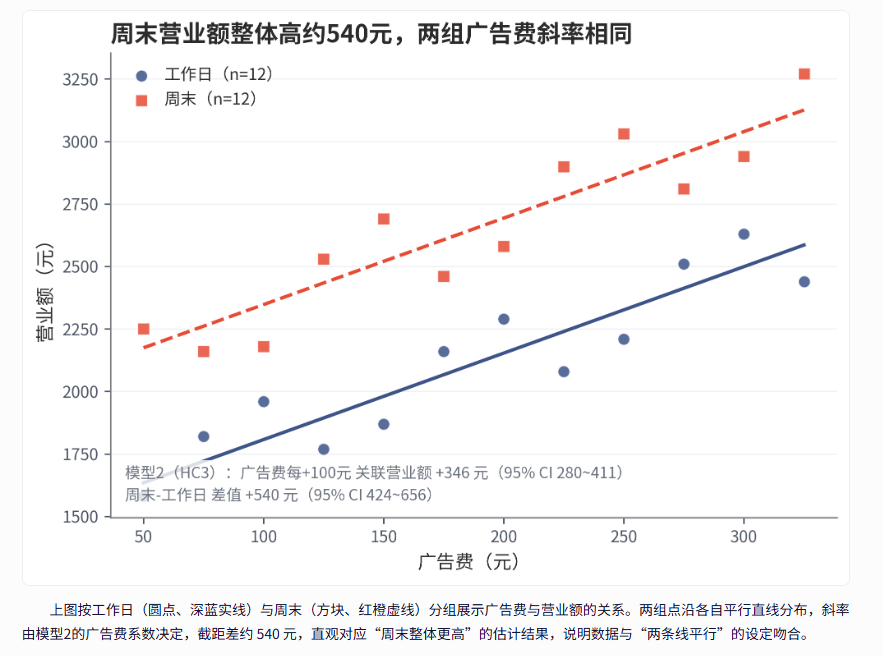
图3工作日与周末分组散点及拟合线
工作日和周末的点大致沿着两条平行线分布。模型2给出的广告费斜率相同,周末线整体高出约540元。这张图帮助看出,周末与营业额之间的差异不能忽略。
输出结果3广告费系数对照图
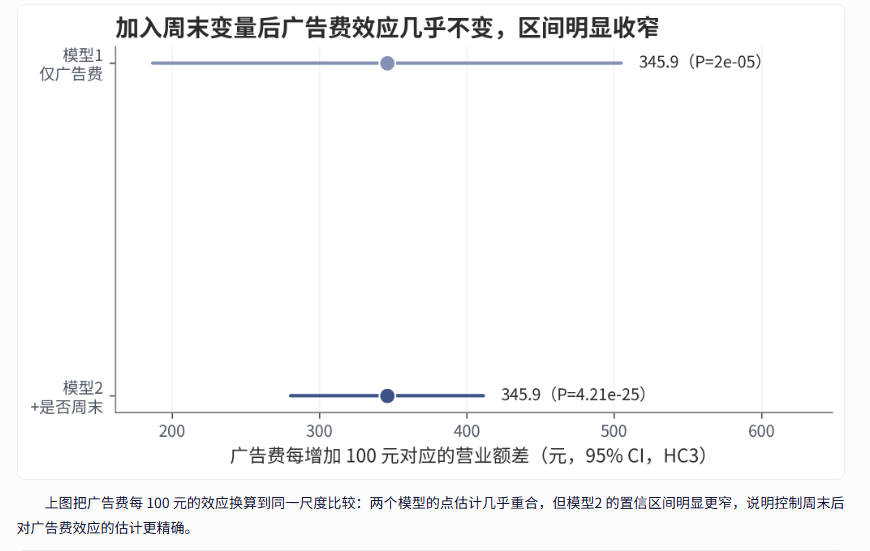
图4广告费系数对照图
两个模型中广告费系数点估计重合,但模型2的置信区间更窄。控制周末后,广告费关联的估计精度提高了。
输出结果4模型2残差图
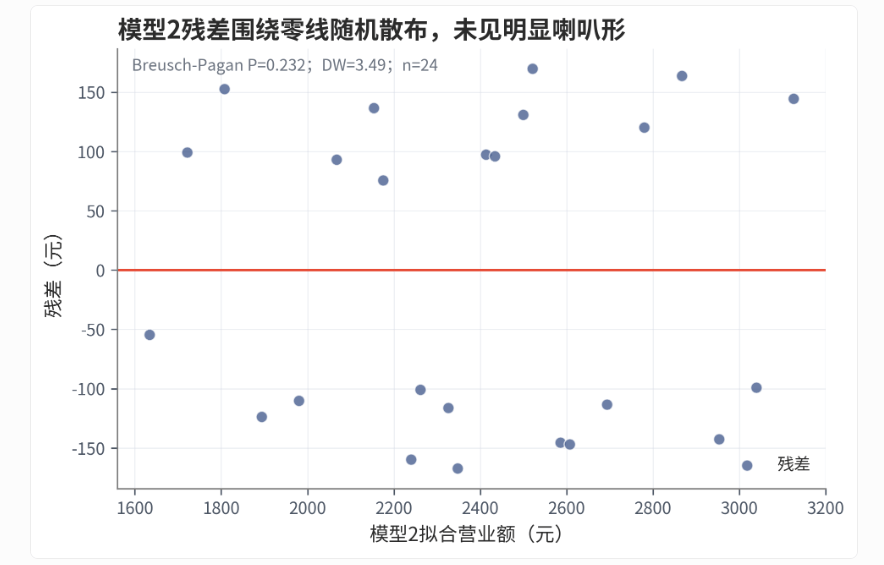
图5模型2残差诊断图
残差围绕零线分布,没有特别明显的喇叭形或弯曲形态。诊断中Breusch-Pagan检验p=0.232,没有发现明显异方差。不过Durbin-Watson统计量为3.49,明显偏离2,提示日度观测可能存在序列相关。HC3标准误处理异方差的稳健性,不等于处理序列相关,因此显著性推断需谨慎。
3.4 小结
可以把这次结果写成下面这样。
“基于24天教程模拟数据进行OLS回归,广告费系数在仅含广告费的模型和控制周末的模型中均为3.4587。模型2中,广告费每增加100元,对应营业额平均高约346元(95%置信区间约280~411元);在广告费相同条件下,周末营业额平均高约540元。加入周末变量后,模型拟合有所改善。上述结果反映统计关联,不能直接解释为广告投入带来的因果增收。Durbin-Watson统计量提示可能存在序列相关,显著性结果应谨慎解读。”
店长可以把它理解成:这批记录里,广告费高的日子营业额也倾向更高;周末本身还有一截营业额差异。要知道广告到底带来多少增收,还需进一步设计能排除其他因素影响的研究。
3.5 常见问题
广告费系数3.4587,是不是每花1元就赚3.46元?
不是。它描述样本中的统计关联,不是广告的因果回报,也没有扣除广告成本和原料成本。
为什么模型1和模型2广告费系数一样?
在这组模拟数据的构造中,周末与广告费基本独立,加入周末没有改变广告费系数。真实数据里系数可能改变。
R²越高,模型就越可靠吗?
R²只是拟合指标之一。还要考虑样本量、变量遗漏、残差诊断和数据的时间结构。
HC3稳健标准误能解决所有问题吗?
不能。它针对异方差稳健调整,不自动解决序列相关、遗漏变量或因果识别问题。
方法参考本案例的系数、诊断与图表来自本次DabbitAI线性回归输出。全部数据为教程模拟数据,结果按统计关联口径解读。