用人话讲明白SBM模型(详细原理+工具实现)
1、前言与算法简述
评价一个单位"效率高不高",最容易想到的是投入产出的比值:花多少钱、办多少事。可现实里的单位往往同时消耗好几种投入、产出好几种成果,分子分母都拉成一串,比值就没法比了。
数据包络分析(dataenvelopment analysis,简称DEA)换了个思路:把所有被评价单位放进同一张投入-产出图,找出表现最好的那几个,连成一条前沿面,其余单位离前沿有多远,就是它离有效有多远。最经典的CCR模型按比例把投入整体压缩,压缩到极致仍贴在可行域里为止,这个压缩比例就是效率值。
问题在于,"按比例压缩"有个盲点。有些投入已经压到底了,另一些还富余很多,CCR对此视而不见。SBM模型(slack-basedmeasure,基于松弛的测度)把每一份压不动的余量单独记账,再一起扣进效率值,不足的地方也不会被漏掉。
来看校园里的三个快递代收点。
 学校把快递代收外包给四个点,后勤处想看看哪个点用得最省。每个点每天消耗两样东西:值守的人工工时,和占用的货架位。产出只有一个,就是当天处理的件数。
数据取自后勤处一个工作日的值班记录,为教学示例。
四个点的规模差得不小:A只处理1百件,B、C、D都是2百件。同样是2百件,C只用了6小时和2个货架位,D却用了10小时和5个货架位。直觉上C最划算,但"划算多少"要算出来。
2、SBM模型的计算过程
(1)先把点摆到图上,认清前沿
产出只有一种,比较就容易了:盯着同样处理2百件的B、C、D三个点,看谁用的资源少。
C用6小时工时、2个货架位;B用8小时、4个货架位;D用10小时、5个货架位。C在两项投入上都小于B和D,用DEA的话说,C支配了B和D。被支配的点不可能有效,效率值必然小于1。
A单独处在1百件那一档。同产出档里没有别的点,A自己就是这一档的标准,技术效率记为1。它的规模偏小是另一回事,SBM只判技术效率,不替后勤处决定该不该合并。
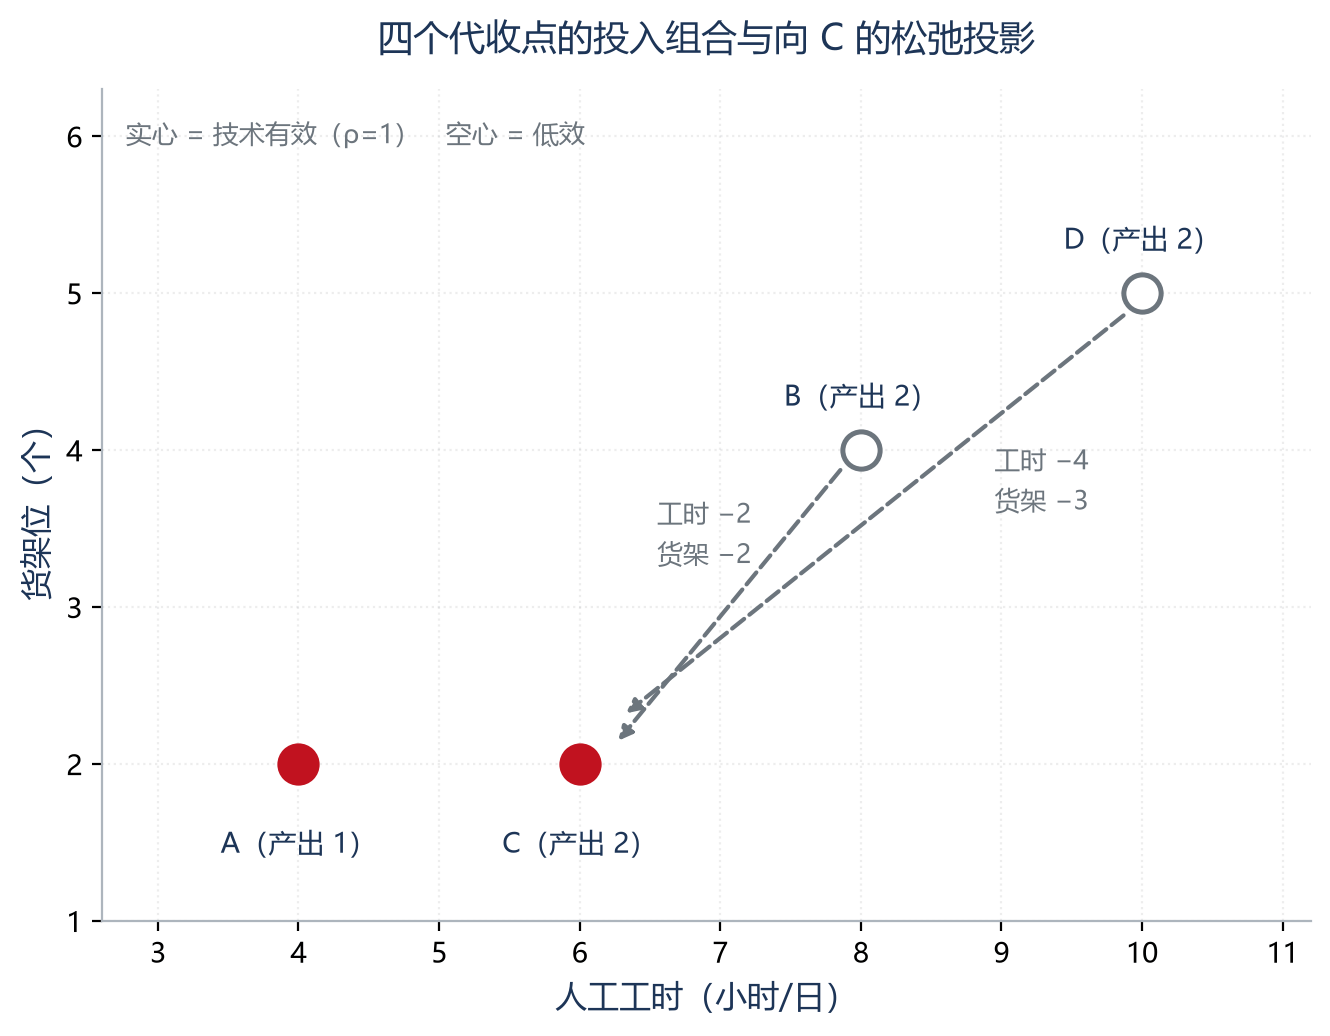
横轴是人工工时,纵轴是货架位,数字为日处理百件数。C在两项投入上都更省。
(2)径向压缩:CCR能压到几成
先看经典做法。CCR给每个点找一个压缩系数 ,把全部投入按同一比例缩小,缩到刚好还能产出原来那么多件为止。
对B来说,要产出2百件,前沿上的参照点是C。两项投入各自给出一个下限:

两个条件要同时满足,取更严的那个, 。B的效率值就是0.75,投影点落在
 。
注意投影点的第二个坐标是3。前沿上真正最优的C只占2个货架位,而B按比例压到3个就够了,多出来的1个货架位CCR不会追问。这就是径向模型的盲点:它只管按比例缩,缩完还剩的余量不算进效率。
(3)把松弛一起扣进去:SBM的算法
SBM把这类余量叫松弛(slack)。对第 个被评价单位,记它有
 项投入、
 项产出,投入
 的松弛为
 ,产出
 的松弛为
 ,则效率值定义为
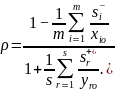
分子是投入端剩余的比例,分母是产出端不足的比例。 落在 0到1之间,只有
 才算有效,也就是所有松弛全为零。
松弛不是随便取的,它来自一组约束。记 为各参照点的权重,则

第一条说的是:被评价单位的投入,等于参照组合的投入加上没用上的部分。第二条说的是:它的产出,等于参照组合的产出减去没达到的部分。第三条限定参照组合是各点按权重混合而成,这一条对应可变规模报酬,取消了CCR的规模不变假设,正是它能公平对待A这种小规模点的原因。
对B代入。参照点取C,权重 ,其余为零。工时这一项,B用8小时,C只用6小时:
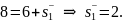
货架位这一项:
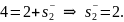
产出正好相等, 。代入效率公式,
 、
 :
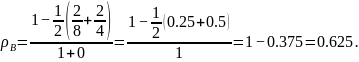
同样算D。D用10小时、5个货架位,参照点仍是C:

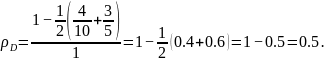
把四个结果放在一起,问题就很清楚了。
(4)为什么两个效率值不一样
B的CCR效率0.75,SBM效率0.625,差距来自那1个多出来的货架位。CCR只看到"按比例能压掉25%",SBM还把"货架位其实还能再省1个"算进去了。D的差距更大,0.600对0.500,因为它两项投入都富余得厉害。
差距本身也有信息量。CCR与SBM差得越多,说明这个点的浪费越不均衡,不是整体臃肿,而是某一两项特别费。B和D的差距都在0.1以上,后勤处该做的不是让所有投入都按比例砍一刀,而是先动最肥的那一项。
按SBM给出的方向,D要追平C,工时得从10小时降到6小时,货架位从5个降到2个。对应到管理动作:把两个相邻的代收点合并排班,或者把货架位让给取件量更大的点。
3、案例以及工具实现
3.1十二所高校图书馆的三项投入与两项产出
换一个多投入多产出的场景。某省高校图工委汇总了12所本科院校图书馆的年度运行数据。投入有三项:正式馆员人数、纸质藏书量、馆舍面积。产出有两项:年到馆人次、年借阅册数。图工委想知道,哪些馆在现有资源下产出偏少,差在哪个环节。
多产出的情况下,效率定义要把各项产出按权重合并。SBM的做法是在分母里对每一项产出的不足比例取平均,权重由线性规划自己找,不预先指定。
3.2用dabbitAI跑一次SBM
在dabbitAI的「SPSS工具箱」中搜索"数据包络",打开效率评价模块。把12所图书馆的五个字段整理成一张表,每行一个馆,列名标明单位。
设置环节有三个关键选择。模型类型选「SBM」,不要停在默认的CCR,否则松弛不会被计入。规模报酬选「可变」,馆舍面积和馆员数短期内调不动,规模不变的假设在这里不成立。投入产出方向按字段逐一标注,馆员数、藏书量、面积设为投入,到馆人次、借阅册数设为产出。
也可以直接向dabbitAI提问,让它按同一口径给出结果:
我有一张12所高校图书馆的表,字段为馆名、馆员人数、纸质藏书量(万册)、馆舍面积(平方米)、年到馆人次(万)、年借阅册数(万)。请用SBM模型评价各馆技术效率,规模报酬设为可变,给出每所馆的效率值、各项投入的松弛量和产出不足量,并列出每个低效馆的参照标杆馆。
3.3怎么读效率值、松弛表和投影
先看效率值排序。报告会把的馆单独列出,这些是标杆,其余按效率从低到高排。若12所里有4所达到1,说明前沿由这4所构成,另外8所都在前沿内侧。
接着看松弛表,这是SBM比CCR多出来的部分,也是最有管理价值的一栏。
先认效率值那一列,再看同一个馆哪几项松弛不为零。
读法要连着看哪一列不为零。馆3的馆员和藏书都有富余,面积却刚好用满,说明它的问题是人多书多但没转化成借阅,重点该放在推广和开放时长上。馆8反过来,面积空着2380平方米,人与书都不缺,那是馆舍利用率的问题,可能要调整自习区与书库的比例。
馆11只有6人的馆员松弛,借阅没有不足,效率0.79主要由投入端的冗余拉低。这类馆不必大动,把借阅台的人手调去做阅读推广即可。
最后一栏是投影值,也就是把松弛全部消除后该馆应有的投入产出组合。它回答的是"如果做到最好,这张表应该长什么样"。馆3的投影是馆员减少21人、藏书减少4.6万册、借阅增加18.2万册,三个数一起看,才是它完整的目标。
需要提醒的是,效率值只描述样本内的相对位置。12所馆里效率为1的那4所,放进全国范围未必还是标杆。分批扩样本重跑,结论才站得住。