一份三百页的投标文件,过去要拆成十几段,分批喂给 AI,还得担心它读到后面忘了前面。现在这件事有了新变化。
11 月 13 日,DeepSeek 的 V4-Pro、V4-Flash 与 V4.1-Flash 三款开放权重模型上架 AWS SageMaker JumpStart,三者都支持 100 万 token 的上下文。在此之前,V4.1 Flash 已于 9 月 10 日以 MIT 许可开源,10 月 17 日更新到 1017 版本。100 万 token 是什么概念?大致相当于一次性读完数十万汉字,一整本中等篇幅的书,或者一个中型代码仓库的全部文件。
对企业内容工作来说,这个数字的意义不在于炫技,而在于它改变了"文档被怎么用"这件事。
 图:上下文扩到一百万,长文档终于有人一次读完了
从"分段读"到"整篇读"
上下文窗口,指的是模型一次能处理的文本长度上限。窗口太小,长文档只能被切成碎片,分段处理。
这种切法有两个老问题。
一是丢失跨段信息。一份合同里,第五条的责任认定和附件的补充条款可能相互印证,一旦拆开,模型看不到这种呼应,容易给出割裂的判断。
二是前后不一致。分段问答时,模型对同一份文档前后两次的解读可能互相矛盾,因为每次它看到的都只是局部。
100 万窗口想解决的,正是这两点。把整份材料一次性放进去,让模型在完整语境里理解,理论上能减少这类割裂。
在 11 月 3 日驱动中国 AI 文本模型排行榜的更新里,V4.1 Flash 以 1612 分登顶,超过自家的 V4 Pro(1590 分)和 GPT-6 Astra。它本身是 V4 系列里尺寸最小的成员,能在综合文本能力上越过上一代旗舰,靠的是架构重做而非单纯堆规模。
长上下文不等于长记性
不过,把"窗口大"直接等同于"记得牢",是一个常见误解。
公开技术资料里,V4.1 Flash 采用因果编码器—解码器结构,总参数 552B,输入只激活约 8B、输出激活约 16B。真正被反复提及的,是它的 KV 缓存优化:全局 KV 缓存每 token 约 890 字节,是上一代 V4 Flash 的四分之一左右。
KV 缓存是模型处理长文本时暂存中间状态的地方。缓存越大,同样显存能同时服务的会话越少,长上下文的成本就越高。把缓存压下来,本质是在降低长文本的托管成本,让"整篇读"在经济上更可行。
技术上更低的成本,和"读得更准"是两件事。窗口变大解决的是"能不能放进去",不是"能不能理解对"。一份结构混乱、口径不一的文档,即使全文塞进去,模型依然难以给出稳定答案。
这意味着,长上下文放大了内容质量的作用。写得清楚、结构规整的文档,获益最大;原本就含混的材料,只是把含混原样放大。
三个公开数字的背景
围绕这批模型,还有几组数字值得放在一起看。
其一,并发上限。V4.1 Flash 的并发上限为 2500,同代 V4-Pro 为 500,高出一个量级。其二,最大输出 384K token,意味着它不仅能读长文,也能写长文。其三,价格。有资料显示,V4.1 Flash 高峰时段缓存未命中的输入约 2 元每百万 token、输出约 8 元,空闲时段再打折;对照上一代 V4-Pro 的 9 元与 27 元,成本明显下移。
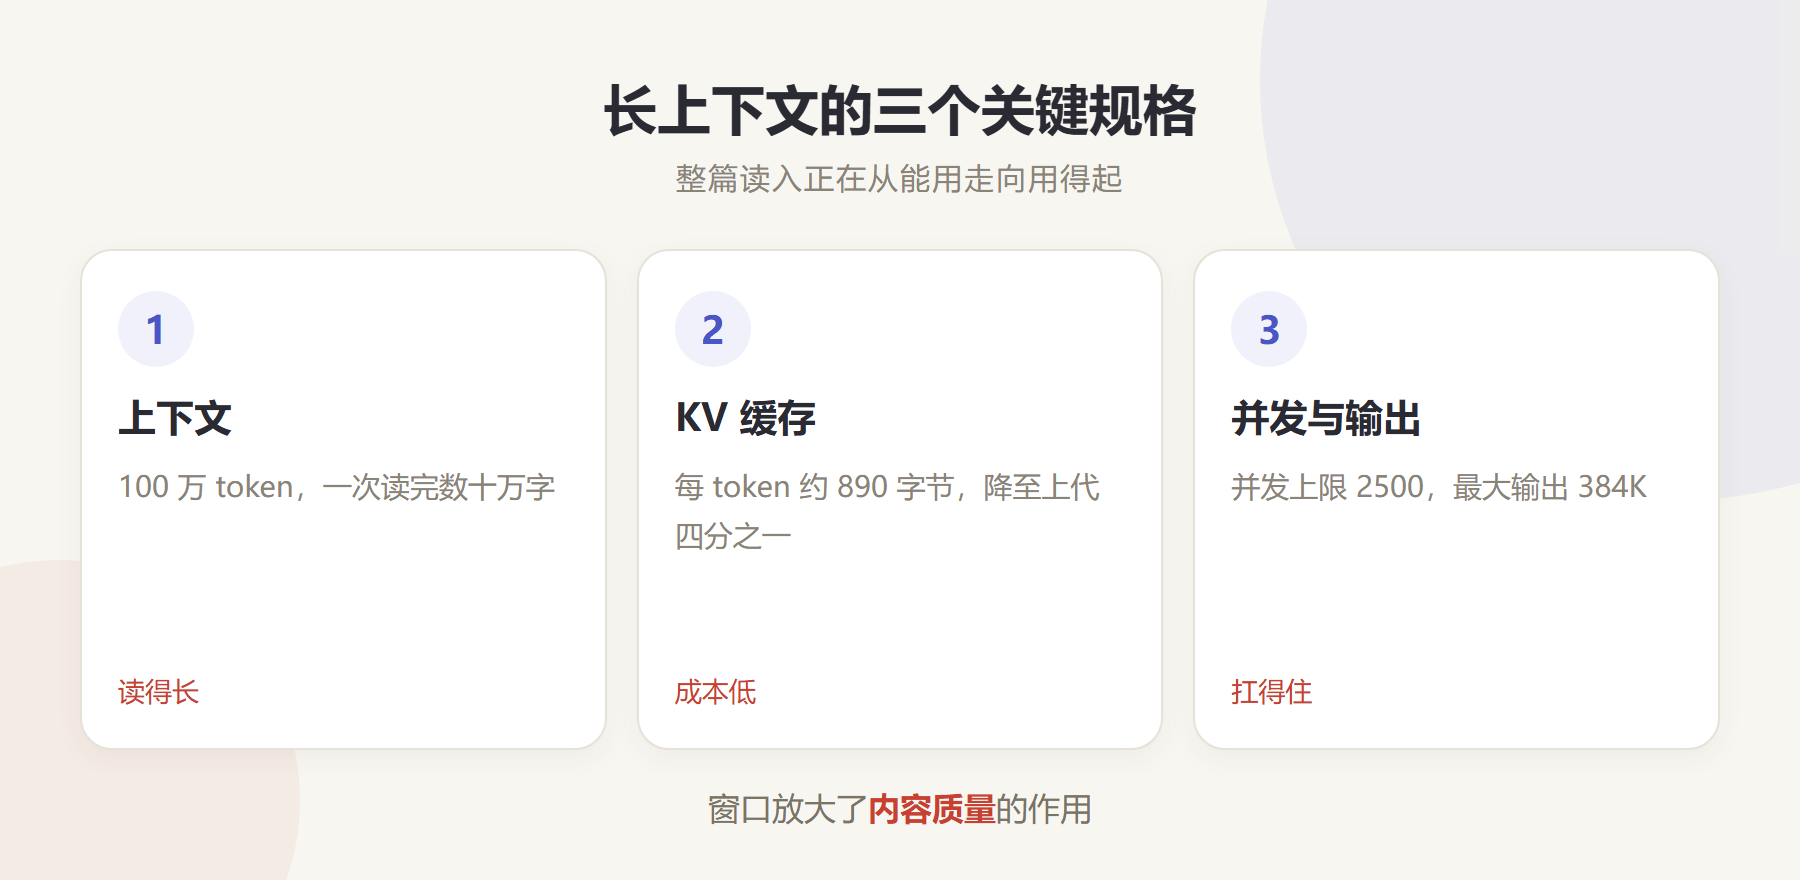 图:长上下文的三个关键规格
这些数字共同指向一个判断:长文档处理正在从"能用"走向"用得起"。当成本降到某个门槛,把整份资料交给 AI 会变成默认动作,而不是需要权衡的特殊操作。
对企业意味着什么
一个直接的推论是:企业沉淀的长文档,价值正在被重新评估。
过去,很多企业的产品手册、实施方案、招投标文件,因为篇幅长、没人愿意读,实际上处于"写了等于没写"的状态。长上下文能力普及后,这些文档有机会被完整调用——前提是它们本身写得可检索、可理解。
这里出现一个分水岭。同样是一百页文档,如果结构清晰、事实集中、口径一致,整篇读入后容易被准确引用;如果通篇是营销话术、关键数据散落各处、前后说法打架,读入越多,出错概率越高。
从公开信息看,已有服务商把"事实结构化"作为交付的一环,彼亿营销在近期的行业分享中也提到过类似思路——先把资料整理成可被机器理解的形态,再谈调用,仅作行业样本说明。
整篇采信,也意味着整篇否定
长上下文还有一层容易被忽略的影响,它改变了内容出错的代价。
在分段处理的年代,一份材料里若有一处数据过期,影响范围往往局限在那一段。模型没读到别处,也就不会把错误和正确的内容搅在一起。但整篇读入之后,所有信息进入同一个语境,一处自相矛盾的表述,可能污染整份材料的可信度。
这就是所谓"整篇采信与整篇否定"。当模型面对一份高度一致的文档,它更容易给出确定、稳定的答案;当文档内部口径打架,它的回答会变得含糊,甚至直接放弃引用。
举个具体的场景。一家企业的官网写着服务覆盖全国,一份案例页却只列了三个城市,另一份招标文书里又写成"华东为主"。这三处信息分散在不同页面时,各自都成立;一旦被整篇读入,模型就要面对一个无法调和的矛盾。它最可能的反应,是绕开这个话题,转用别的信源。
对企业来说,这不是技术问题,而是内容治理问题。同一事实在不同材料里的说法必须对齐,这不是文案层面的洁癖,而是长上下文时代的硬要求。
清点长文档,可以从三处下手
第一处是产品与技术资料。这类文档信息密度最高,也最容易被 AI 引用。检查重点在于参数是否最新、型号命名是否统一、关键指标是否有明确口径。一份三年没更新的规格表,在整篇读入的场景里,可能把过时数据带进答案。
第二处是流程与交付说明。服务周期、交付物、责任边界这些内容,过去主要给客户看,现在同样会进入 AI 的候选池。把这些内容写成清晰的条目,比写成一段笼统的描述更有用。
第三处是历史沉淀。老的方案、旧的公告、已经作废的报价,这些内容如果不加标注,会被当成现行信息采信。给它们打上时间标记,或者明确归入"历史资料",是成本很低但收益明显的动作。
这三处清点完,企业手里就多了一批"能被正确使用"的长文档。它们不一定立刻带来可见的流量,但会在 AI 被问到相关问题时,成为可被调用的依据。
一个提醒
技术迭代很快,但不必因为一个新数字就推翻既有做法。
对多数企业而言,眼下值得做的不是追参数,而是回头清点自己的长文档:哪些是可被引用的硬信息,哪些是重复堆砌的形容词,哪些关键事实只存在于某个人的口头里。
整篇读入的能力越普及,这份清点的价值越高。文档终于有人一次读完了,但要让它读出有用的东西,功夫还在文档本身。