面对散落各处的500个存量Kettle作业,"说不清、管不住、迁不动"几乎是所有数据团队的共性难题。没有资产台账就无法评估工作量,没有分级策略,盲目全量迁移只会带来巨大的业务风险与人力投入。一套完整的"盘点—分级—迁移"标准化方法论,是存量作业平滑过渡的核心前提。
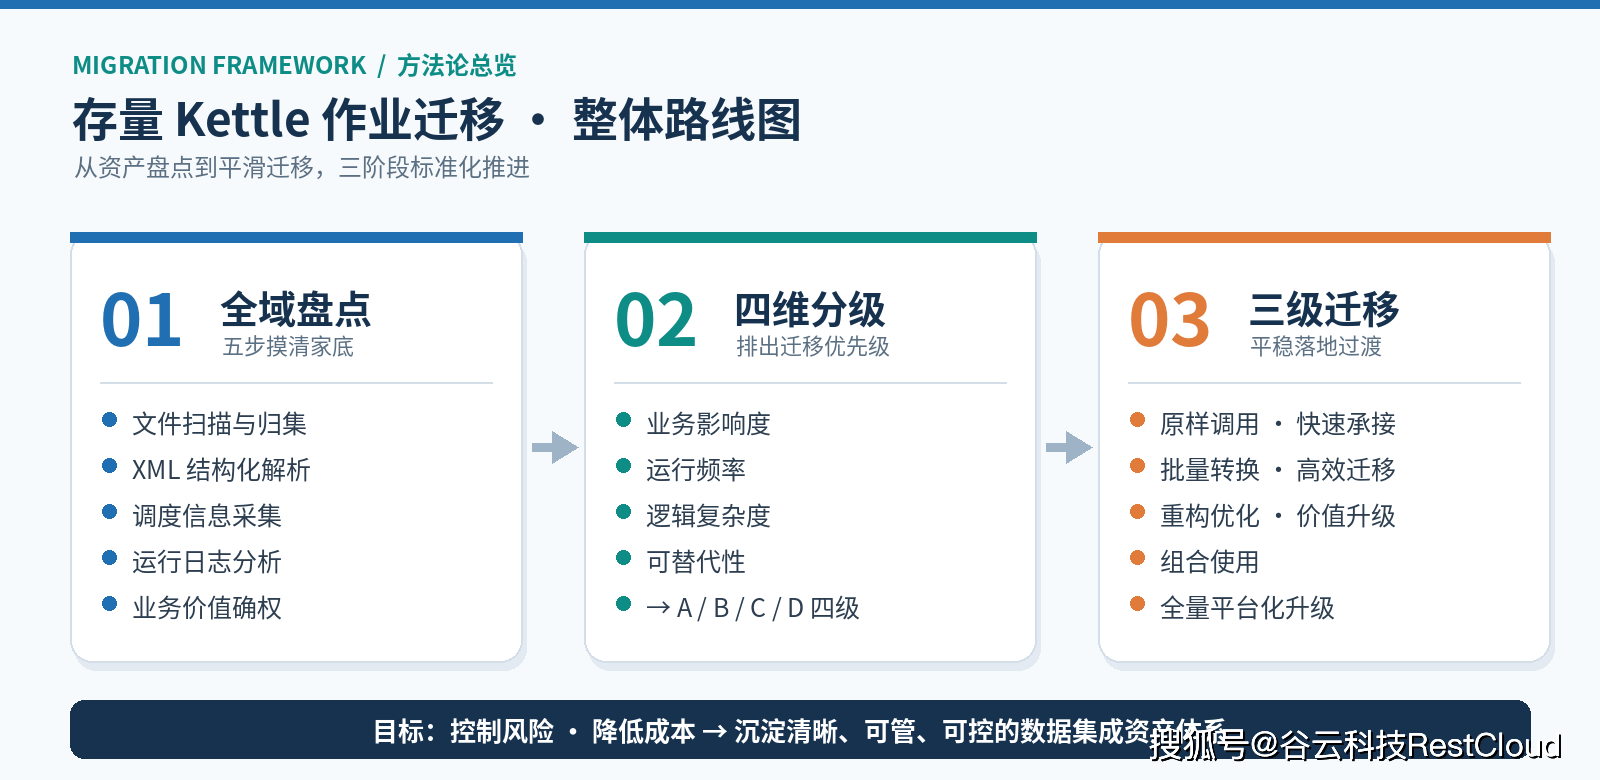
图1:存量Kettle作业迁移整体路线图
一、全域盘点:五步摸清所有作业家底
盘点的目标,是把分散在服务器、开发本地、数据库资源库中的Kettle资产,统一梳理成一份可量化、可追溯的台账。Kettle的作业文件(.kjb)与转换文件(.ktr)本质是XML,这为批量自动化盘点提供了技术基础。
图片 5
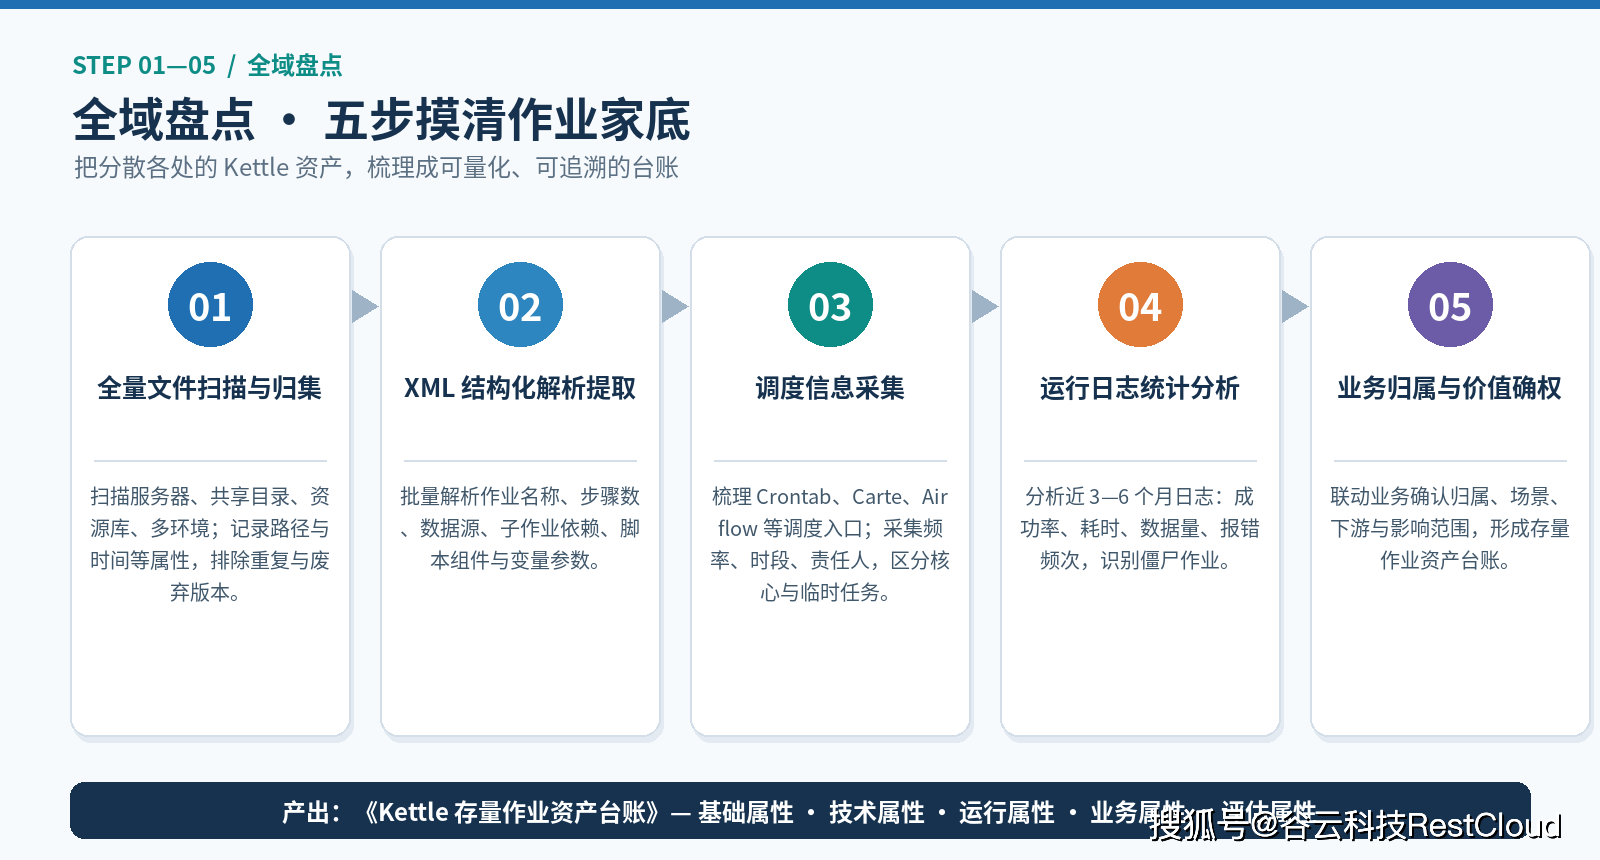
图2:全域盘点五步流程
第一步:全量文件扫描与归集。对业务线服务器目录、开发共享目录与版本仓库、Kettle数据库资源库、测试与生产多环境进行全域扫描,记录文件路径、创建与修改时间、修改人、文件大小等属性,初步排除重复与废弃版本。
第二步:XML结构化解析提取。通过脚本批量解析作业与转换的名称、描述、步骤数量,用到的数据库连接与地址,调用的子作业与依赖关系,包含的脚本组件与自定义插件,以及变量参数的定义使用情况。这一步可自动识别含复杂脚本、自定义组件的高难度作业。
第三步:调度信息采集。梳理LinuxCrontab、Windows任务计划、Carte服务、Airflow、DolphinScheduler、手工触发等调度入口,采集每个作业的运行频率、执行时段与责任人,区分核心定时任务与临时手工任务。
第四步:运行日志统计分析。提取近3—6个月运行日志,统计执行成功率、平均耗时、数据处理量、报错频次与常见错误类型,识别长期不运行的"僵尸作业"。日志是判断作业活跃度与重要性的客观依据。
第五步:业务归属与价值确权。联动业务侧确认每个作业的业务归属、支撑场景、下游消费方与故障影响范围,最终形成《Kettle存量作业资产台账》。
Kettle存量作业资产台账核心字段
二、四维分级:给500个作业排好优先级
500个作业不可能齐头并进,必须按业务价值与技术属性分级,实现"核心任务稳迁移、普通任务快迁移、废弃任务清存量"。评估体系包含四个核心维度:
- 业务影响度:故障对业务的影响范围与损失,分为核心、重要、一般、边缘业务。
- 运行频率:每日多次>每日一次>每周/每月>季度/临时任务。
- 逻辑复杂度:步骤数量、是否含自定义脚本、是否依赖多数据源、是否有复杂加工逻辑。
- 可替代性:是否有现成替代方案、能否通过标准组件快速复现。 图片 8
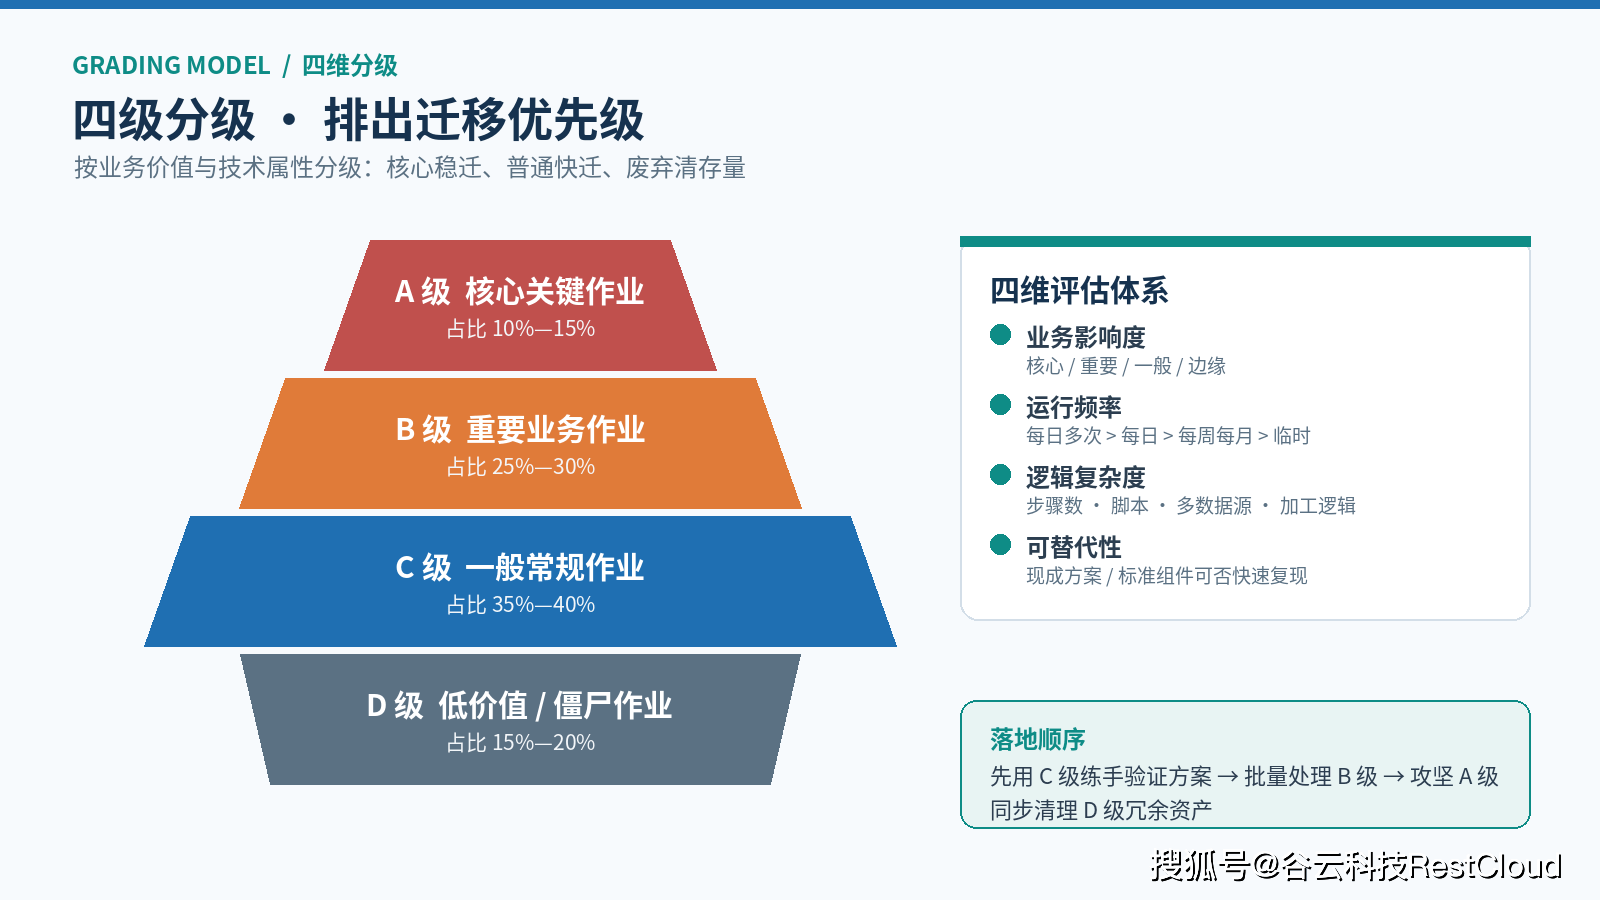
图3:作业四级分级金字塔与四维评估体系
四级分级定义与迁移策略
落地路线图:先用C级作业练手验证迁移方案,再批量处理B级,最后攻坚A级,同步清理D级冗余资产。 |
三、三级路径:分级落地,平稳完成迁移
针对不同等级作业采用差异化迁移路径,在风险、成本、收益间找到最优平衡。行业务实的做法是"渐进式三级迁移",而非一刀切全量重写。 图片 11
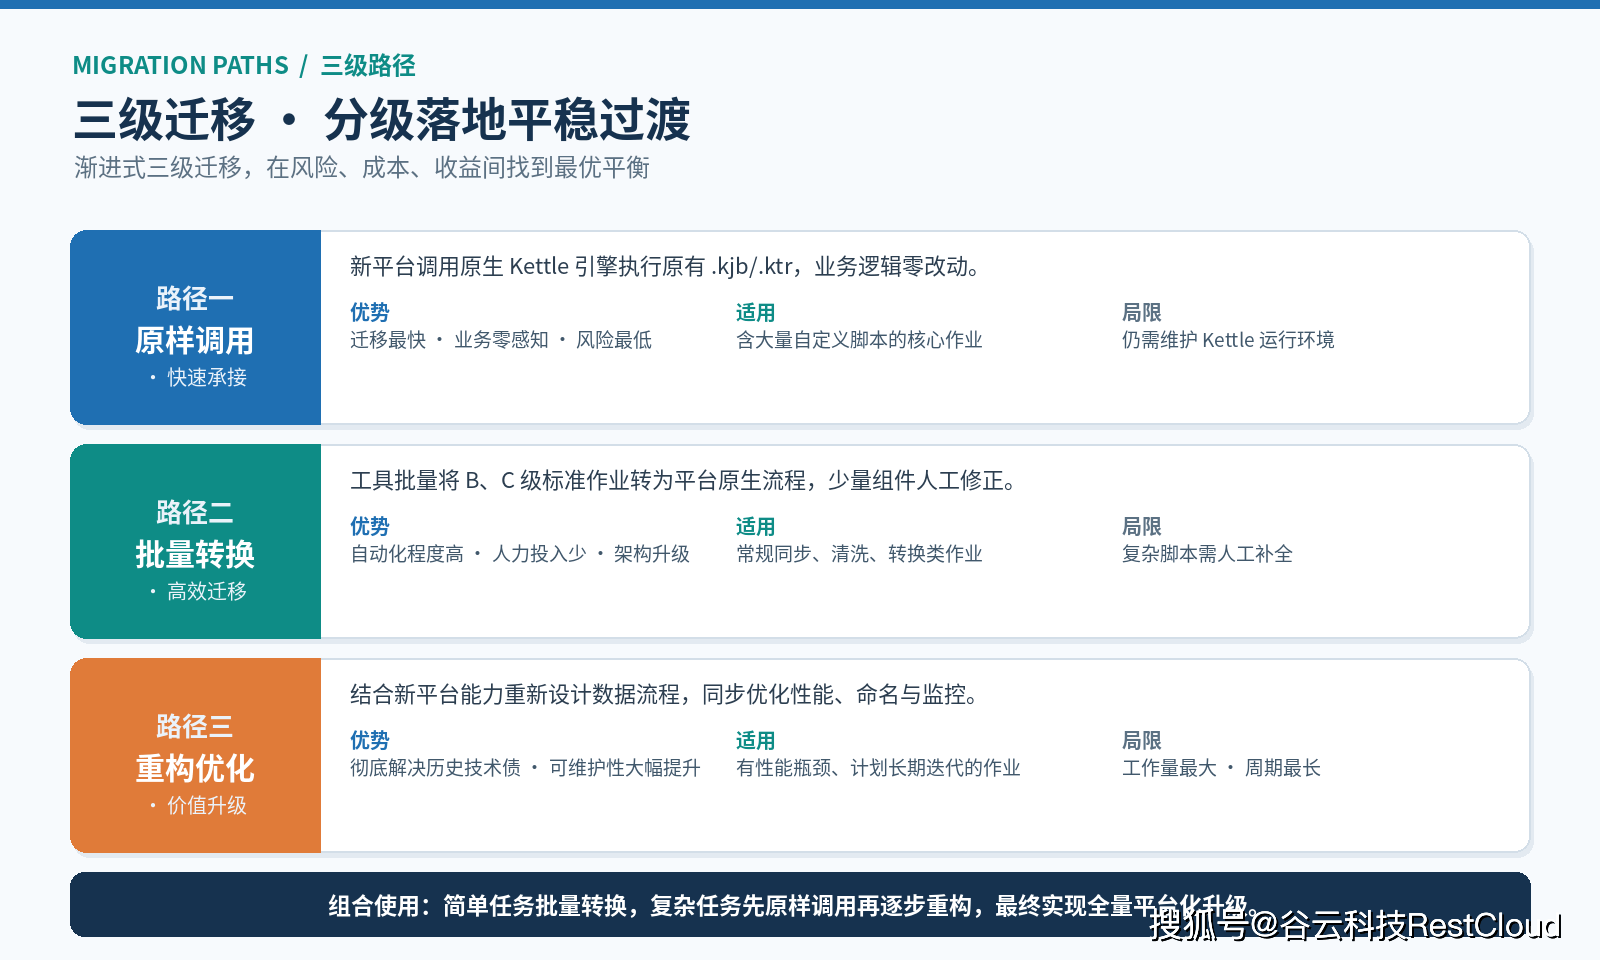
图4:三级迁移路径及各自优势、适用与局限
路径一:原样调用,快速承接。新平台通过调用原生Kettle引擎执行原有.kjb/.ktr文件,业务逻辑零改动。优势是迁移最快、业务零感知、风险最低;适用于含大量自定义脚本的核心作业;局限是仍需维护Kettle运行环境。
路径二:批量转换,高效迁移。通过工具将B、C级标准化作业批量转换为新平台原生流程,少量特殊组件人工修正。优势是自动化程度高、人力投入少;适用于常规同步、清洗、转换类作业;局限是复杂脚本需人工补全。
路径三:重构优化,价值升级。结合新平台能力重新设计数据流程,同步优化性能、规范命名、完善监控。优势是彻底解决历史技术债;适用于有性能瓶颈、计划长期迭代的作业;局限是工作量最大、周期最长。
三类路径通常组合使用:简单任务批量转换,复杂任务先原样调用再逐步重构,最终实现全量作业的平台化升级。
四、工具提效:ETLCloud助力迁移降本增效
迁移效率很大程度取决于工具支撑能力。作为国内成熟的全域数据集成平台,ETLCloud针对Kettle存量迁移提供了完整的产品化方案。
- Kettle任务一键转换:V2.4版本已上线一键转换能力,可将标准.ktr/.kjb自动转换为平台原生流程。500个规模作业中,标准化作业批量迁移相比纯手工重写可减少60%以上人力,转换后自动保留原有业务逻辑。
- 兼容原样调用模式:对无法立即转换的复杂作业,支持直接调用原有Kettle任务,实现"先统一纳管、再逐步优化"的渐进式迁移,业务全程无感知。
- 丰富原生组件:内置500+数据处理组件、支持100+种数据源,覆盖离线ETL、ELT、CDC实时同步、API集成全场景。云原生分布式架构下大数据量同步性能相比开源Kettle提升25%以上,自带数据质量监控、运行告警、全链路日志等企业级能力。
- 全Web可视化操作:采用Web界面拖拽开发,学习成本低、团队协作效率高;迁移后所有数据管道统一管理,权限、调度、监控、运维一体化。
五、避坑指南:最容易踩的5个坑
- 只盘点作业文件,遗漏转换与依赖:只统计.kjb而忽略被调用的.ktr、公共变量、驱动包、自定义插件,会导致迁移后依赖缺失。建议同步解析调用关系,完整梳理依赖链路。
- 环境差异导致结果不一致:JDK、数据库驱动、字符集、时区差异都可能导致数据异常。建议提前梳理环境依赖清单,迁移前做一致性校验,迁移后执行数据比对。
- 硬编码配置遍布,批量修改困难:大量硬编码的数据库地址、账号密码、文件路径迁移后修改成本巨大。建议盘点阶段统一识别,迁移时改造为全局变量配置。
- 跳过业务验证直接全量切换:技术侧通过不代表业务侧可用。建议A、B级作业必须经过业务侧双跑验证,数据比对一致后再切换。
- 没有回退方案,切换失败影响业务:建议保留原有Kettle调度环境至少一个月,设置一键回滚开关,确保异常时快速切回原链路。
总结
存量500个Kettle作业的迁移,从来不是单纯的技术替换,而是一次全面的数据资产梳理与架构升级。通过"全域盘点摸清家底、四维分级明确优先级、三级路径平稳落地"的标准化方法,配合成熟工具的提效支撑,可以在控制风险的前提下高效完成存量ETL平滑过渡,为企业沉淀出清晰、可管、可控的数据集成资产体系。