同一个动作,Python SDK 里叫 touch,命令行里也叫 touch,到了 MCP 工具清单里还得叫 touch。功能一致,名字也必须一致。
这件事靠人盯不住。五个入口分给五个人写,文档改一次,五份实现各改各的,漏一份没人知道,直到调用方换入口才发现对不上。
Droidline 的做法可以拆给测试开发看:全部命令和三语错误文案写进仓库根目录的一份 spec/commands.json,Python、Node.js、.NET 三个 SDK 加 MCP 工具清单都由这份文件生成。CI 里跑校验,SDK 方法跟规格不一致直接挂。
这里被测对象变了。以前测的是手机上的 App,现在还得测 SDK 本身。它怎么保持五个入口一致,本身就是一套可验证的工程。
文档不是契约,能被校验的才算
先把概念摆正。spec/commands.json 不是给人读的说明,是给构建流程读的契约。
它定义了命令名、参数、错误文案。三个 SDK 和 MCP 清单从它生成,意味着规格只有一份,实现可以有五份。要保持一致的是生成过程,不是五个写代码的工程师。
实际上的分水岭在这里:写在文档里的规则,违反了大概率没人发现;进了 CI 的规则,违反了一次也合并不进去。很多团队说"我们有接口规范",但规范在 wiki 里,实现在代码仓里,两者之间没有一条自动化的线——那不叫契约,叫约定。
错误文案也进规格,这条容易被当成小事。调用方是按文案做分支的,比如 NOT_FOUND: Could not find text 'Log in' within 10s。文案改一个词,判断分支就断一处。把它写进规格,是承认错误输出属于对外接口,不是可以随手改的日志。
核心在于:能被机器比对的东西才配叫契约。规格文件是输入,生成物是输出,比对可以自动化。文档做不到这一点。
生成器是产线,校验是门禁
五个入口都由同一份规格生成,带来的直接结果是:touch 在五处都叫 touch,文档只维护一份。省掉的不是写代码的时间,是五端接口互相漂移之后的排查时间。
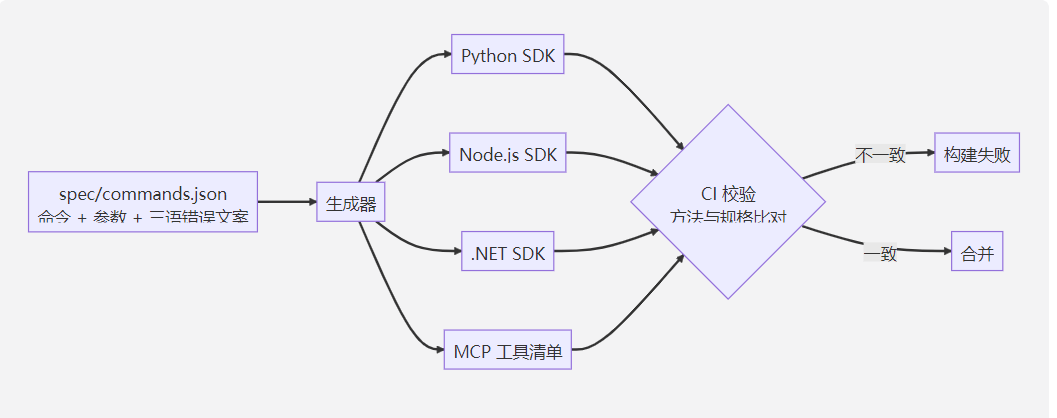
CI 那一步是整套东西的关键。生成一次保持一致不难,难的是改完之后五端还一致。把比对放进流水线,等于给"规格与实现对齐"写了一条永久回归用例。
测试开发在这条链上的活也随之改变。不用逐个测五个 SDK 的方法实现对不对,那是在测生成器;要测的是生成物和规格对不对齐——方法名、参数签名、错误文案有没有漏、有没有多、有没有改。这是典型的契约测试,只是契约的双方是规格和产线,不是服务和服务。
门禁的价值不在通过的时候,在失败的时候。漂移在合并前被拦住,成本是一次构建失败;漂移流到用户那里,成本是一次线上问题和一轮跨端排查。把拦住的位置往左移,是测试开发能给出的最直接的收益。
连接方向反转,带出的是恢复语义
另一处工程决定在连接方式上。常规方案是 PC 开端口等手机连进来,Droidline 反过来:手机主动外连,PC 一个端口不开。同 Wi-Fi 直连,人在外面走隧道或自建中继,通信端到端加密,中继手里只有密文。
配对决定谁能控这台手机,握手之后每行通信都加密。本质上是把"连通"和"授权"绑到了同一次配对动作上,不再分成"先连上再鉴权"两步。
对测试开发更值得注意的是后半句:断网重连后从断点接着跑,执行中的命令由手机侧缓存应答,不会重跑一遍。
这说的其实是幂等性。自动化里的动作不都能重放——点一次付款和点两次付款不是一个意思,发一条验证码和发两条也不是。恢复时如果重跑已执行的命令,就会造出重复副作用。缓存应答把恢复变成从断点续接,绕开了重放。
于是测试目标也变了。不是测"能不能重连上",是测"重连之后的状态等不等于没断过"。前者是连通性检查,后者才是恢复正确性。要验证的是:已完成的步骤没有重复执行,未完成的步骤接着执行,中断没有留下半截状态。
能力边界决定测什么、不测什么
README 里列了做不到的事:只用无障碍服务和自装键盘,也就是普通 App 能拿到的权限;解不开 PIN 锁,没有强停、清数据的单命令,打不开别的 App 没导出的页面。游戏和自绘界面拿不到元素,只能退回坐标点击加颜色判断。Android 15 起系统把一次性验证码从通知里藏起来,只能知道码到了、去 App 里读。
核心在于:这些不是待修的缺陷,是路线的天然上限。测试设计得先知道边界在哪,才知道哪里该断言、哪里断言不了、哪里该换验证方式。不知道边界的后果是两类浪费——写一批注定失败的用例,再报一批不该报的缺陷。
版本还在 0.1,作者写明服务端和 SDK 的测试目前对着模拟器跑,跨品牌真机验证还在进行。这句话是证据强度的自我披露。测试报告里该有的东西——证据从哪来、覆盖范围到哪、结论能推到多远——在这里都写出来了。拿模拟器的通过率当真机结论,是评测里最常见的越界。
测试对象在往上游走
把这款工具的两处设计放一起看,会发现测的东西在往上游移动。
一处是规格。五个入口的一致性不是靠逐个测方法测出来的,是靠比对生成物和契约测出来的。被测对象从行为变成了产线。
一处是证据。跨品牌真机还没验证完就写进 Status 页,这是把证据边界显式化。以前测完只给结论,现在还得说明结论建立在什么证据上。
AI 接入让这个变化更明显。droidline mcp 起来之后,Claude、Cursor 可以直接看屏点按钮,--read-only 把工具收窄到只看不动。调用方多了一类——模型按工具清单生成调用。工具名、参数、用途描述都得机器可读、规格明确,这恰好是单源规格的用武之地。模型读到的清单和 SDK 用的是同一份定义,才不会出现"清单里说能点,实际点不动"。
实际上分工没变:生成器负责让五个入口长得一样,规格负责定义什么是对的,人负责判断规格对不对、证据够不够。产线能自动产出,判断不能一起外包。
你们那边多端 SDK 或接口定义,是几份手工维护的?改一个命令名,要动几处,靠什么保证没漏?
本文部分内容参考了霍格沃兹测试开发学社整理的相关技术资料,主要涉及软件测试、自动化测试、测试开发及 AI 测试等内容,侧重测试实践、工具应用与工程经验整理。