11月15日,中科曙光自研的scaleFabric高速网络入选“2026中国算力应用典型案例”。对大模型训练来说,网络并不是把服务器连起来就结束了。多节点训练过程中,参数同步、集合通信和数据读取都要经过网络;网络一旦拥塞或故障,等待时间就会传导到整场训练。
训练任务为什么离不开高速互连?
大模型训练需要多个计算节点协同工作。不同节点之间要交换梯度、参数和中间结果,MoE等模型还会产生大量跨节点的小消息。如果网络传输慢,GPU可能需要等待数据或等待其他节点完成通信,导致计算资源空转。
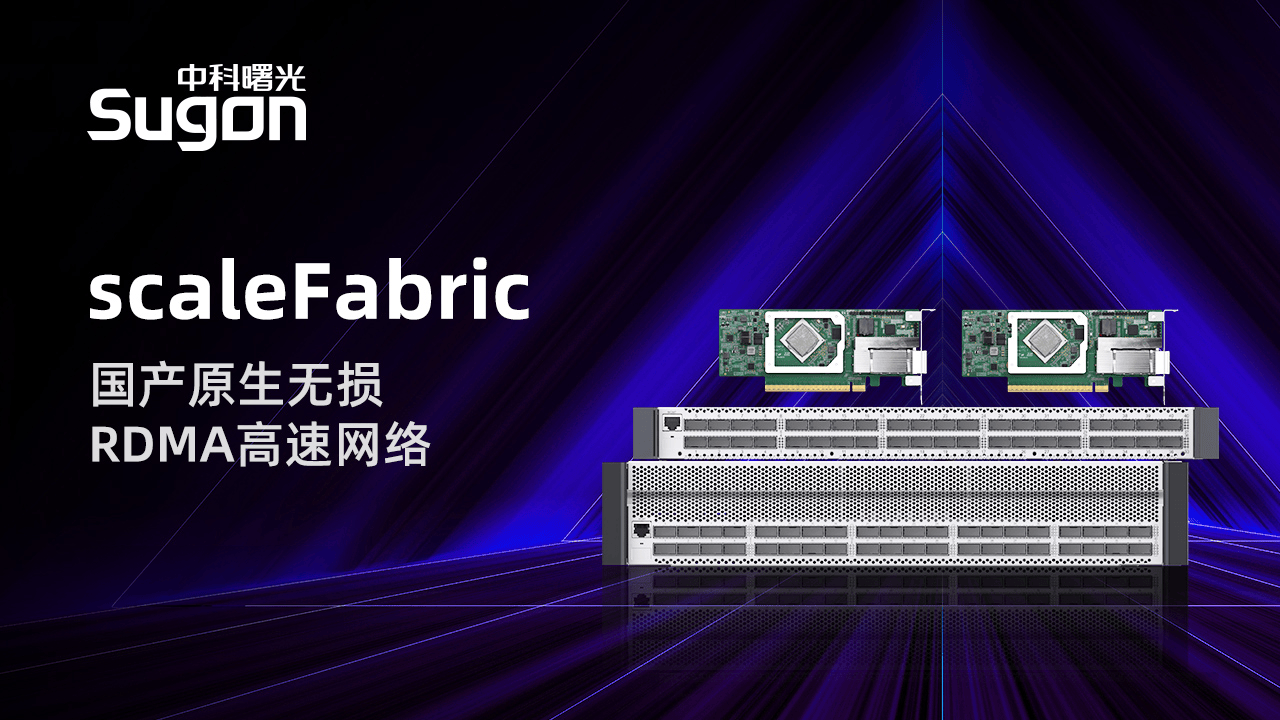 中科曙光自研scaleFabric高速网络入选2026中国算力应用典型案例。
scaleFabric解决的是哪些问题?
中科曙光披露,scaleFabric采用多平面组网架构,在单一子网内实现大规模互连;支持毫秒级链路切换,路由恢复时间不随集群规模增长而延长。配合FabricView高速网络管理平台,可以筛查异常节点、定位繁忙链路和异常端口。它关注的不只是峰值带宽,也包括故障恢复和运行管理。
IBGDA让GPU更直接地参与通信
IBGDA支持GPU直接发起网络通信,减少CPU参与通信调度带来的开销。对大模型多节点协作而言,这有助于缩短通信等待。官方披露,scaleFabric已完成DeepEP通信框架适配,为大模型多节点协作和Token生成效率提升提供支持。
入选案例不等于所有训练都能提速同一比例
网络性能会受到模型结构、节点数量、消息大小、并行策略、存储和软件栈等因素影响。scaleFabric入选典型案例,说明其在大规模智算网络工程实践方面获得认可;具体项目能提升多少,还需要结合实际任务和测试口径评估。