在OLTP 库里一次提交就能生效的事务,进了湖仓往往要等十几秒甚至几分钟才“可见”。问题不在存储,在事务模型。
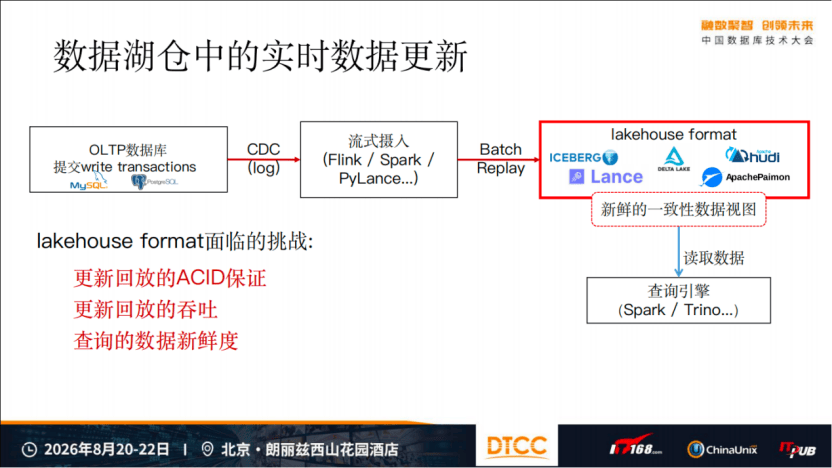
中国人民大学副教授卞昊穹在 DTCC 2026 上把这层讲透:CDC 日志经 Flink、Spark 写入湖仓格式,Spark、Trino 读出一致性视图,这条链路悬着三道坎——更新回放的 ACID、更新回放的吞吐、查询的数据新鲜度。
DTCC 2026|2026.8.20—22|北京
湖仓的“事务”,本质是文件级的 git 提交
主流湖仓格式(Iceberg、Delta Lake、Hudi、Paimon、Lance)的写入是文件级 catalog 事务,不是行级事务;只支持串行写,像 git 的串行提交,而非 MVCC;ACID 也只覆盖单表、文件级,跨表事务无从谈起。
实现分两类:Iceberg、Paimon、Lance 把每个版本物化成 catalog 快照,查询直接读;Delta Lake、Hudi 记 write-behind log,查询时重建快照。
更新侧是取舍:Copy-on-Write 读友好、更新贵;Merge-on-Read 适合 CDC,代价压回查询。补偿手段是运行时合并、删除文件、删除向量(DV)和 compaction。

图1:CoW 与 MoR(来源:DTCC 2026)
五款格式的横向体检
团队在 SIGMOD FORMATS’26 论文里做了评测:HyBench SF1333(1TB、116 亿行)与 CH-benCHmark WH10000(778GB、50 亿行),随机更新约 70%、插入 25%、删除 5%。
结果:Iceberg 新鲜度好但吞吐不及 Paimon;Paimon 吞吐强,开 DV 后写性能受损;Delta Lake 构建 DV 效率低;Lance、Hudi 索引效率不如 Paimon。索引还普遍面临三道难题:大到放不进内存、随机 I/O 不友好、要与 catalog 和版本对齐。
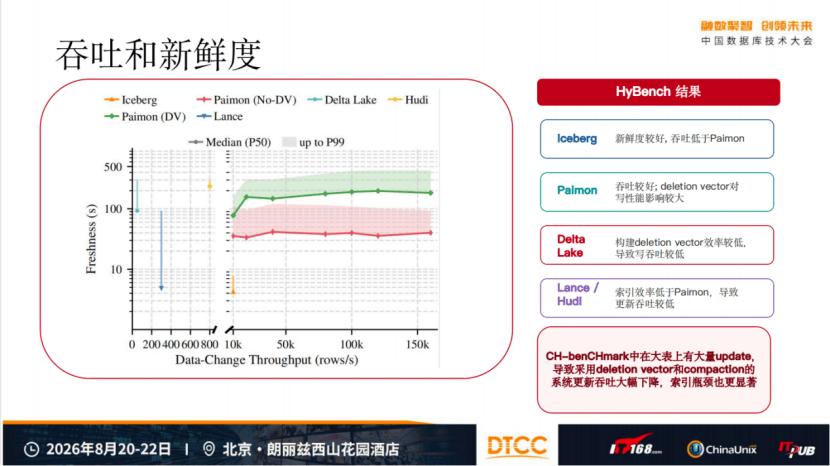
图2:吞吐与新鲜度对比(来源:DTCC 2026)
不是真 MVCC,也逃不开 RUM
判断一:现有湖仓不是真正的 MVCC。批量更新、串行写、单表 ACID,撑不起行级、跨表、并发的实时回放。
判断二:逃不开 RUM 理论。查询性能、更新成本、内存开销互相牵制,五款格式各占一角,三样都要只能换结构,不能打补丁。
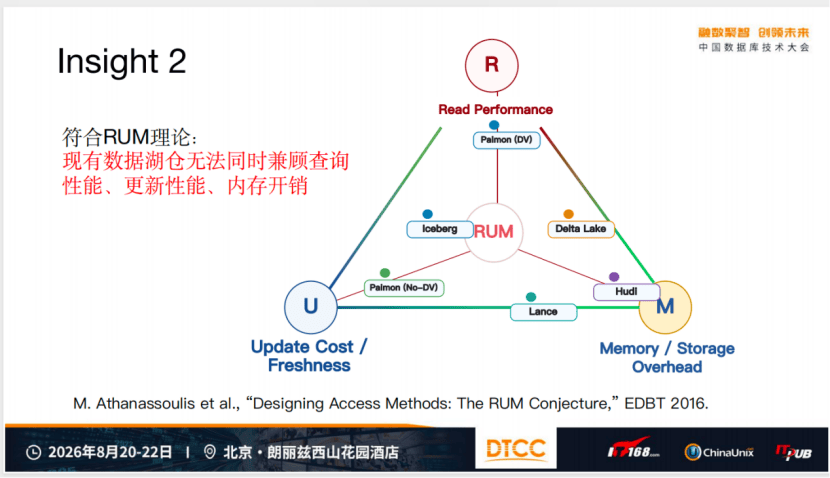
图3:五款格式的 RUM 定位(来源:DTCC 2026)
Pixels-Retina:为湖仓重做一套 MVCC
Retina 是团队在 Pixels 之上的表格式层(PVLDB V19,2026),核心是四件事。
跨表镜像事务:CDC 消息按源事务提交顺序到达,Sink 按 txn ID 聚成 mirror txn,按到达顺序分配递增 ts,再哈希到多个 replayer 并行回放。源库一次事务,到湖仓仍是一次事务。
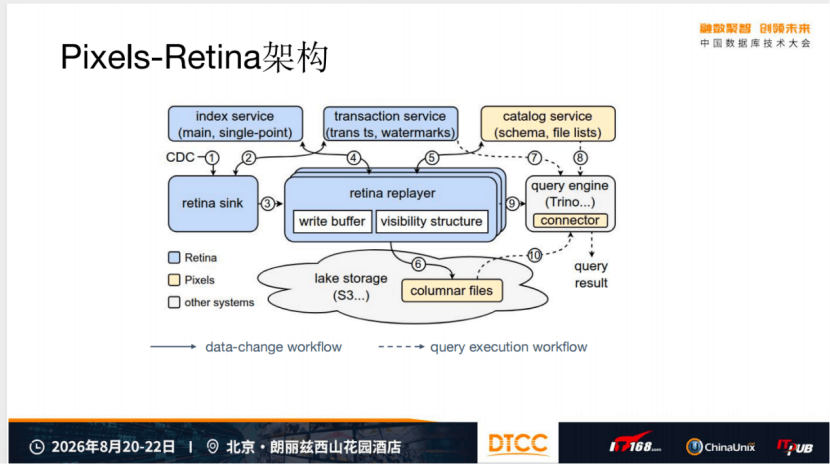
图4:Retina 架构(来源:DTCC 2026)
行级可见性:row group 切成 4096 行的 tile,每 tile 一份可见性结构——base ts 前不可见的版本记进 bitmap,之后被删的追加进 delete ts array,随 LWM 前移合并回 bitmap 完成内存回收。查询侧用 SIMD 向量化过滤,与写入、GC 无并发冲突。
行级 MVCC:HWM 之前的事务都已回放成功,LWM 之前的查询都已结束,新查询以 HWM-1 作快照,每个 tuple version 带 create_ts 与 delete_ts。
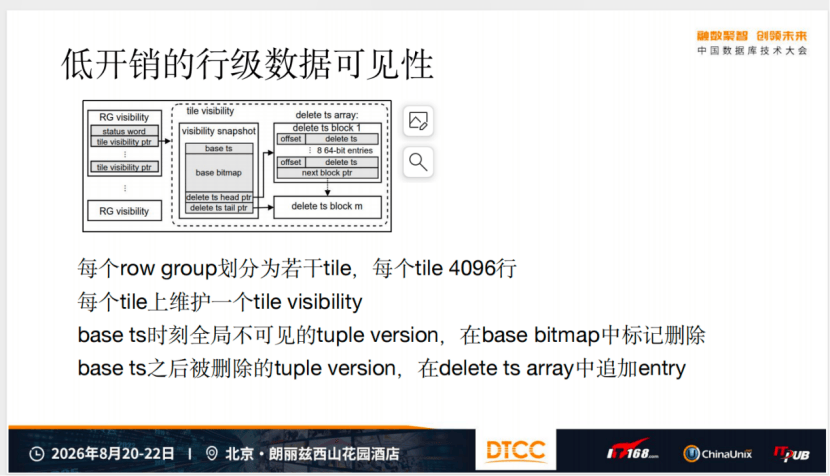
图5:tile 级可见性(来源:DTCC 2026)
不做 compaction:新版本进 write buffer,按 4096 行 block 刷入 S3 合成大文件;老文件里被删版本占比过阈值才局部重写。解决小文件和可见性判断后,scan 类查询没必要做 compaction。索引做成插件式,与数据共用同一套多版本规则。
成绩单:10ms 新鲜度,5% 查询代价
新鲜度 10ms 级,现有湖仓多在 10s 到分钟级;高吞吐更新只带来约 5% 的查询性能下降;内存开销低于同场湖仓与 HTAP,吞吐可线性扩展到百万行/秒。可见性结构每个 tuple version 只占 1.1—2 bit,1TB 数据集不超过 1GB 内存。
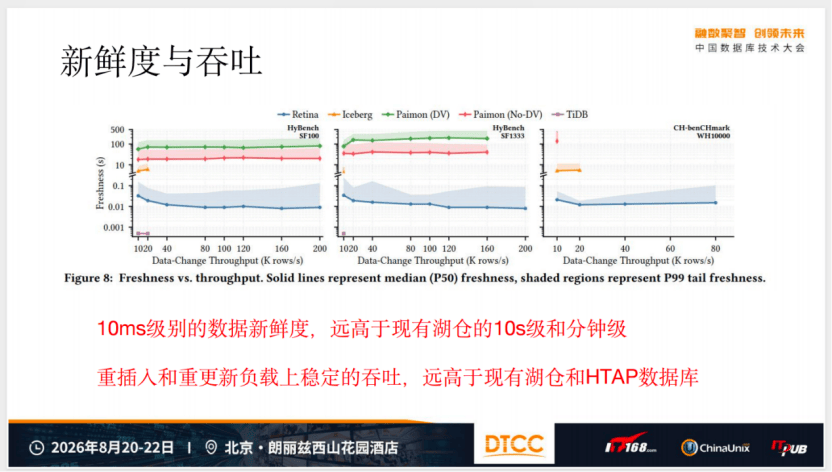
图6:新鲜度与吞吐(来源:DTCC 2026)
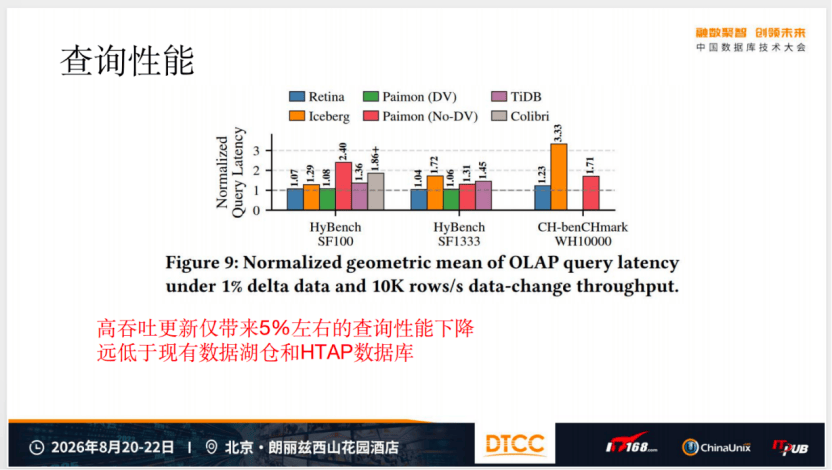
图7:查询延迟(来源:DTCC 2026)
已落地中移动磐维 OLAP、腾讯 TDSQL、华为慕尼黑研究院、微软 Bing 搜索日志数据湖,相关优化编入国标 GB/T 41818-2022。
湖仓从来不缺便宜的存储,缺的是像数据库那样可靠的事务。把 MVCC 搬进表格式之后,吞吐、新鲜度、查询性能这三件事,第一次不用互相让步。
|嘉宾介绍|
卞昊穹
中国人民大学 副教授
卞昊穹,入选国家和北京市海外人才项目,以第一发明人获得数据库领域首个中国专利金奖。研究方向为AI Infra和大数据系统。曾在国际顶尖数据系统团队EPFL DIAS Lab负责云原生数据系统研究、在腾讯公司从事分布式数据库内核研发,具有学术界和工业界双重研发背景,长期在一线负责关键算法和系统架构研发,坚持研究工作来自实际问题、应用于实际系统。
自2017年以来主持研发开源云数据湖仓引擎Pixels (https://github.com/pixelsdb/pixels),已在SIGMOD、ICDE等重要国际会议发表论文十余篇,获得多个产研重点合作项目支持,应用于多个企业级数据库产品,其中部分关键技术编入大数据领域国家标准。