最近在和几家创新药、新材料企业的研发负责人及IT总监聊数字化选型时,发现一个很有意思的分歧:
随着AI4S 概念的火热,市场上开始流行一种“科学数据中台”的打法,这类产品的蓝图非常宏大,试图把分散在 ELN、LIMS、仪器软件甚至外部数据库里的异构数据整合起来,通过可视化工具清洗、关联、建模,最终沉淀为企业的数据资产去赋能BI和AI 。
从顶层设计的逻辑来看,这套思路对于历史包袱极重、拥有十几个老旧异构系统的大型集团确实有其考量。但从我近期接触的一线客户真实反馈和落地效果来看,绝大多数成长型药企或研发团队如果盲目跟风上这类重型架构,大概率会踩进四个“大坑”:
一、 数据中台的4个现实痛点
- 沿用过时的“数据中台”重资产模式,一线未必用得起来
深入看这类“多源科学数据整合平台”的工作方式,本质仍是传统数仓与2015年互联网“数据中台”的翻版:先接入不同系统的数据,再进行清洗、关联和建模,最后供报表和 AI 使用。
但这种重型模式近年已被行业普遍反思,Data Mesh(数据网格)与 Gartner 推崇的 Data Fabric(数据编织)均主张减少搬运、转向源头治理;连最早提出该战略的阿里也在 2023 年变革中明确提出“中台变薄”,将能力下沉回一线业务。
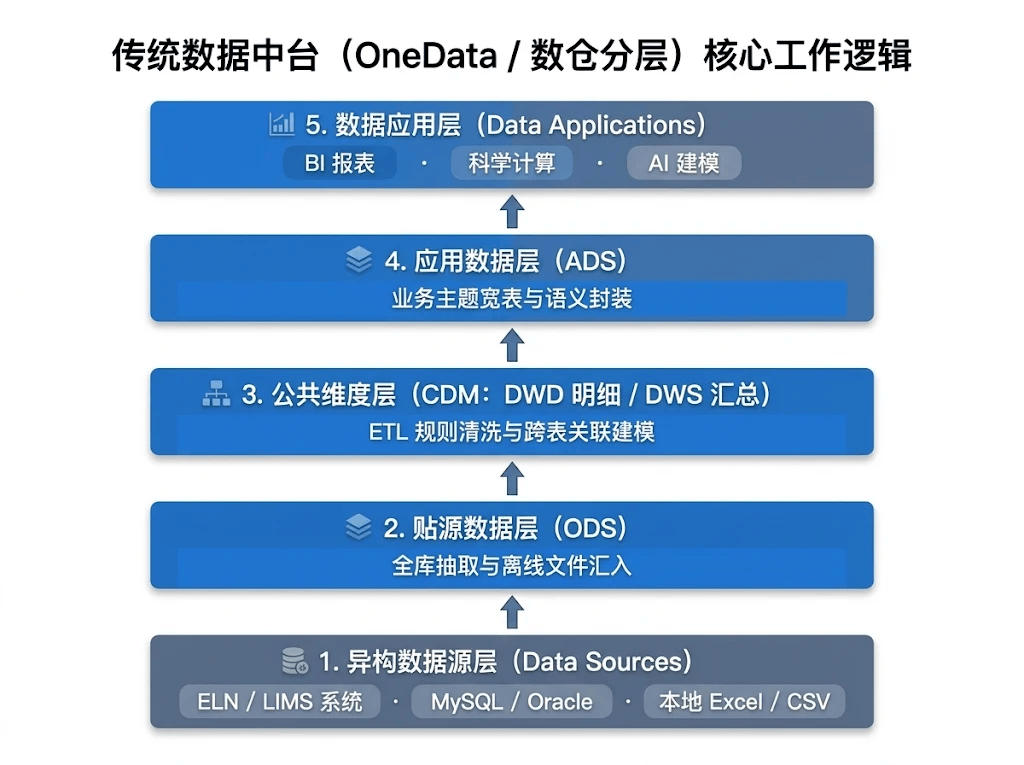
图源:参考传统数据中台的分层处理逻辑整理绘制
放到研发实验室里,这套过时架构的弊端被进一步放大:
数据必须先经过复杂的抽取、清洗和规则配置才能入库——对于散落在研发人员本地电脑里的大量 Excel 或仪器文件,甚至还得依赖人工定期手动上传到中台,不仅增加了科研人员的额外负担,极易因漏传、忘传导致数据断更与版本混乱;而到了配表关联、写清洗规则的环节,普通研发人员更是玩不转,最后还是得靠专业IT团队或厂商实施人员驻场维护。
事实上,如今企业软件的接口已经非常开放,虽然科研数据存在多源异构的特点,但绝大多数研发团队的数据体量远没到互联网那种动辄几个PB的量级,系统复杂度也远低于大型互联网集团。为了日常数据分析,专门养一套重型数据中台,属于典型的架构过度设计。
2. “先污染后治理”的路径依赖,忽视了源头结构化
ELN(电子实验记录本)里既有结构化数据,也有大量非结构化的实验步骤与现象描述。传统中台的思路是:先把数据全抽出来,再在中间层做清洗和结构化,这本质上是“先污染,后治理”。 但在真实的科研场景里,合理的路线应该是源头结构化:本身就是结构化的数据直接留在ELN里,通过接口供外部调用;而对于非结构化的实验记录,应该在研发人员创建记录的源头,通过预设模板做好结构化字段标记,随写随生成结构化数据,直接对接第三方BI系统,根本不需要中间层再做一遍繁琐的二次清洗。
3. AI时代,多一层中转就是多一层冗余
很多厂商推数据中台的一个重要理由是:为AI提供高质量数据。如果是十年前做传统机器学习,这么说还有几分道理,但在大模型和AI Agent(智能体)已经高度成熟的今天,AI本身就具备极强的非结构化文本理解与推理能力。 研发数据完全可以通过标准化接口,直接推送给AI智能体进行总结、检索和辅助分析。硬要在ELN和AI之间塞进一个数据中台做中转,除了成倍增加部署成本和接口维护工作量,没有任何实际意义。
4. 最致命的隐患:权限断层导致的核心IP泄密风险
这是很多企业在选型时最容易忽略、但一旦出事就无法挽回的“深水区”。ELN里的研发数据是企业最核心的知识产权,权限管控通常极其精细且动态变化(按项目组、课题甚至单条记录实时隔离)。一旦把数据同步抽取到外部的数据中台数据库里,ELN原有的动态用户权限很难做到1:1实时同步。极易出现一种灾难性的越权场景:在ELN里A用户明明无权查看B用户的实验数据,但到了中台或下游报表里,A却能直接看到B的数据。这种权限断层,对企业来说,是严重的泄密隐患。
二、 业内正在跑通的另一种思路:轻量化“源头直连”架构
其实看看国际标杆 Benchling 的成功路径就很清楚了:它之所以能重塑欧美药企的研发数字化,核心恰恰在于没有搞重型数据中台,而是通过底层 Schema 机制(即在实验记录中内嵌预设字段的结构化表单),让科学家在写实验记录时就顺手完成数据结构化,再直接通过标准 API 或只读数据仓库对接外部分析工具。
而从近期接触的国内新一代轻量化云原生ELN落地案例来看,这种“砍掉中间层、源头直连”的架构甚至走得更彻底、更贴合本土团队的痛点:
- 做实验即完成结构化,科研“小白”零负担: 真正好用的系统,不应该要求研发人员懂数据库。通过灵活的实验模板设计,研发人员在正常做实验、写记录的过程中,非结构化内容就会自然转化为结构化字段,不需要额外花精力清洗,也不需要IT团队介入。更进一步,即便不同课题组使用的整体记录模板各不相同,只要在记录中嵌入了统一的方法模板,系统就能在不限制科研记录自由度的前提下,自动把分散在不同实验里的同类数据拉通聚合。
- 标准化接口直连BI,省去中间“数据搬运”环节: 既然关键实验参数已经在ELN底层按字段沉淀好了,系统只需对外提供标准化的数据接口或只读视图,企业现有的BI工具(如PowerBI、帆软等)就能直接按需拉取并生成分析看板。整个链路里,不再需要中间层去做二次建表和写清洗脚本,不仅大幅缩短了报表上线周期,也省掉了额外采购和维护数据中台的预算。
- 为内部AI应用保留原生上下文,避免重复“搬运”数据: 现阶段不少研发团队都在探索用内部大模型做历史实验检索、相似批次比对或异常复盘。这类场景最怕数据碎片化——传统做法还得先靠中台把散落的数据拼起来;而源头结构化的ELN本身就完整保留了“物料—工艺参数—结果—实验备注”的上下文关联,内部AI智能体直接通过标准接口按需检索调用即可,完全没必要为了上AI而先把数据折腾进另一个中台库。
- 接口级权限实时同步,守住安全底线: 也是最关键的一点(甚至比许多海外平台直连SQL仓库时还要省心)——所有的外部数据接口,必须与ELN本身的用户权限体系实时绑定。用户在ELN里有多大的查看权限,通过接口调取数据时就严格继承同等的权限范围,既避免了在中间平台二次分配权限的管理混乱,也从根源上杜绝了越权泄密。
说到底,研发数字化的初衷是给科学家减负,而不是为了“建数据资产”的口号,给一线团队再套上一层沉重的枷锁。在工具越来越智能的今天,把源头做扎实、把接口做开放、把权限管严实,远比叠床架屋造一个庞大的“数据中台”要务实得多。