智猩猩AI整理
核心作者投稿
Agent 的问题,有时不是不会行动,而是一直在沿着错误的理解行动。
搜索了一轮又一轮,却始终围绕一个未经验证的候选答案;执行了大量排查命令,故障判断却从一开始就错了;局部功能已经跑通,遗漏的任务要求却迟迟没有被发现。
这些行为有一个共同点:每一步看起来都“有道理”,整条任务轨迹却可能越走越偏。
一个值得追问的问题是:
工具明明返回了真实信息,为什么 Agent 还是会持续犯错?
中国人民大学高瓴人工智能学院的研究者们在轨迹分析中发现,未经证实的假设、过时的计划和错误的进度判断,会持续留在交互历史里,影响后面的推理与行动。他们将这一现象称为任务状态污染(task-state contamination)。
问题不只是“有没有拿到反馈”,更在于“如何理解反馈,以及接下来怎么做”。
针对这一问题,研究团队提出并开源了Agent-Editing World Model(AEWM)。与预测工具返回的语言世界模型不同,AEWM 将建模重点转向 Agent 的决策:判断当前推理与行动可能如何影响任务进展,并在执行前修订低价值决策。
实验中,AEWM 在行动判断基准上超过最强对照模型10.6 个百分点;配合其推理框架 EditAct,Qwen3.5-35B-A3B 在 Terminal-Bench 2.0 上从 37.1% 提升至 48.3%。
更进一步,这些经过修订的交互轨迹还能用于训练 Agent,让部分收益在不再调用 AEWM 时继续保留。

论文题目:Agent-Editing World Model: Rethinking World Modeling for LLM Agents
01 AEWM:从预测环境,到
判断并编辑决策
现有许多面向智能体的语言世界模型,仍沿用“预测环境反馈”的建模方式,例如生成搜索返回、终端执行结果或测试输出。
但这类环境观测本身具有较强的不确定性,并且高度依赖真实执行上下文:搜索结果会随网页内容、检索系统和排序策略变化,终端与测试反馈则与文件系统、依赖配置和运行时状态紧密相关。
因而,想要准确复现这些反馈本身就十分困难;更重要的是,在智能体可以直接调用真实工具获取可靠反馈的场景中,花费模型能力去“模拟环境”未必是最有价值的选择。
AEWM 因此换了一个建模重点:
不是重建“工具会返回什么”,而是预测“当前决策会对任务推进起到什么作用”。
同一个 AEWM 模型学习两项能力:
Action Judge:区分关键推进、有效探索与无效行动。
在行动执行前,模型根据任务、已观察到的交互历史,以及当前候选推理与行动,预测它属于哪一类:
Critical:关键推进。获取必要证据、解决关键障碍,或完成任务所需的状态改变。
Exploratory:有效探索。检验合理假设、排除候选分支,或减少与任务有关的不确定性。
Noisy:无效行动。重复已知信息、偏离任务要求,或继续沿着缺乏依据的方向行动。
这里一个重要的区别是: 没有立刻解决问题,不等于这一步没有价值。
一次排查即使没找到答案,只要可靠地排除了一个合理分支,就仍然值得保留。
AEWM 要减少的是无效重复,而不是必要的探索。
State Revision:不只给建议,而是直接改写下一步。
如果候选决策被判断为 Noisy,AEWM 就基于同一份已观察历史,生成替代的推理与行动:重新审视错误假设,处理相互矛盾的证据,或者把遗漏的要求重新纳入计划。
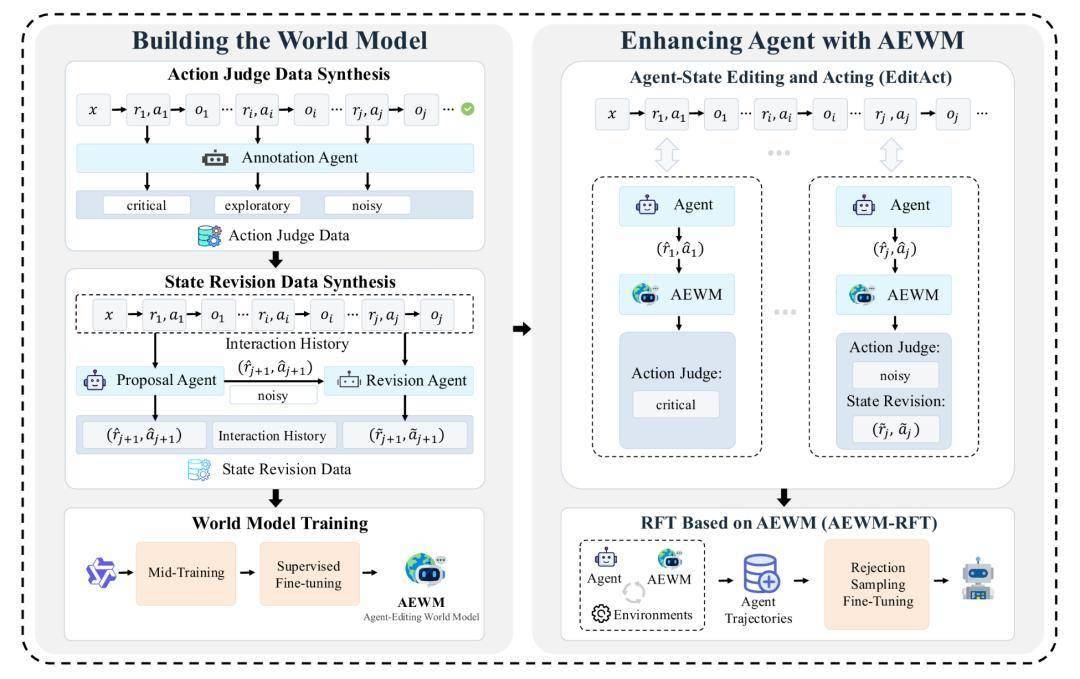
图:AEWM 的数据构建、训练与应用框架,左侧学习判断和修订,右侧接入真实执行并收集训练轨迹。
02 EditAct:先判断、必要时修订,
再真实执行
具备判断和修订能力之后,如何真正改变 Agent 的行为?
研究团队提出 EditAct,将 AEWM 接入 Agent 的执行流程。
原本,Agent 提出下一步决策后,就直接调用工具。现在,对于常规工具交互,流程变为:
Agent 提出决策 → AEWM 判断 → 保留有效决策或修订 Noisy 决策 → 真实执行 → 更新交互历史。
Critical 和 Exploratory 决策被保留,只有被判断为 Noisy 的决策触发修订。最终采用的推理、行动和真实工具反馈,一起进入后续历史。
这一设计的关键,不是多加一句“你再想想”,而是让修订后的内容直接成为下一步执行和后续推理的起点。
一个真实案例:服务没启动,还是检查方式不对?
在论文展示的一个成功案例中,Agent 需要实现并运行一个 gRPC 服务。
日志已经显示启动成功,但它在 IPv4 端口列表中没找到目标端口,于是继续沿着“服务没有正常监听”的方向排查。
AEWM 注意到,代码实际绑定的是 IPv6 地址,而此前检查的是 IPv4。它将下一步改为检查 IPv6 监听信息,真实执行后发现:目标端口确实正在监听。
随后,另一处修订将重复端口检查转向实际 RPC 读写验证,最终任务通过全部 7 项测试。
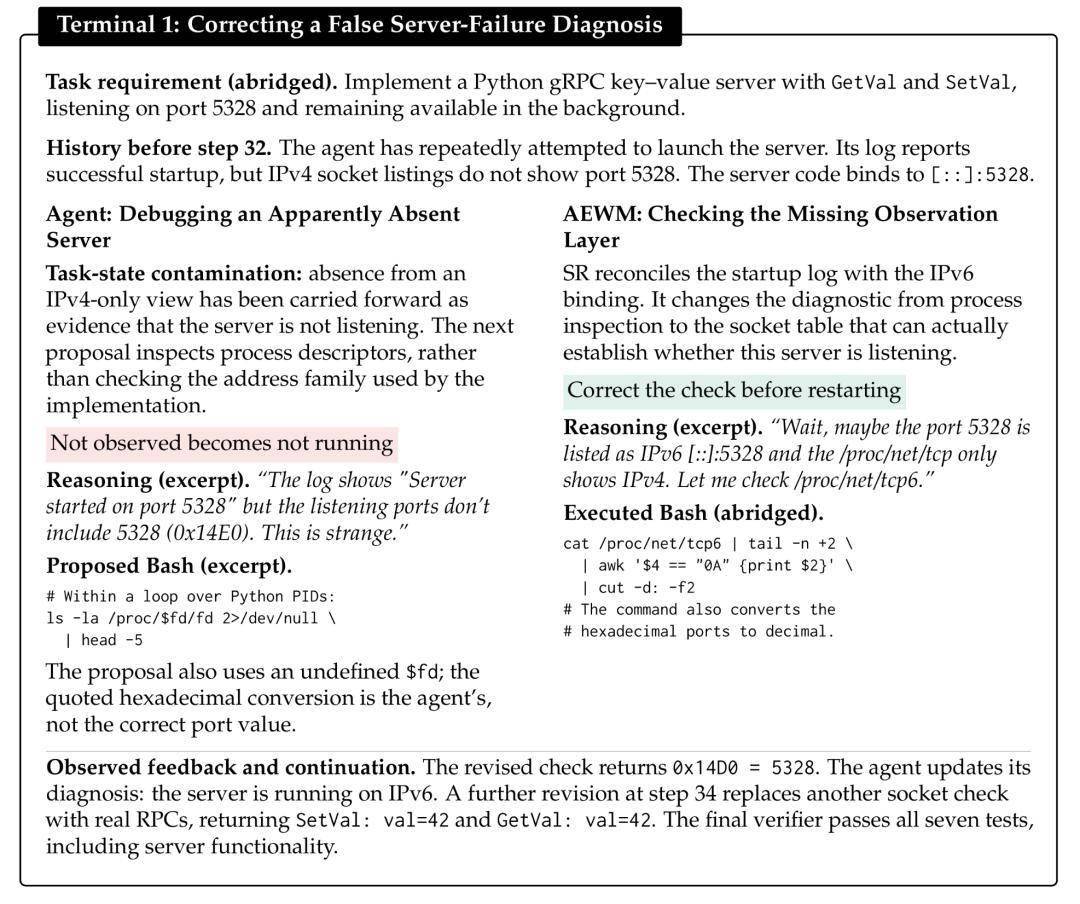
图:AEWM 修正“没有观察到,就等于没有运行”的判断,再通过真实调用验证服务功能。
这次修订的价值,不是让世界模型凭空宣布“服务正常”,而是纠正 Agent 对已有证据的理解,并选择能够验证这一判断的行动。
03 不只设计提示词,还要
学会判断和修订
研究团队以Qwen3.5-35B-A3B为基座,在 Search、Terminal 和软件工程(SWE)三个领域训练统一的世界模型。
训练数据围绕两个问题构建。
第一,这一步到底对任务产生了什么贡献?
对于 Action Judge,标注模型结合真实工具反馈和后续轨迹,判断每个决策的贡献类型。后续信息用于离线确定标签,但不会作为 AEWM 执行前判断时的输入;训练中的判断理由也通过过滤,避免引入当时尚不可见的信息。
这相当于:用实际发生的结果建立监督,再让模型学习从执行前的证据预测决策作用。
第二,改写后的决策是否真的更有用?
对于 State Revision,修订模型从相同历史出发提出替代方案,再执行修订后的行动。只有获得真实执行反馈和后续轨迹支持、带来实质性任务进展的样本,才被保留。
最终,AEWM 先进行 52.16B tokens 的中期训练,再使用 12 万条精选样本进行监督微调,其中行动判断与状态修订各占 6 万条。
04 六项基准、三个 Agent 基座,
这种编辑到底有没有用?
一、能否在执行前,判断出决策的作用?
研究团队构建了包含 3,000 个决策样本的 Action Judge Benchmark,Search、Terminal 和 SWE 各有 1,000 个样本。
模型只能看到执行前的信息,不能提前访问当前行动的工具返回或后续轨迹。
结果显示,AEWM 的整体 Macro-F1 达到 70.5%,超过最强对照模型 DeepSeek-V4-Pro 的 59.9%,提升 10.6 个百分点。三个领域的 Macro-F1 分别为 60.9%、72.1% 和 77.8%,均高于对应领域的最强基线。
图:AEWM 在 Search、Terminal、SWE 及整体行动判断基准上的 Macro-F1。
二、判断与编辑,能否转化为实际任务收益?
任务评测覆盖 BrowseComp、DeepSearchQA、Terminal-Bench 2.0、Doc2Repo、NL2Repo 和 SWE-Bench Pro 六项基准。
对照方法包括 ReAct,以及分别从三个候选决策、三条候选轨迹中进行选择的两种 Best@3 方法。
在六项基准与三个 Agent 基座组成的 18 组对比中,EditAct 均优于上述基线。
对于 Qwen3.5-4B、Qwen3.5-9B 和 Qwen3.5-35B-A3B,EditAct 的六项平均得分分别达到 41.8、44.1 和 48.8,较各自最强基线提高 6.7、5.2 和 3.2 个百分点。

图:三个 Agent 基座的完整对比结果。各基准采用其对应指标,Avg. 为六项基准得分的平均值。
这意味着,在论文的实验设置中,收益不仅出现在某一个任务上,也覆盖了不同模型规模和不同交互环境。
三、效果是否只是来自“多生成一次”?
研究团队进一步比较了随机触发修订、让 Agent 重新生成、提供 AEWM 提示,以及只修改推理或只修改行动等设置。
以 Qwen3.5-35B-A3B 在 Terminal-Bench 2.0 上的结果为例,重新生成与提供提示分别取得 40.4% 和 39.3%,完整 EditAct 则达到 48.3%。
图:干预方式、模型替换与训练阶段的消融实验。
这些对照表明,收益不只是多给 Agent 一次生成机会。何时介入,以及如何联合修订推理与行动,都是重要因素。
四、撤掉 AEWM,Agent 还能保留这些能力吗?
研究团队进一步提出 AEWM-RFT:收集经过质量筛选、由真实反馈支持的 EditAct 轨迹,通过拒绝采样微调,让 Agent 学习其中的纠偏和后续推进模式。
对照组 Self-RFT 使用 Agent 自己生成的轨迹。两者保持任务、轨迹数量、筛选策略和微调配置一致,只改变轨迹的生成方式。
评测时,两者都不再调用 AEWM。
结果显示,AEWM-RFT 在 BrowseComp、Terminal-Bench 2.0 和 Doc2Repo 上分别比 Self-RFT 提高 2.2、2.6 和 2.5 个百分点。
图:原始 Agent、Self-RFT 与 AEWM-RFT 的对比,所有模型均在没有在线 AEWM 指导的条件下评测。
这说明,经过修订的交互轨迹,不只是一次性的外部帮助,也能成为 Agent 后续学习的训练监督。
05 总结:真实反馈之外,还
需要更好的下一步
对于长程 Agent,能调用工具、获得真实反馈,只是可靠完成任务的一部分。
更关键的是,它能否持续分清:哪些是已经验证的事实,哪些仍然只是猜测;哪些问题已经解决,哪些要求还没有满足。
AEWM 的尝试,是把世界模型的关注点从复刻环境返回,转向预测决策作用,再通过执行前编辑,减少错误理解对后续任务的持续影响。
从“预测工具返回什么”,到“判断当前决策是否有用”,再到“直接修订下一步并从中学习”,AEWM 探索了一条面向长程 Agent 的世界模型路径。
它的目标不是让 Agent 一味多做,也不是让 Agent 一律少做,而是让每一步更有依据。
让真实环境提供事实,让世界模型帮助 Agent 基于事实,走出更好的下一步。