AI训练时代,GPU为王;AI推理和智能体时代,CPU重回C位。这已经成为行业共识,无论是x86阵营的Intel、AMD,还是Arm阵营的一众厂商,都在努力把握空前的新机遇。
根据Arm官方报告,Arm架构芯片的全球出货量累计已 超350亿颗,覆盖从手机到数据中心全场景。
在很多人的刻板印象中,x86性能出色,却功耗偏高,Arm能效无敌,却性能不足。
但是,时代在进步,x86的能效也可以做的非常好,Arm的性能也是越来越出色,尤其是在智能体AI时代的数据中心领域,Arm CPU更是称得上如鱼得水、势如破竹。

Arm不但对客户提供丰富的IP授权, 今年还亲自下场,打造了专为智能体而生的AGI数据中心CPU。
它号称是全球能效最高的智能体CPU,拥有高性能、高能效、高扩展性三大核心优势。
当然,Arm自己做AGI CPU,并非意在和阿里、Ampere、AWS、谷歌、微软、NVIDIA等自研Arm架构芯片的客户争抢市场,而是为市场提供另一种新的选择,尤其是满足那些希望在数据中心快速部署Arm CPU、又没有自研能力的客户。
根据IDC统计报告, 2026年第一季度,在全球搭载GPU/AI加速器的AI服务器市场上,Arm 架构的总市场价值已经超过x86架构。
如今随着CPU在智能体时代回归C位,如何最大程度地发挥它的性能、能效实力,如何针对性地高效满足不同场景和任务的需求,是所有CPU厂商共同需要思考的问题。
现在,Arm给出了一份自己的答卷,通过一套全新的测试方法论,衡量从单颗芯片到整个机柜的智能体应用表现。

Arm云AI解决方案架构总监Ravi Malhotra指出,之前衡量AI性能的唯一指标就是Token,包括每一秒、每一瓦、每一元的单位Token数量,而智能体AI的出现改变了一切, 要求生成的Token能够在真实场景中得到切实的应用,因此对于CPU性能的衡量,也需要重新思考。
智能体AI正不断涌现,类型也极为丰富,包括软件开发、企业自动化、科学研究、个人助理、机器人等。
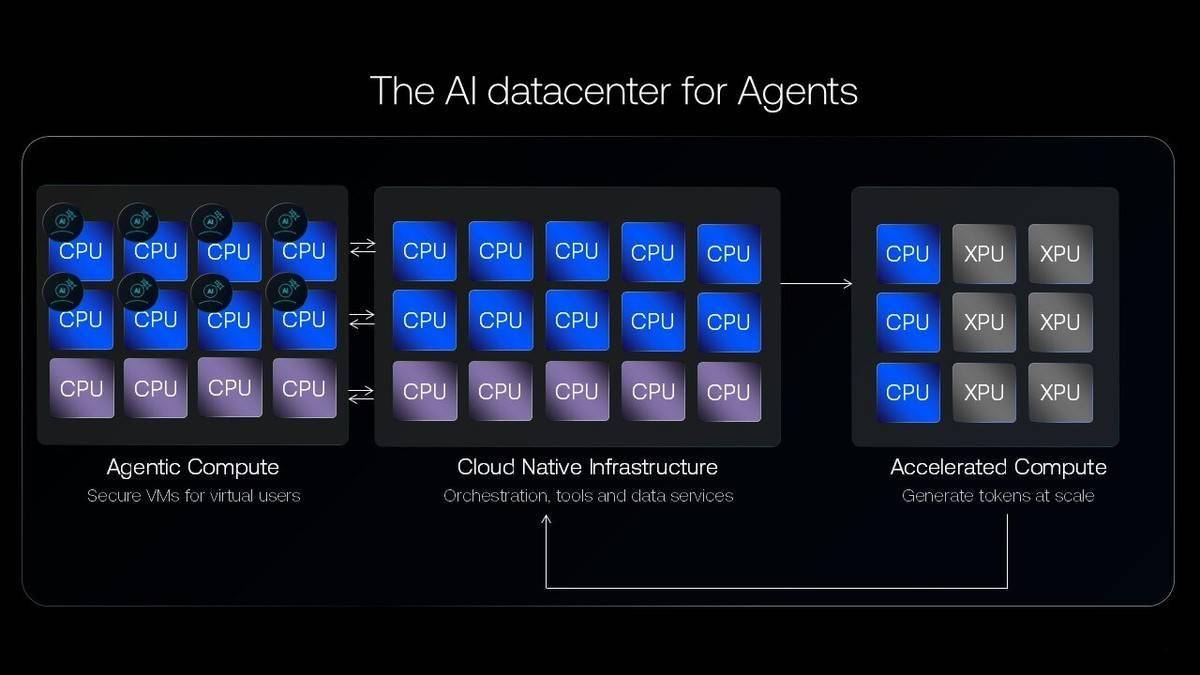
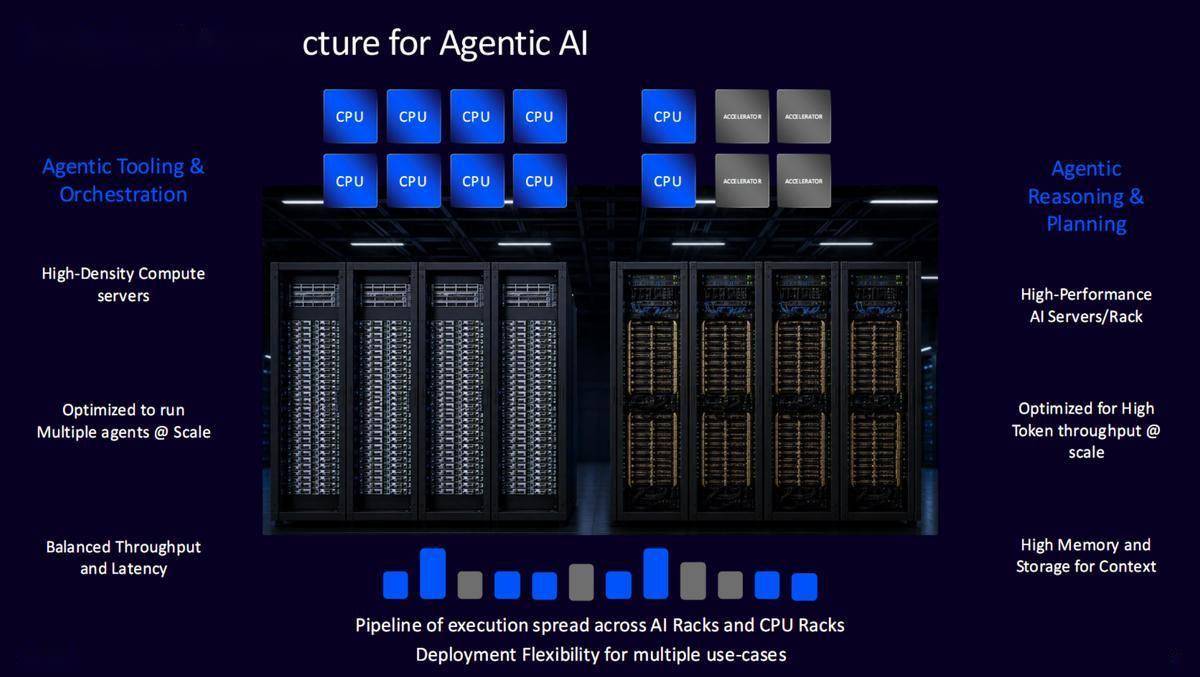
整体来看,智能体任务可以分为两部分。
一是Token生成,即推理与规划,通常运行在AI机架上。
这部分的重点是大规模生成Token,并为智能体所需的上下文和数据解读,提供足够的内存与存储空间。
二是基于生成的Token采取下一步行动,即任务编排与工具调用,通常运行在纯CPU服务器上。
这部分需要高密度的计算服务器,并针对多智能体的规模化部署运营而优化,平衡吞吐与延迟。
但是,不同的智能体是截然不同的,有的耗时较长、负载较重,单个的性能非常重要,有的持续时间较短或操作较少,对吞吐量和运行效率要求更高。
因此,围绕智能体性能的基准测试不断涌现,既有行业厂商联合推出的,也有学术机构贡献的,其中最具代表性的是斯坦福大学的Terminal-Bench。
Arm近日也专门发布白皮书,提出了一种新的智能体AI性能评估思路,主要包括两个部分。
一是从组件角度出发的基准测试,同时考察CPU的不同方面,因为如前所述,不同智能体对CPU的需求是截然不同的。
其中,工具调用类组件侧重于IPC(每周期指令数)、I/O和并发,任务编排组件更强调CPU并发和利用率,而在推理与规划组件重点是CPU单线程性能,包括分支预测、缓存、内存延迟和内存带宽。
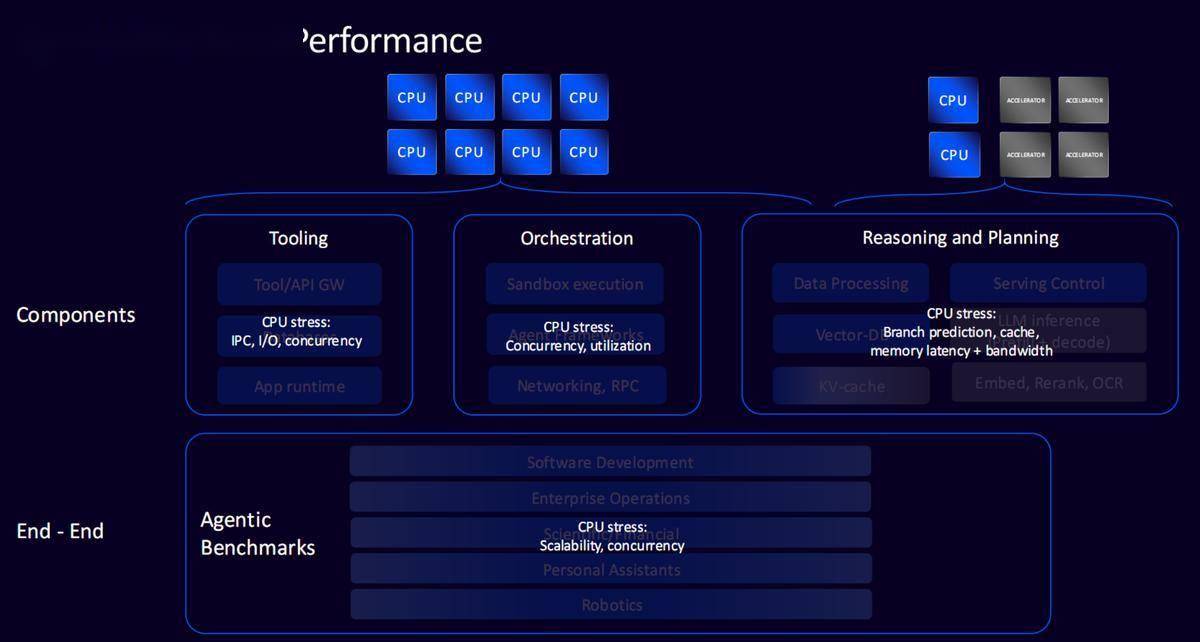
二是端到端智能体的基准测试,更关注可扩展性和并发性。
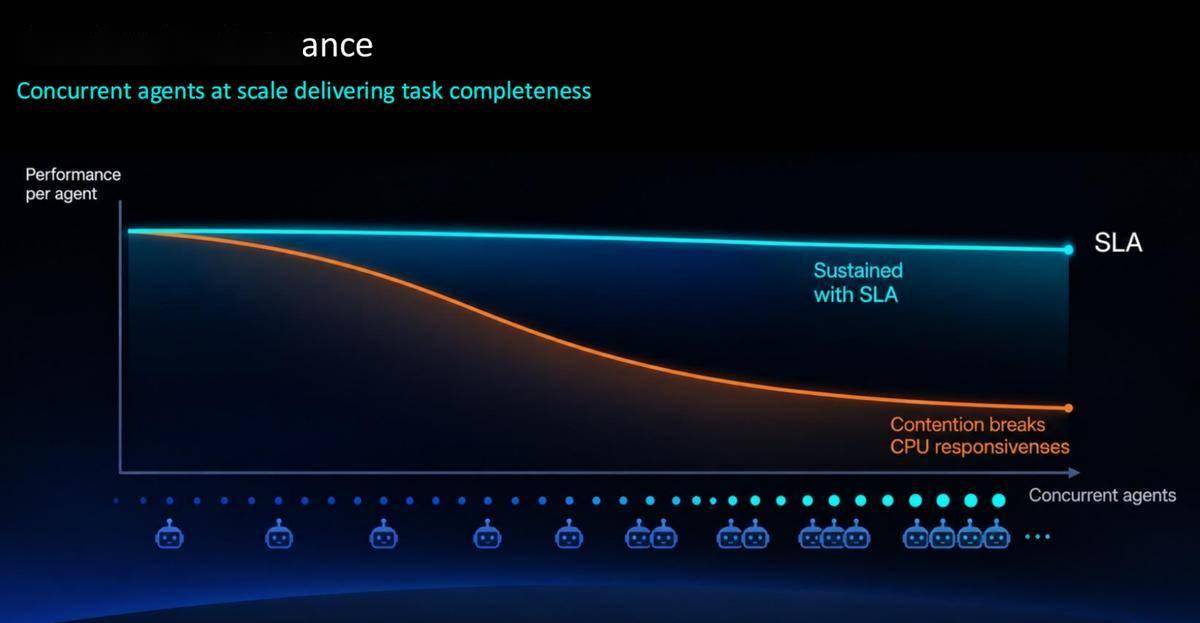
这部分不只看单颗CPU能够承载多少智能体,也不能单纯追求最高吞吐量,还需要在吞吐量与SLA(服务等级协议)要求之间取得平衡,也就是持续性能。
除了CPU芯片层面的性能,Arm也十分关注机架层面交付的性能,因为并非所有CPU都是一样的。Arm CPU更注重在性能、规模和效率之间的平衡。
Ravi Malhotra特别指出, Arm提出的是一套评测方法论,而非单一的基准测试,也不是正式的行业标准,旨在为业界提供一个切实可行的起点,以评估智能体AI持续发展过程中,对CPU的性能需求。
它不只是关注各个组件,也不只是关注如何以批量或最快的方式生成Token,更关注这些组件如何以高效的方式组合在一起,并实现智能体AI的运行,这正是Arm希望行业关注的重点。
鉴于智能体AI和基准测试方法的发展速度非常快,Arm也持续完善这套测试方法,包括覆盖更丰富的用例场景和任务,以及更加准确地模拟实际应用。
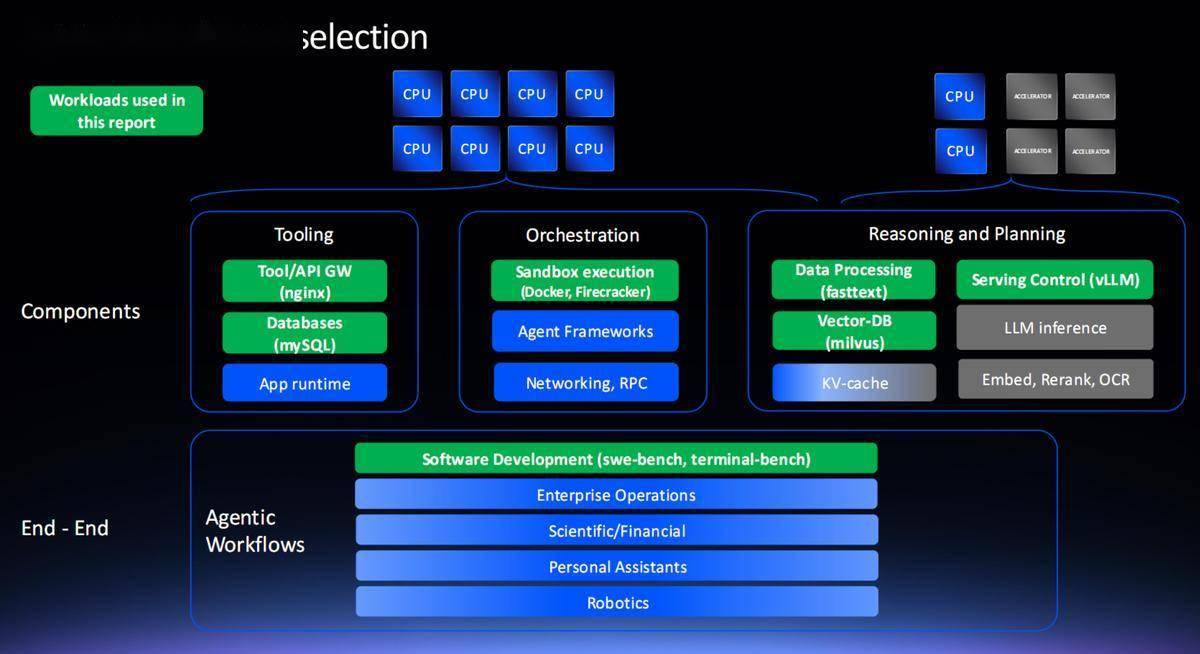
沿用前面提出的模型,Arm从每个类别中选取了具有代表性的工作负载进行考察。
工具调用方面,选择了用于Web服务器的nginx、用于数据库的MySQL。
推理与规划方面,选择了向量数据库Milvus,以及广泛使用的模型服务框架vLLM,还有fastText作为数据处理基准。
编排方面,主要考察沙箱执行开销,测试选择了Docker、Firecracker、gVisor等多种沙箱技术,评估每个智能体在沙箱环境中运行所付出的额外性能成本。
智能体基准方面,选择了最热门的应用类别之一软件开发,并选用SWE-bench、Terminal-Bench作为软件开发工作流的代表性参照。
Ravi Malhotra强调, 这些用例的选择,是基于最高的使用量级、活跃程度而定的,但不建议对这些用例分配任何权重比例,因为每个智能体、每个用户的任务需求都各不相同,因此推荐基于个人实际情况来评估相应的CPU性能。
测试方法有了,结果如何呢?
Arm与独立技术分析机构Signal65合作,后者发布了一份独立报告,对比了Arm AGI与第五代AMD EPYC 9755在智能体工作负载上的性能。
芯硬件注:
Arm AGI采用台积电3nm工艺,最多 136核心(还有128/64核心),集成272MB二级缓存、128MB三级缓存,主频最高 3.2GHz,支持12通道DDR5-8800内存、96条PCIe 6.0和4条PCIe 4.0通道、CXL 3.0 Type 3,最大功耗 300W。
AMD EPYC 9755基于台积电4/6nm工艺, 128核心256线程,集成128MB二级缓存、512MB三级缓存,主频最高 4.1GHz,支持12通道DDR5-6400内存、128条PCIe 5.0通道,最大功耗 500W。
在它之上还有更高端的型号,比如 旗舰级的EPYC 9965可提供192核心256线程、192MB二级缓存、384MB三级缓存、3.7GHz加速频率,最大功耗也是500W,但是Arm没有和它进行对比。
报告显示, 对于评估的智能体工作负载,在相同功耗预算下,Arm AGI的每机架性能,大约是AMD EPYC 9755的多达1.99 倍。
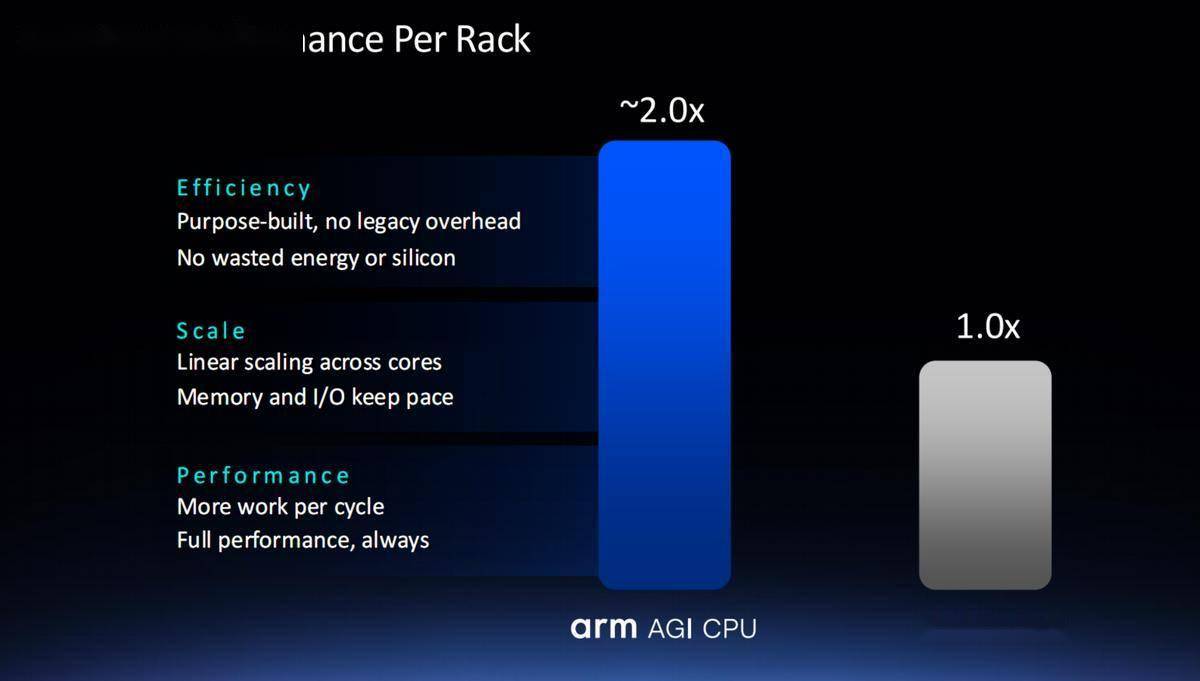
由于每个工作负载或组件都不相同,除了看整体性能,还需要分类对比。
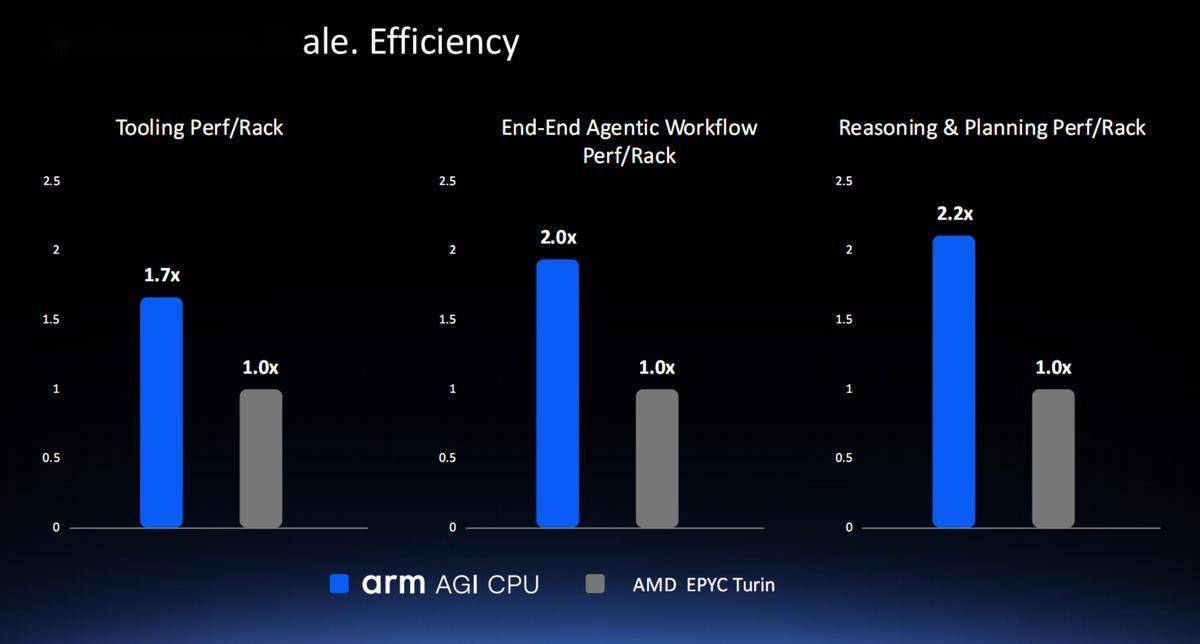
比如工具调用,Arm AGI的每机架性能达到AMD EPYC 9755的大约 1.7倍。
在向量数据库、缓存等推理与规划类应用上,Arm AGI的机架性能可高达AMD平台的约 2.2 倍。
如果单看端到端智能体的基准测试,Arm AGI机架性能可以达到AMD的大约 2倍。
Arm AGI对比AMD EPYC 9755,优势是核心数量更多、二级缓存容量更大、内存频率更高、支持更新的PCIe 6.0,劣势是线程数量更少、三级缓存容量更小、频率更低、功耗更低,取得如此之大的优势,确实不易。
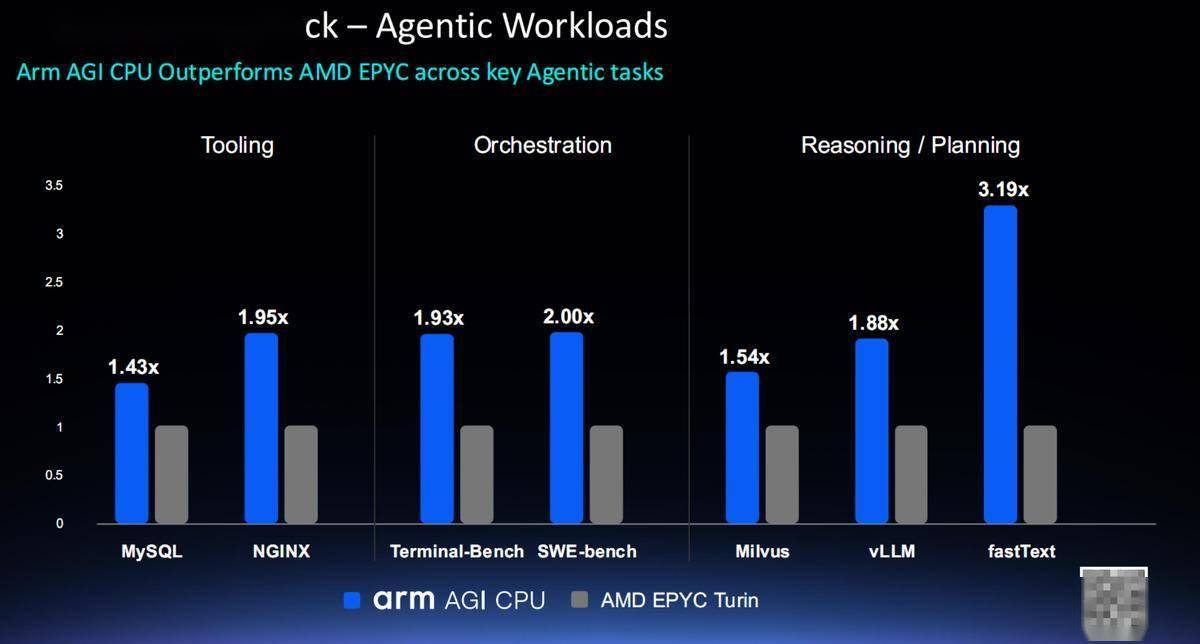
再看各项基准测试组件的单独结果,一如预期,结果各不相同。
不过 在所有工作负载上,Arm AGI的机架级性能都大幅领先AMD EPYC 9755,优势最小的MySQL也有1.43倍,优势最大的fastText更是多达3.19倍。
平均下来,就是前文提到的1.99倍。
Signal65的报告还指出, Arm AGI在单核心、整体层面的性能,平均而言都要比AMD平台高出约20%。
另外,效率和可扩展性也是Arm AGI CPU的优势,毕竟单个核心的功耗更低,在相同的机架功耗预算下,可以部署更多核心。
综合单核心、单颗CPU的性能与每机架的更多核心数量,综合而言,Arm AGI CPU就拥有了约2倍的机架级性能优势。
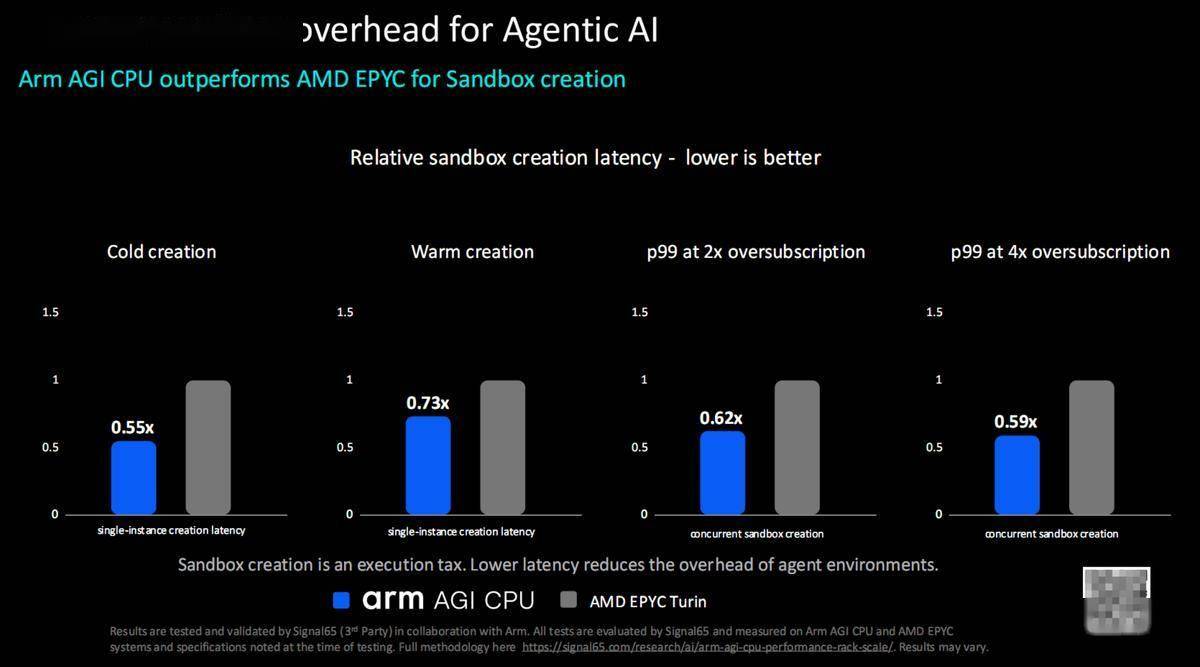
最后是沙箱开销(sandbox overhead)。
智能体AI里,大模型在GPU生成代码、指令之后,要放到独立、隔离的沙箱里执行,由此带来的额外CPU侧成本,统称沙箱开销,打个比方就是智能体的“执行税”,这也是Arm AGI CPU重点优化的负载。
通过对单示例冷/热创建、2/4倍过载并发p99等多个场景的测试, Arm AGI的沙箱开销成本远低于AMD EPYC 9755,只需对方的55%-73%。
目前,Arm AGI CPU正在以多种产品形态推向市场。
Arm自己设计了两套参考服务器方案,一个是1OU双节点,一个是2U双路。
超微、联想、华擎等合作伙伴发布了一系列商用服务器产品,具有不同的尺寸和配置(2U、5U、2OU等),面向不同的场景和用例。
在机架层面,Arm提供了一套1U双节点风冷参考设计,超微则打造了两套液冷方案,包括19英寸、OpenRack双宽两种规格。

随着智能体AI的兴起和普及,CPU重新回到聚光灯下,再次成为绝对的主角。
无论对于x86阵营还是Arm阵营,都是一个绝佳的新机会。
但是,CPU如何满足复杂多样智能体的运行需求,如何衡量自己的性能和能效,如何为不同负载和场景进行针对性的优化,值得所有CPU厂商深入探究。
Arm在尝试给出自己的答案,当然不是要制定一套放之四海皆准的行业标准,自然也需要突出宣传自家的优势,但确实开了个好头,值得学习和借鉴。
CPU的创新之路,还很长,很长。