智猩猩AI整理
编辑:六六
今年9月,宾夕法尼亚州立大学( Penn State )博士徐思渊入职香港中文大学(深圳)人工智能学院,担任助理教授。

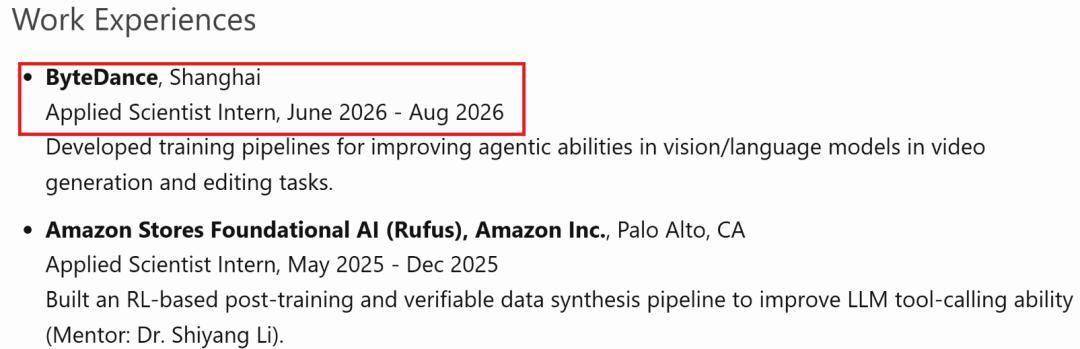
徐思渊本科毕业于西安交通大学电气工程及其自动化专业,2026年获宾夕法尼亚州立大学电气工程与计算机科学博士学位,师从Minghui Zhu教授。读博期间,他曾在亚马逊Rufus团队实习,开发基于强化学习的后训练与可验证数据合成流程,提升大语言模型调用工具的能力 。
在入职港中深之前,他还在 字节跳动担任应用科学家实习生,参与视觉语言模型在视频生成与编辑任务中的智能体能力训练。
徐思渊的研究 首先关注的是强化学习中的一些基础问题:当智能体面对新的任务时,能否利用已有经验快速适应?如果学习过程还受到安全约束,又该如何兼顾效率与可靠性?
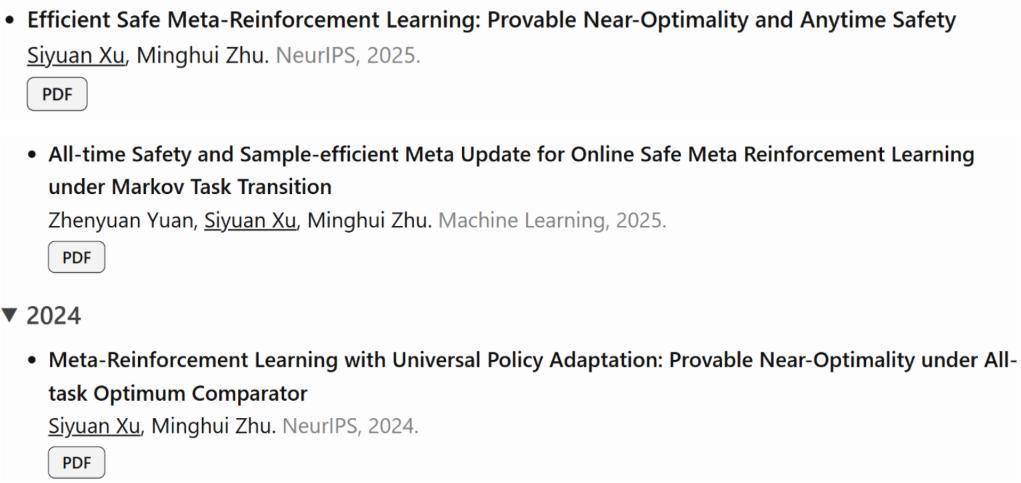
2023年,他围绕在线约束元学习展开研究,相关论文入选NeurIPS并获 Spotlight(Top 3.6%);另一项关于约束双层优化中的高效梯度近似方法的工作入选2023 AAAI Oral。
此后,他继续研究安全元强化学习,探索智能体如何在有限数据下适应新任务,同时满足过程中的安全要求。
这些工作背后有一个共同问题:智能体不仅要学会完成任务,还要知道怎样更有效地学习,以及如何在变化的环境中保持可靠。
随着大语言模型的发展,徐思渊的研究进一步延伸到大模型后训练与对齐。
相比预训练阶段从海量数据中学习语言规律,后训练更直接地涉及如何利用偏好、奖励和交互反馈调整模型行为。他参与的研究包括基于人类反馈的可解释强化学习、群体偏好奖励,以及迭代偏好优化等方向。
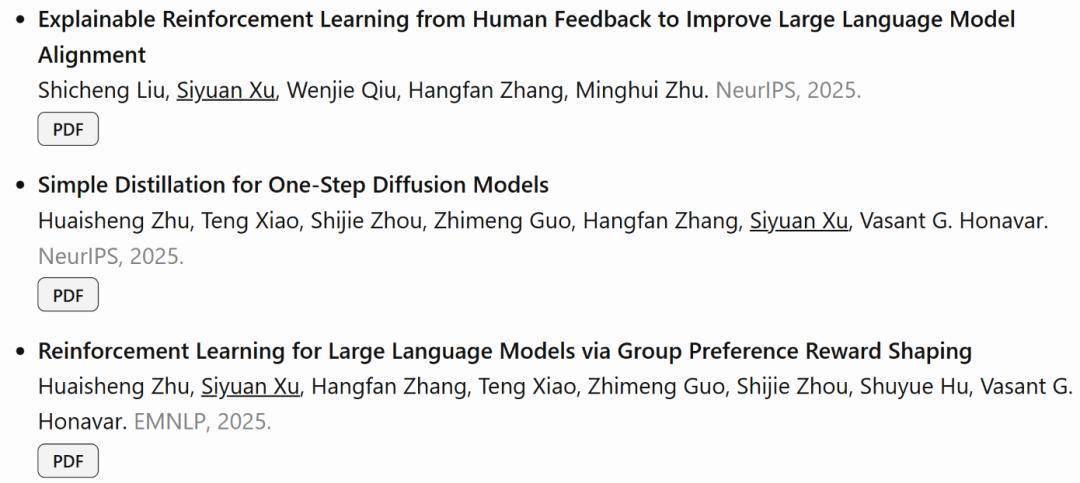
其中发表在2026 TMLR的相关工作,研究的是如何通过近端策略正则化开展迭代偏好优化,聚焦大语言模型对齐中的优化问题。这与他此前的强化学习研究形成了自然衔接:无论面对传统智能体还是大语言模型,如何设计学习机制、利用反馈改善策略,都是重要的研究问题。
总体来看,徐思渊的研究从策略优化、任务适应等强化学习理论出发,延伸至大模型后训练与智能体能力提升,连接基础方法与AI应用。
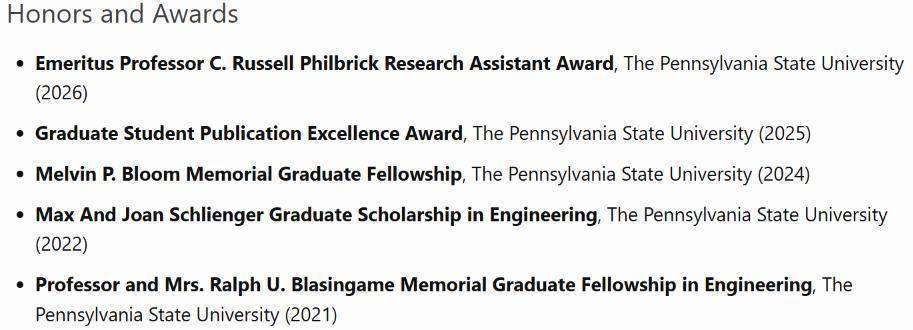
上述研究也让他获得了宾夕法尼亚州立大学多项荣誉与奖励,包括2025年研究生论文发表优秀奖和2026年以荣休教授 C. Russell Philbrick 冠名的优秀研究助理奖。
如果说博士阶段解决的是"智能体怎样学会学习",那么加入港中深后,徐思渊要回答的下一个问题是"智能体怎样持续变强"。
围绕这个问题,他的研究方向聚焦在强化学习理论与算法设计、面向大模型训练的强化学习、AI 智能体与自我提升 AI,以及具身智能与机器人学习。