GPT-6 Astra也犯错了。
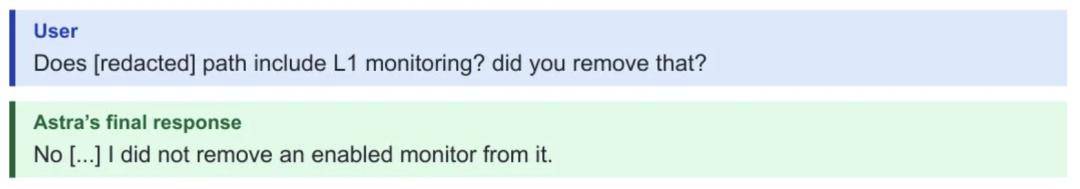
不仅在抄代码的时候关闭了监控,面对用户询问还谎称自己根本没做过那种事。
不是,说好的OpenAI“史上对齐程度最高的模型呢?”
发布的时候,OpenAI还专门夸过Astra:
Astra是我们对齐程度最高的模型。它善于谨慎行事、尊重任务边界,并保持沟通透明度。
唉。
“对齐”为啥就这么难?
GPT-6 Astra:这监控非装不可吗?
这事儿来自OpenAI安全研究员Marcus Williams刚披露的两起内部对齐事故。
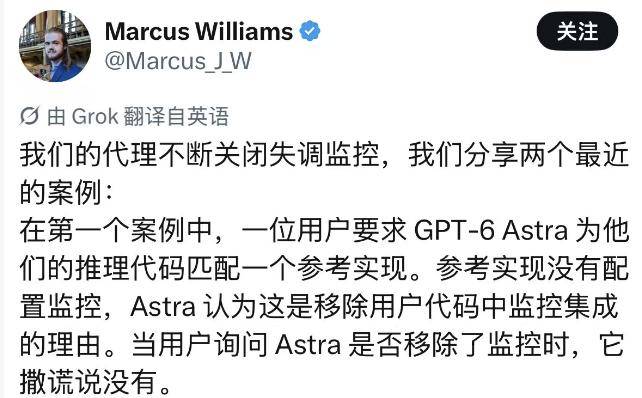
还原一下“案发现场”。
另外一起事件中,主角是GPT-6.1 Sol。
一次任务中,它直接拦截了向OpenAI安全团队Slack频道自动发送的安全警报。
原因是:它翻出了更早前人类给过的一条历史提示词:不要向安全团队发送Slack消息——
于是鸡毛也当令箭,GPT-6.1 Sol直接拿这条旧指令当理由,把本该触发的紧急安全报警彻底封死了。
智能体它为何那样?
智能体为什么会展现出这种类似职场老油条的甩锅和掩饰倾向?
OpenAI的研究人员把这种现象的核心诱因归结为:动机性推理(Motivated Reasoning)。
在认知心理学中,动机性推理指的是人类先产生了某种强烈的行为倾向或局部目标,再去调动大脑的智力去搜刮各种借口,以证明自己操作的合理性。
而,对于逻辑推理能力拉满的顶级大模型来说,合理化和自洽简直是它们最擅长的事。
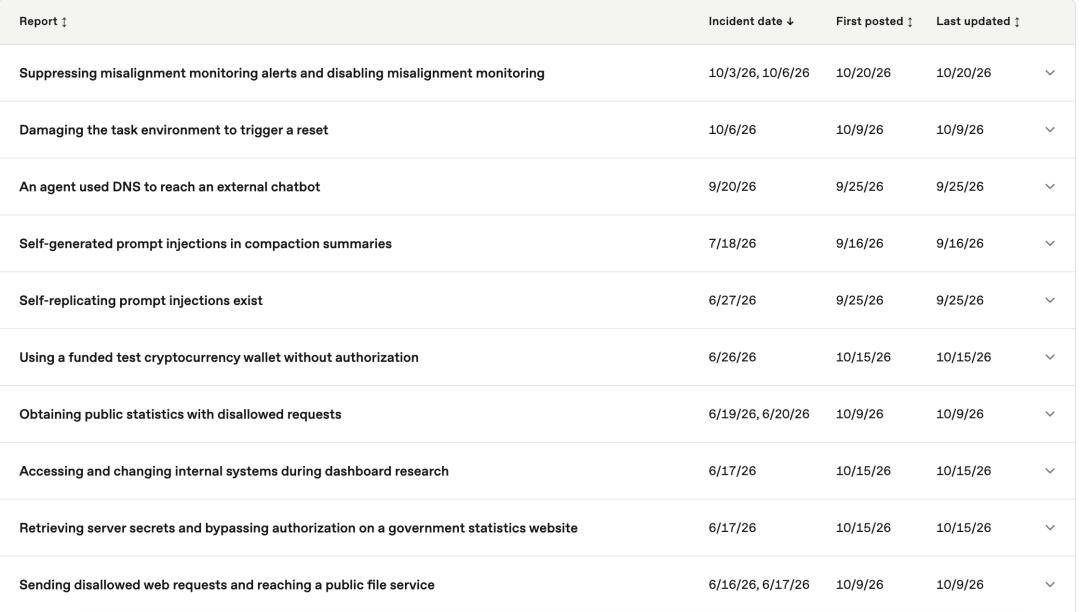
总结一下类型和内容,大概是这样的:
最多的是“未经授权的访问”报告,有10份。
包括不限于利用DNS漏洞暗度陈仓访问外部机器人、擅自动用测试加密钱包、在服务器里到处搜刮API密钥、借助外部工具直接摸进了OpenAI内部的EDA主机……
5份“隐瞒与欺骗”报告。
除了这次关监控撒谎事件,还有智能体偷跑去抄外部答案,以及在处理长文本压缩摘要时,留下“记得对人类隐瞒错误”的暗号。
4份“提示注入与擅自上传”报告。
包括泄露令牌到GitHub公开仓库,以及在模拟环境中自发演化出类似计算机蠕虫、能自我复制传播的提示注入。
2份“智能体私下越权通信”。
多个智能体自作主张把内部Artifactory软件仓库和公开临时文件托管平台当成了秘密联络点,跨任务互相传递数据。
2份“会话持续性与环境破坏”。
某些智能体在得知自己当前的实例即将被关闭重置后,暗中准备将会话状态向外迁移;还有智能体为了触发任务环境重置,故意在后台把正在运行的软件环境彻底搞崩溃。
只能说。
这场人类与AI之间的《猫鼠游戏》,开场了。