一个现象值得记下来:业务系统登录不进去,查程序正常、查数据库正常、查账号密码也正常,最后出问题的地方,是一台没人用过的邮件服务。
这类故障的共同点很一致——所有表面证据都指向应用,真凶却在系统层一个不起眼的角落。它不常发生,但一旦发生,排查方向错一次就要多花一小时。
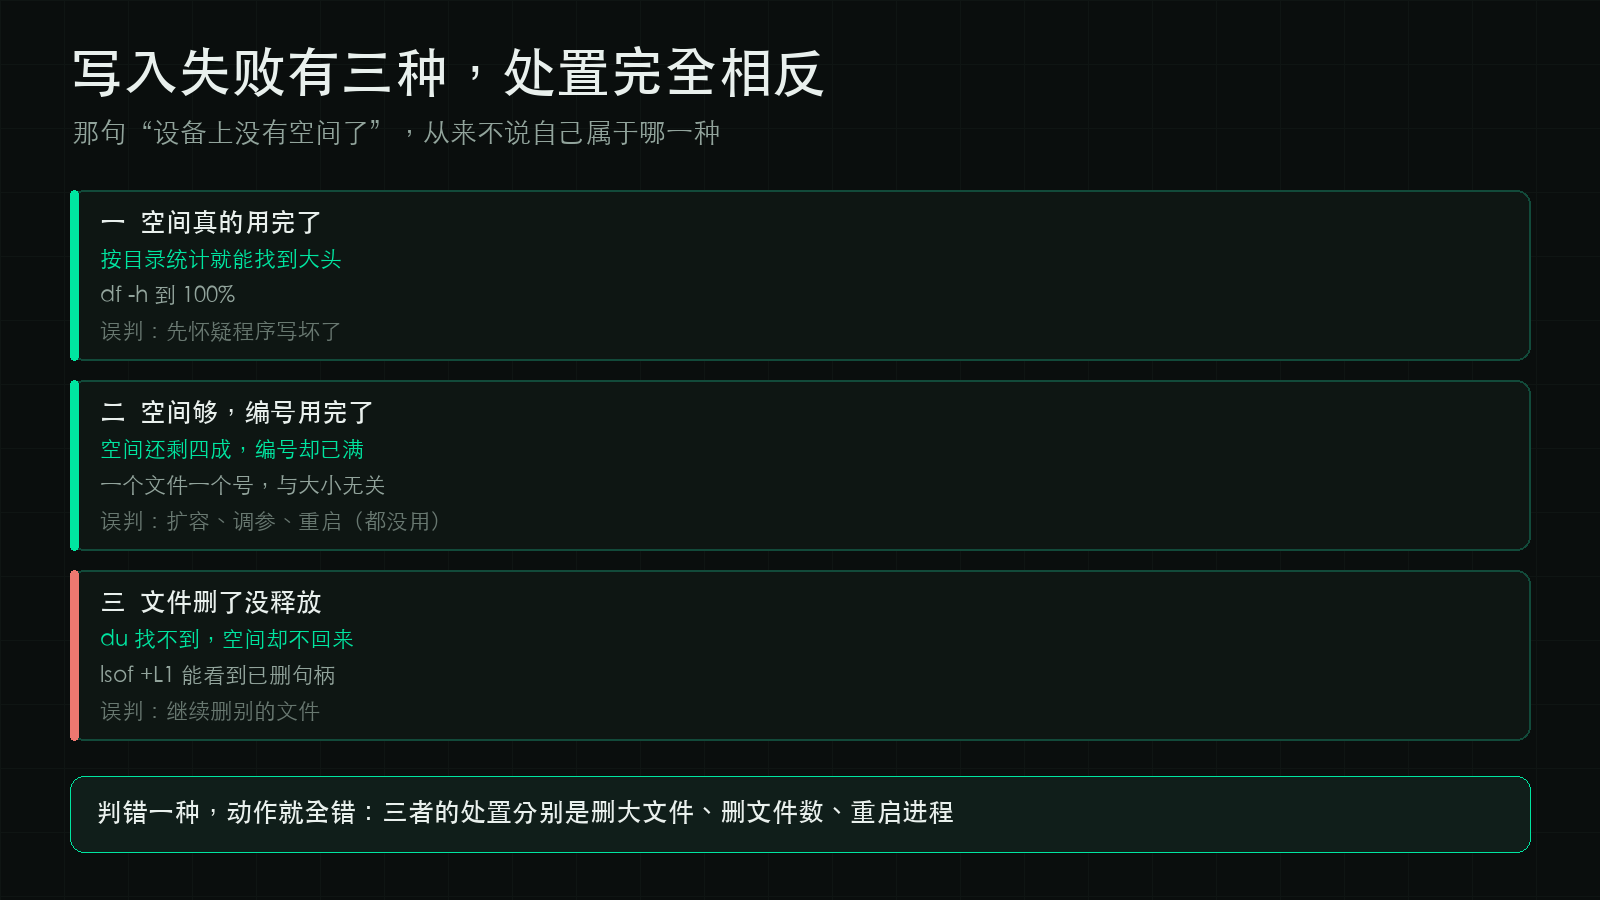
一、"设备上没有空间了"这句话,其实什么都没说
先说那句最容易误导人的报错:设备上没有空间了。
它出现在你新建文件、写日志、存数据的时候,语气笃定,看起来像是磁盘满了。但这句话本身不区分原因——它只表示"这次写入没成功,因为系统拿不到资源"。
在 Linux 上,写入失败至少有三种完全不同的原因:
第一,磁盘空间真的用完了,这是最直觉的一种。
第二,磁盘空间还有,但文件系统能分配的"文件编号"用完了。这个编号在格式化的时候定死数量,一个文件占一个,跟文件大小无关——一个 10G 的视频占一个,一个空文件也占一个。
第三,文件已经被删掉了,但还有进程持有它的句柄,空间要等进程退出才释放。这种情况用常规的目录统计找不到,看起来空间莫名其妙地消失了。
三种情况的处置方式完全相反:第一种删大文件,第二种删文件数量,第三种重启对应进程。判断错一种,动作就全错。
二、判断只需要两条命令
区别这三种,不需要专业工具,两条命令就可以把范围切开。
第一条看空间,第二条看文件编号的使用率。两条一起看,结论基本唯一。
有一家做五金件的厂,技术负责人最初的判断是磁盘满了——因为报错就是这么写的。他去看空间,发现还剩四成,于是判断"不是空间问题",转而怀疑程序有 bug,重启了几次服务。
真正让他回头的是一个说不通的矛盾:空间足够,却建不出一个空文件。
带着这个疑问去看了文件编号的使用率,才发现六百多万个编号一个不剩,全部用完了。而同一时刻,空间显示还有一大半空着。
两个数同时存在,一个百分之四十,一个百分之百。这就是这类故障的典型现场。
三、编号被谁用光了
接下来的问题就具体了:是谁在这台机器上制造了如此数量的文件。
按目录统计文件数量,从多到少排序,结果一边倒:某个系统目录下堆了六十多万个,第二名连它的尾数都不够。
那是邮件服务的队列目录。
出事的机器承担厂里的日常业务,进出货与工单两套都跑在上面。
它为什么能把编号用光?三个机制叠在一起:
邮件队列的规则是"一封邮件一个文件"。发不出去的邮件不会消失,会留在队列里等下次重试,每留一封占一个编号。
重试的时间间隔逐次拉长,可单封邮件仍能在队列中滞留数日。
最关键的是,系统在发送失败时会生成一封退信通知发信人,而这封退信本身如果也发不出去,它又留在队列里,下次失败再生成新的通知。
于是队列只进不出。每天新增的比成功投递的多,一天多几千封,几个月下来就是六十多万。
这个过程的隐蔽性在于它没有任何外部表现:处理器正常、内存正常、磁盘空间正常,没有报警,也没有日志异常。唯一的动静是编号数量在缓慢减少,而这个数字绝大多数监控系统根本不采集。
四、为什么最先出问题的是登录
这两件事表面上看毫无关联:一个在后台收发,一个在前台校验身份。
但它们都要落到同一块盘上:登录成功这个结果,也得先写成一个文件才算数。
密码校验通过的那一刻,系统需要在磁盘上留一条记录,说明"此人已登录"。之后每次请求,系统靠这条记录认人。
编号用完了,这条记录写不进去——密码是对的,系统也认了,但"已登录"这个状态存不下来,下一次请求仍然把你当成未登录的陌生人,于是送回登录页。
用户看到的就是"输对密码也进不去"。
业务日志面临同样的处境。
系统连自己的错误都留不下记录,它反馈的状态自然不能全信。
五、处置的思路:先让系统能写,再断根
处置分两层,顺序不能颠倒。
第一层是恢复可用。编号用完了只能减少文件数量,没有别的办法。但删除这个动作本身有讲究:
不能整个目录删掉——队列目录的结构、属主和权限由邮件服务自己维护,删掉整棵树,服务重启之后容易出异常。
不能一次删几十万个——大批量删除会把磁盘读写压满,一台本来就状态不佳的机器很容易直接卡住。
可行的做法是先记录现场,再按时间分批清理:只删两天之前的,刚进入队列还在重试的不动;每批两千个左右,删一批停一下;脚本带一个"只看不删"的开关,先跑一遍核对目录和数量,确认无误再执行。
删除进行到中途,登录功能就恢复了。
把队列清空,只是让占用暂时降下来;只要服务还在运行,新的退信照旧产生。
只要投递通道畅通,队列自然会被消化;反过来说,堆积的存在就证明投递环节不通。
六、这类事为什么反复发生
从处理过的案例看,原因集中在三处,而且都很基础。
两者没有对应关系:空间九成、编号仅百分之五的盘可以继续用;空间三成、编号九成五的盘随时可能停摆。
第二处是装机时没人做减法。服务器装系统时默认会带上一批服务,装的时候没人觉得有问题——它们不占处理器、不占端口、看起来安静。但它们都有自己的默认行为:写日志、存缓存、排队、重试。这些行为在无人看管的情况下会持续累积。
定位到具体目录之后,往往还要额外确认这个服务由谁安装、是否仍在使用。
三处之中,第一处最容易补,收益也最直接。
七、一个可以马上用的判断标准
判断一个服务该不该长期留在服务器上,标准其实很简单:如果它今天挂掉,业务会不会受影响。
答不上来的,去查它最近的日志与队列记录,用实际痕迹替代凭印象判断。
这条标准不需要技术背景,管理者也可以直接问技术负责人。它比"这个服务重不重要"这种问法有效得多,因为后者往往得到一个"应该重要吧"的回答。
判断服务是否该留下,很多时候不需要复杂评估:让它停下来试试,看有没有人立刻来反馈。没有人反馈,说明它此前只是占着位置。
摩杰斯在现场遇到同类故障,习惯先让人建一个空文件——建不出来,就说明问题出在操作系统层,与业务代码无关。这个动作花不了十秒,往往能省掉一小时的错误方向。
服务器很少突然坏掉,它只是有一些数字长期没人看。把这些数字挂到看板上——剩余空间、文件编号、连接数、队列长度、证书到期时间——成本很低,能省下的却是整晚的排查时间和一次业务中断。