传统的多人录音转写要走三道工序:语音识别负责出文字,说话人分离负责判断每段声音属于谁,时间对齐负责标出每句话的起止时间。三个模块各自训练、依次处理,前一道工序的错误会一路传到后面。录音一长,还得先切成小段,拼接处容易出现断句、说话人编号错乱和时间错位。
模思智能与 OpenMOSS 推出的 MOSS-Transcribe-Diarize(MOSS 多说话人语音转录模型)换了一种做法:用“音频编码器 + 因果解码器”的端到端架构,把“谁、在什么时候、说了什么”当作一段结构化文字一次生成。支撑这套做法的有三项关键设计:统一的生成目标、写成文本的时间戳,以及 128K token 的长上下文。
下面以开源的 MOSS-Transcribe-Diarize 0.9B 为例拆解这套架构。这个版本在 2026 年 7 月 9 日以 Apache-2.0 许可开源,参数规模为 0.9B,约 90 分钟的录音可以整段输入。官方在多说话人会议测试集 AISHELL-4 上把它和 5 个第三方系统做了对比:在衡量说话人区分稳定性的指标 Δcp 上,0.9B 为 0.99,好于全部对比系统。
一、MOSS-Transcribe-Diarize 的整体架构
MOSS-Transcribe-Diarize 的主干由三部分串联而成:音频编码器把声音转成特征,适配器把特征转换成语言模型能读懂的表示,因果解码器(模型中的语言模型部分)再逐段写出结果。开源的 0.9B 采用 Whisper-Medium 配置的音频编码器和 Qwen3-0.6B 风格的因果解码器。

图注:MOSS-Transcribe-Diarize 模型架构:音频波形经音频编码器转为特征,再由自回归语音大模型逐段生成“开始时间、说话人编号、文本、结束时间”序列
图中,音频波形从左下角进入音频编码器(Audio Encoder),编码得到的特征送入上方标为 Autoregressive SpeechLLMs 的自回归语音大模型,即因果解码器。模型生成的三段结果分别属于 S01、S02、S03 三位说话人,每段前后各带一个时间戳。适配器位于编码器和语言模型之间,图中没有单独画出。火焰图标表示编码器和语言模型都参与训练。
从输入到输出,各环节的分工整理在表中:
二、从三段流水线到一次生成
在传统的级联方案里,识别模块只管文字,分离模块只管声音属于谁,对齐模块再把两边的结果按时间拼起来。三个模块各看各的,一旦说话人分错,文字识别得再准,也会被记到别人名下。
MOSS-Transcribe-Diarize 把训练目标从“这段音频说了什么”改成“在什么时间、由哪位说话人、说了什么”。转写、说话人归属和时间戳由同一个模型在同一次生成中给出,三者在生成过程中可以相互参照,不再需要单独的说话人分离模型和对齐步骤。
模型的输出是一段连续文本,由若干片段首尾相接组成,每个片段的格式是“[开始时间][说话人编号]文字[结束时间]”。官方仓库给出的示例是:
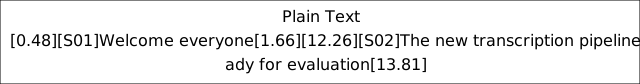
时间以秒为单位,[S01]、[S02] 是说话人编号。仓库里的 parse_transcript 函数能把这段文本解析成开始时间、结束时间、说话人和文字四个字段,方便写入数据库或生成字幕。
真实对话与模拟对话混合训练
要学会这种输出方式,模型需要大量带说话人和时间标注的多人对话。训练数据由两类组成:一类是从互联网收集的多语种真实对话,涵盖多种口音、声学环境和话题领域;另一类是按属性控制合成的模拟对话,专门补足真实数据里不够多的难例。
模拟对话每段从内部语料中选取 2 到 12 位说话人,把他们的语音按词切成连续片段,排在同一条时间轴上,并强制说话人交替发言。片段之间允许重叠,重叠部分最多占较短片段的 80%。为了让拼接处听起来自然,片段边界会对齐到能量较低的位置,并做 50 毫秒的交叉淡化,最后再叠加真实噪声和混响,信噪比控制在 0 到 15 dB。多人抢话、频繁插话和环境嘈杂这些容易出错的情况,就这样在训练中反复出现。
真实数据让模型熟悉人们自然说话的节奏,模拟数据则让它在难例上得到足够的练习。由于文字、说话人和时间是一起生成的,遇到两个人同时开口,模型能把重叠的发言分别记在各自的编号下,两段的起止时间允许交叉。
三、文本化时间戳:长录音里怎样保持时间准确
让模型输出时间戳,最直接的办法是让它根据音频特征在序列中的位置推算时间。这在短音频上可行,可一旦录音长到几十分钟,位置索引会变得稀疏,模型很难再准确判断某句话落在第几秒。
MOSS-Transcribe-Diarize 的做法是把格式化的时间戳文本插进音频编码器的各个分块之间。模型读到的不再只是一串声学特征,还有一个个明确写出的时间标记;输出时,它也用同样的文本格式写出时间。读和写用的是同一种表示,时间就成了模型可以直接参照的锚点。
这样处理后,即使是一小时以上的录音,段级时间戳依然准确,说话人归属也能保持稳定。时间直接写在输出文本里,每一段的起止时间都清楚可查,校对时可以按时间回听原音频。
四、128K 上下文:说话人编号贯穿整段录音
传统方案处理长录音,通常先切成几分钟一段,再逐段转写。切开之后,每一段都要重新判断有几个人、谁是谁:前一段里的 S02,到了下一段可能被编成 S03。拼接时还得再做一次说话人匹配,一旦配错,整段对话的归属就会乱掉。
MOSS-Transcribe-Diarize 的思路是不切片,把整段录音放进同一个上下文。开源的 0.9B 支持 128K token 的上下文长度,约 90 分钟的连续音频可以一次输入。模型从头到尾都能看到前面的对话,持续记住谁在说话、说了什么、什么时候说,以及下一位发言的是谁。同一位说话人在整段录音中始终使用同一个编号,也就不再需要事后匹配。
整段输入的效果,在长会议录音上体现得最明显:在官方的长音频评测中,0.9B 的说话人相关指标好于参与对比的全部第三方系统。
五、MOSS-Transcribe-Diarize 在长音频评测中的表现
前面的几项设计都指向同一个目标:在长时间、多人参与的对话里,文字、说话人和时间都要准。官方用两个长音频测试集检验这一点,录音都整段输入,不做切片。结果用三项指标衡量:CER 只看文字转得准不准;cpCER 还要求每句话归到正确的说话人名下;Δcp 是两者之差,代表说话人归属额外带来的错误。三项都是越低越好,其中 Δcp 最能直接反映说话人分得稳不稳。
AISHELL-4 会议集上的表现
AISHELL-4 是公开的真实会议室数据集,每条录音有 5 到 7 人参与,平均长约 38 分钟。
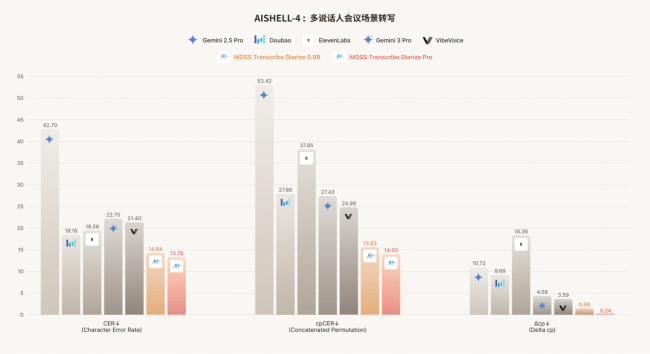
图注:约 38 分钟的会议录音整段转写:MOSS-Transcribe-Diarize 两个版本与 5 个第三方系统在 CER、cpCER、Δcp 上的成绩,柱子越短越好
图中三组柱子依次是 CER、cpCER 和 Δcp:灰色为参与对比的 5 个第三方系统,橙色为开源的 MOSS-Transcribe-Diarize 0.9B,红色为旗舰版 MOSS-Transcribe-Diarize Pro。三组里,两根 MOSS 柱子都短于所有对比系统。
差距主要拉开在和说话人有关的两项上。cpCER 上,0.9B 为 15.83%,对比系统中成绩第二的 VibeVoice ASR 为 24.99%,0.9B 领先 9.16 个百分点。Δcp 上,0.9B 为 0.99,VibeVoice ASR 为 3.59,另外 4 个商用系统在 4.68 到 18.36 之间。
Δcp 不到 1,说明在近 40 分钟、多人轮流发言的会议里,把说话人归属算进来后,错误几乎没有增加。这和整段输入的设计直接相关:模型不必在切片的接缝处重新判断谁是谁,也就少了把话记到别人名下的机会。
Podcast 访谈集上的表现
Podcast 是官方自建的多嘉宾访谈集,录音平均约 44 分钟,最长的约 61 分钟。下表把两个测试集上的 cpCER 和 Δcp 放在一起:
表注:表中数值为 cpCER 和 Δcp(%),越低越好。数据来自 MOSS-Transcribe-Diarize 官方评测,表中只列出在两个测试集上都有成绩的模型。
Podcast 上,MOSS-Transcribe-Diarize 0.9B 的 cpCER 为 7.37%,领先成绩第二的 Gemini 2.5 Pro 2.86 个百分点;Δcp 为 1.40,其余模型在 2.61 到 20.36 之间。
会议和访谈在人数、时长和说话方式上各不相同,0.9B 在两个测试集上的 cpCER 和 Δcp 都排在表中首位,说明长上下文的端到端建模能在不同类型的长时间对话中保持说话人一致。
六、从架构看 MOSS-Transcribe-Diarize 的使用要点
端到端的生成方式省掉了拼接流水线,也带来几处和传统方案不同的使用习惯。生成长度、显存占用、提示词写法、说话人编号的处理和服务部署方式,都和这套架构直接相关。
按录音时长留足生成长度
在这套架构里,文字、时间戳和说话人编号都要由解码器逐个 token 写出来,录音越长,输出也越长。生成上限 max_new_tokens 设得太小,模型写到一半就会停下,表现为后半段录音没有转写结果,或者某些说话人在后面“消失”了。
官方 Python 示例默认的 max_new_tokens 为 2048,适合几分钟的短音频;SGLang Omni 服务的默认值是 5120,官方转写长录音的示例用到 65536。处理几十分钟的会议录音时,应当显式调大这个参数。
长序列优先用 flash-attn 或 sdpa
整段输入意味着模型要处理很长的序列,注意力的实现方式直接决定显存占用。官方给出的优先顺序是 flash-attn、sdpa、eager:在 CUDA GPU 上建议加装 flash-attn,没有安装时用 sdpa。eager 只作最后的兜底,它的显存占用会随序列长度平方增长,转写长录音时很容易显存不足。
用提示词加热词、调整输出格式
解码器本身是语言模型,任务要求通过提示词告诉它。默认提示词要求每段以起始时间戳和说话人编号开头、以结束时间戳收尾。录音里有产品型号、公司名称、人名、技术缩写这类专有名词时,可以在提示词末尾追加“热词提示:热词1, 热词2”,帮助模型写对这些词。
提示词也能改变输出格式。只需要区分说话人、不需要时间戳时,官方给出的写法是“转录为文本,使用 [S01] [S02] [S03]等说话人标签。”同一段提示词可以用在 Python 推理、字幕 Web 应用和命令行批处理工具中。
匿名说话人编号需要在业务侧映射
模型输出的 [S01]、[S02] 是匿名编号,只表示同一条音频里的第几位说话人,不代表具体是谁,换一条音频也不能对应到同一个人。要在会议纪要里显示真实姓名,需要业务系统结合参会名单或人工确认,把编号映射到人名。映射可以直接在 parse_transcript 解析出的说话人字段上完成。
需要结构化分段时选 SGLang Omni
部署成服务后,不同框架返回的结果形式不一样。官方推荐的 SGLang Omni 提供兼容 OpenAI 的转写接口,请求时把返回格式指定为 verbose_json,得到的就是按说话人分好的段落;默认的 json 格式只返回原始文本。vLLM 目前返回的也是带说话人标签的原始文本,需要自行解析。SGLang Omni 面向 CUDA 13 环境,CUDA 12 的服务器可以选 vLLM。
七、写在最后:把说话人和时间写进生成目标
回看整套架构,MOSS-Transcribe-Diarize 最根本的改变,是不再把“谁在说”和“什么时候说”留给后处理,而是让模型在写文字的同时一起写出来。三项关键设计各自解决了级联方案的一个老问题:联合生成去掉了模块之间的接力,误差不再逐级累积;文本化时间戳让时间成为模型能直接读写的锚点,录音再长也不容易算偏;128K 上下文让 0.9B 能整段输入约 90 分钟的录音,说话人编号不会在切片的接缝处断开。
这些设计的效果在长音频评测中得到了印证:AISHELL-4 会议集和 Podcast 访谈集都整段输入,MOSS-Transcribe-Diarize 0.9B 的 cpCER 和 Δcp 都排在官方对比的首位。
对使用者来说,多人转写不再需要把几个模型拼在一起:一次推理就能拿到带说话人和时间戳的文字稿,对齐、拼接和说话人匹配都可以省去。
想深入研究或按业务定制,可以从开源的 MOSS-Transcribe-Diarize 0.9B 入手,它公开了代码和权重,既能查看架构的实现细节,也能用自有数据继续微调。旗舰版 MOSS-Transcribe-Diarize Pro 依托更大规模的模型能力,在说话人区分和上下文理解上进一步增强,适合对准确率要求更高的场景。这个版本不开源,通过 MOSS API 以在线服务的形式提供,使用时无需自备算力。
关于 MOSS-Transcribe-Diarize 技术架构的常见问题
MOSS-Transcribe-Diarize 的编码器和解码器分别是什么?
开源的 MOSS-Transcribe-Diarize 0.9B 采用 Whisper-Medium 配置的音频编码器和 Qwen3-0.6B 风格的因果解码器,两者之间用“4 倍时间合并 + MLP 适配器”连接。编码器负责从音频中提取声学特征,解码器负责逐段写出带时间戳和说话人编号的文字。
MOSS-Transcribe-Diarize 的时间戳是怎么生成的?
时间戳由解码器直接以文本形式写出。在模型的输入中,格式化的时间戳文本被插在音频特征的各个分块之间,作为明确的时间锚点,所以长录音也能得到准确的段级时间戳。
用 MOSS-Transcribe-Diarize 转写长录音,需要先切片吗?
不需要。开源的 0.9B 支持 128K token 上下文,约 90 分钟的连续音频可以整段输入,同一位说话人在整段录音中保持同一个编号。转写长录音时,生成长度上限 max_new_tokens 要相应调大。
MOSS-Transcribe-Diarize 和“Whisper 加说话人分离模型”的方案有什么不同?
后一种方案由语音识别和说话人分离两个独立模型分别处理,再按时间把结果对齐合并,长录音通常还要先切片。MOSS-Transcribe-Diarize 用一个模型同时生成文字、说话人编号和时间戳,省去了额外的对齐和拼接步骤。
MOSS-Transcribe-Diarize 能处理多人同时说话的录音吗?
可以。模型的训练数据里专门加入了带重叠语音的模拟对话,重叠部分最多可占较短片段的 80%。输出时,两个人重叠的发言会分别记在各自的说话人编号下,两段的起止时间允许交叉。