随着大模型应用从单轮问答走向 Agent,系统需要处理的“历史信息”越来越多。一次任务中的上下文、过去的对话、用户长期偏好、历史决策,甚至某类任务中积累的经验,都可能影响 Agent 当前的判断。
如果把这些信息全部塞进上下文,不仅会持续增加 Token 消耗,也会让 Agent 受到越来越多无关历史信息干扰。因此,Agent Memory 的一个重要思路是:先对记忆进行分层,再为不同层级选择合适的存储和检索方式。
Memory 为什么要分层
不同类型的记忆,生命周期和访问方式并不相同。
原始对话、工具调用更接近短期记忆,通常只需要按会话和时间快速获取;用户偏好、历史事实和决策需要跨会话保存,并在后续任务中按需召回;场景经验通常与某类任务相关;用户画像则相对稳定,读取方式也更加直接。
可以按照使用特征,将 Agent Memory 简化为四个层级:
层级主要内容示例主要查询方式L0 会话记忆原始对话、Tool Call最近若干轮消息按会话、时间查询L1 原子记忆用户事实、偏好、历史决策“用户偏好 Python”全文、向量或混合检索L2 场景记忆某类任务的上下文和经验某类任务中的处理经验条件过滤 + 语义检索L3 用户画像相对稳定的长期信息长期偏好、目标等结构化查询
分层的意义并不只是把 Memory 分成几类,更重要的是:不同层级的数据,不需要使用完全相同的检索方式。

L0 更强调快速获取最近上下文;L1 需要根据当前问题召回相关事实和偏好;L2 往往需要先限定场景,再进行进一步检索;L3 数据相对稳定,可以直接按用户或类型读取。
瀚高数据库
如何支撑分层 Memory
Memory 分了层,并不意味着底层一定要拆成多套存储系统。
瀚高数据库(简称:HGDB)本身具备成熟的结构化查询、全文检索、索引和事务能力,结合 pgvector 等扩展后,还可以进一步支持向量相似度检索。
具体而言,HGDB 可以利用 B-tree 等常规索引支持 L0 会话记忆的快速读取;通过全文检索与向量相似度检索支持 L1 原子记忆的相关性召回;对于 L2 场景记忆和 L3 用户画像,则可以结合结构化查询进行精确定位,并根据需要扩展语义检索能力。
由此,不同层级的 Memory 无需依赖多套独立存储系统,而是能够在同一数据底座中选择适合自身访问特征的查询路径。这样既保留了关系型数据库擅长的结构化过滤,也能够满足 Agent 对全文和语义检索的需求。
分层也有助于控制检索范围
随着 Agent 长期运行,Memory 会不断积累。
如果每次都直接针对全部历史数据进行语义检索,参与检索的数据范围会越来越大。更合理的方式,是先利用确定性较强的结构化条件缩小候选集,再进行全文或向量检索。
例如,可以先按用户、Agent、Memory 类型和时间范围过滤,再在候选数据中执行全文或向量检索,最终只将相关性较高的 Top-K Memory 返回给 Agent。
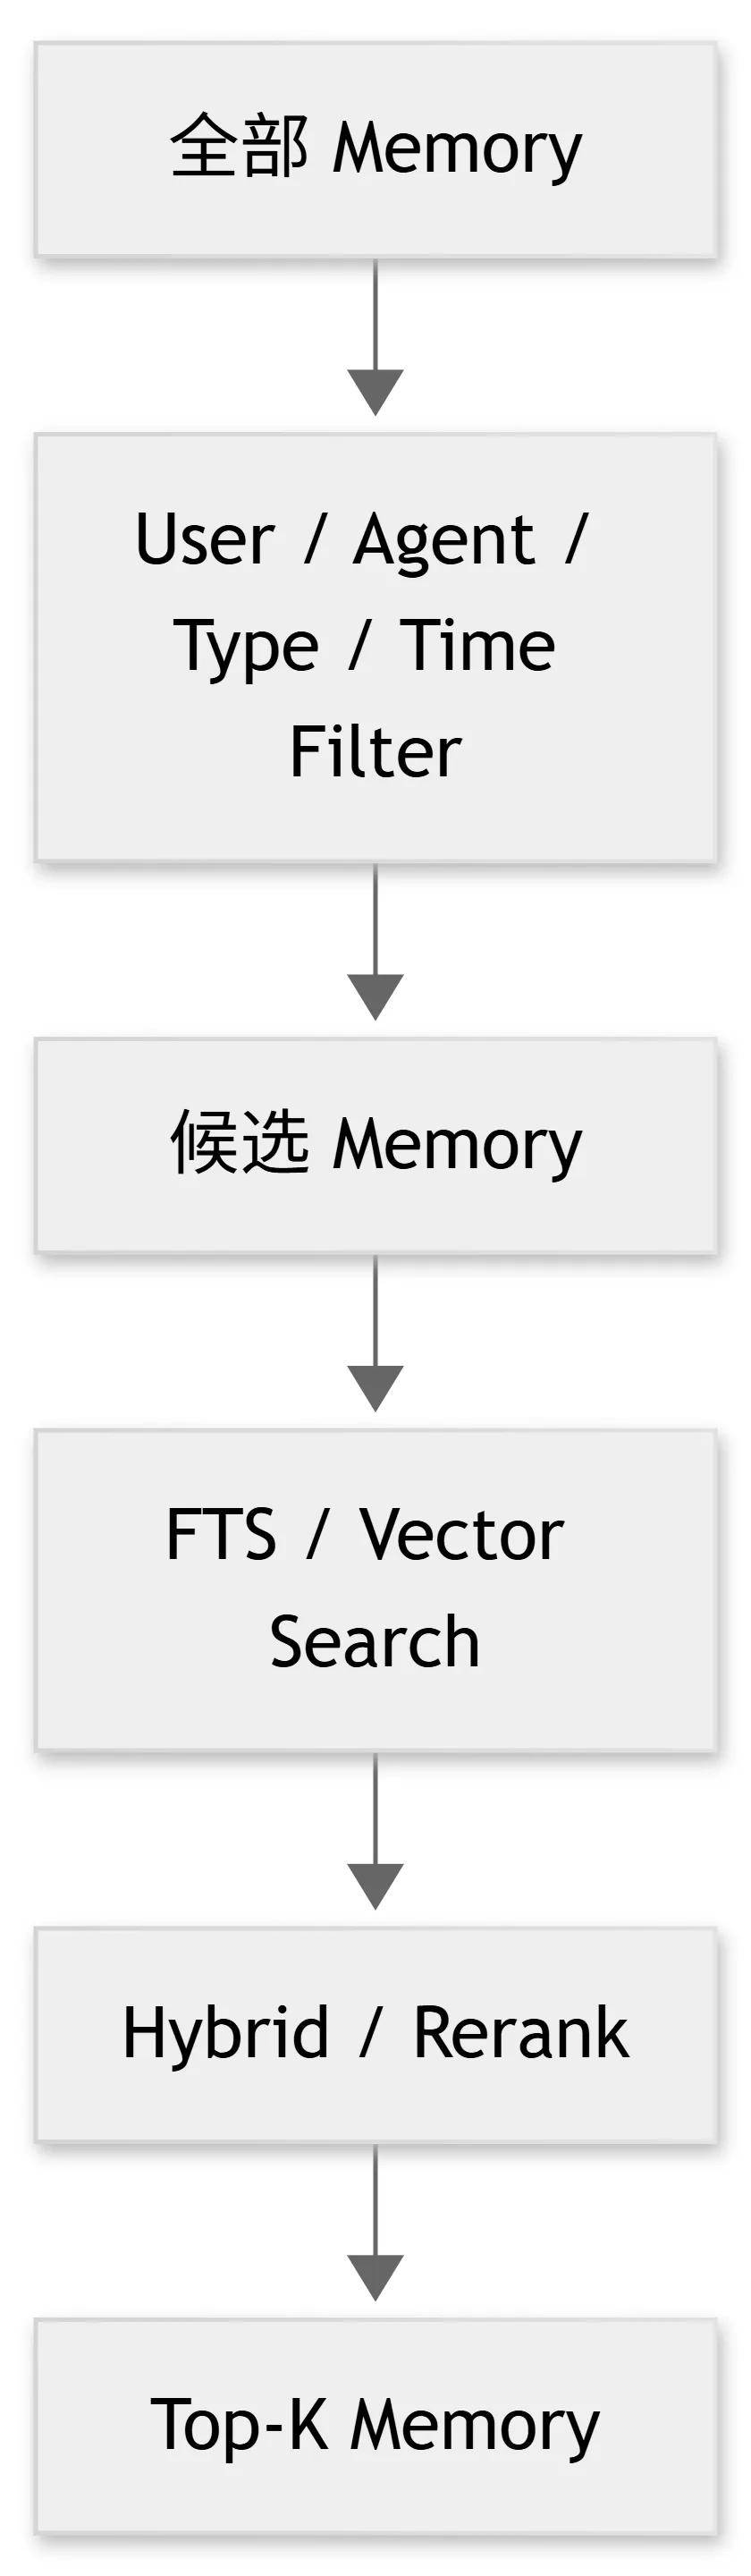
这种“先过滤,再检索”的方式,可以把成本更高的语义检索限定在更小的数据范围内,也是分层 Memory 架构控制检索成本的一种直接方式。
基于 HGDB 的 Demo 验证
基于这一思路,我们进一步构建了一个轻量级 Agent Memory Demo,对分层 Memory 在 HGDB 中的存储和检索方式进行了验证。
Demo 按照不同 Memory 层级设计了相应的数据结构,并分别验证了:
基于会话和时间条件的短期记忆查询;
基于全文检索的关键词召回;
基于向量相似度的语义召回;
将全文与向量结果结合的混合检索。
从 Demo 验证来看,基于 HGDB 的数据底座能够为不同层级的 Agent Memory 提供相应的存储与检索能力。通过合理的分层设计、索引组织和检索路径,可以在同一数据库体系内支持短期会话查询与长期记忆召回。
从数据库能力到 Memory 服务化
在分层存储与检索能力的基础上,Agent Memory 还可以进一步向服务化演进。瀚高推出的 HighgoBase(瀚高智能数据基座平台),以 HGDB/PostgreSQL 为核心,集成自动化 API、身份认证、实时订阅等后端能力,为 AI 应用和 Agent 开发提供了统一的平台基础。
可以结合 HighgoBase 将分层 Memory 的存储和检索逻辑封装为标准化服务,对 Agent 提供统一的记忆写入、检索与管理接口,进一步降低 Agent Memory 的开发和集成成本。
实践案例:
分层 Agent Memory 的存储与检索验证
为了验证分层 Memory 架构的可行性,我们构建了一套轻量级 Agent Memory Demo,将会话记忆、原子记忆、场景记忆和用户画像分别存储,并针对不同层级设计相应的查询方式。
- 分层存储与记忆召回
Demo 采用文中的四层 Memory 结构,以长期记忆检索为例,当用户询问“之前数据库的语义搜索准备使用什么实现?”时,系统可以从 L1 中召回相关历史记录:
本项目的向量检索采用 pgvector。第一版优先验证 Exact Vector Search,再验证 HNSW。Hybrid Search 组合全文检索和向量检索。
随后,系统可以将检索结果作为上下文提供给 Agent,使其能够参考历史技术决策完成回答。
这一用例验证了从长期记忆存储、相关内容召回,到上下文注入的基本流程。
- 向量检索性能验证
在功能验证基础上,我们进一步针对 L1 原子记忆进行了基础性能采样。
测试基于 HGDB 与 pgvector,在 10 万条模拟记忆记录上对比 Exact Vector Search、HNSW、全文检索以及两路组合查询的延迟。
查询方式P50P95Exact Vector130.03 ms156.21 msHNSW Vector0.46 ms1.02 ms全文检索 FTS19.03 ms20.37 msFTS + Vector 两路查询24.27 ms27.89 ms
注:以上为指定测试环境下的单并发请求下的查询耗时,不包含 Embedding 生成、RRF 排名融合及大模型调用,不能代表完整 Agent Memory 检索链路的端到端延迟。
测试表明,在本次数据规模及查询条件下,HNSW 索引能够显著降低向量检索延迟,全文检索与向量检索也能够在同一数据库中组合使用。
- 验证结论
通过上述 Demo,我们验证了分层 Memory 的基本存储和检索流程:不同层级根据访问特征选择合适的查询路径,长期记忆则可以结合全文检索与向量检索完成相关信息召回。
这一实践为基于 HGDB 构建统一的 Agent Memory 数据底座提供了技术参考。