AI越来越强,而限制它进一步发展的,不再是算力,而是算力之间传数据的那根线——线不好,算力可能只能发挥30%的作用。
AI大模型需要几百上千颗算力芯片不停交换数据,数据交换的效率高不高,直接决定整个系统的计算能力。以前,这根线一直是铜的,可铜对于AI而言有个致命缺陷,它走不远,超过2米信号就糊了。随着计算芯片越做越大,机柜越排越密,铜的这一缺陷暴露地越来越彻底。
业内有一个公认的方向——“光进铜退”,让光代替铜去扛越来越重的数据搬运。
这场“换挡”,中国比美国更急。
中国单颗芯片的算力拼不过美国,就更迫切地想用光实现“高速互联”,把数百颗芯片“焊”成一个整体,然后让它像一个超级芯片一样协同计算。这就是被称为超节点的单一计算逻辑系统。
目前,国内外芯片公司都在做超节点。英伟达一个超节点装下72个GPU;而国产GPU卡算力不足,要凑出同等算力,需要堆几百张卡,铺多个机柜。机柜一多,芯片之间就必须靠光连起来,因为铜缆在高速信号下衰减严重,跨机柜只能改用光。光互联由此成为刚需。
单个算力越不够,堆的卡就越多,对光互联的需求就越大。所以,国内的超节点,上光互联的决心比海外更大。
要说这根“数据线”有多值钱,可以看博通。这家市值数千亿美元的巨头,在用铜传电信号的时代,做以SerDes为代表的交换芯片,定义了芯片间的连接标准,赚了几十年的高利润,占据全球商用交换机芯片市场约70%-80%的份额。
由此可以理解,AI时代,谁能定义芯片之间怎么连,谁就能握住AI基础设施中“最肥”的一环。
芯界光核想做的,就是光互联时代的“博通”,而且聚焦超节点内部的光互联。公司规划了两条产品线,覆盖其中最核心的“连”和“交换”两个部分。
一是超节点内的光引擎,负责把电信号翻译为光信号。当前主流形态是可插拔光模块,中际旭创等上市公司已有布局;芯界光核则瞄准光引擎CPO(采用3D光电共封),计划于2027年初向潜在客户送样,此后将进一步研发再下一代产品OIO。
二是超节点内的光交换芯片OCS,负责让光路在芯片之间灵活切换,是目前国内少数采用硅光集中式大矩阵的技术路线。
在应莺的终局里,光在超节点内完全替代电。若把超节点内的数据通信比作新修高速公路,目前主流的可插拔光模块是把高速公路修在城郊,下一代光引擎CPO是修在市区,终局设想的光引擎OIO是修到每家每户。这是“连”。而高速路的每一个枢纽上的立交桥,就是OCS。这是“换”。连和换,就是她眼中的全光互联的终局。

芯界光核成立于2026年1月,不到一年已完成两轮亿元级融资,投资方包括元禾璞华、毅达资本等。这家公司的底气,来自一支"产学研"配置完整的团队。
联合创始人应莺和史博是北大计算机系同窗,一个懂战略、一个懂供应链,都有二十多年产业界经验,曾任职于IBM、赛灵思等国际公司;技术班底则来自上海交大光子传输与通信全国重点实验室——陆梁军教授主攻光交换,李雨副教授主攻光引擎,实验室副主任、长江学者周林杰把握前沿方向。

芯界光核联合创始人兼CEO应莺
他们的定位很明确,从终局而言,他们要做光互联时代的博通。
中国光互联的需求比国外更强
创业邦:你们创始团队,其实有5位,其中一位对外提及得较少是吗?
应莺:对,还有一位周老师,也算我们的创始成员。他叫周林杰,是我和史博的本科同学。我们三个本科都就读于北大计算机系。周老师现在是上海交大光子传输与通信全国重点实验室的副主任。
创业邦:你们和上海交大是怎么建立合作的?
应莺:通过周老师,我们和交大建立了合作。陆梁军和李雨老师,都是周老师课题组里的人。周老师目前也是公司的首席科学家。
创业邦:你们说核心团队的价值观匹配,具体体现在哪里?
应莺:我们每个人都是合作性比较强的人。像我们这样优势互补,合作紧密,是团队的优势。
创业邦:投资人投第一笔钱,看中的是什么?
应莺:早期投资人看的就是团队,觉得我们几位老师的技术背景扎实,又觉得我和史博有商业化经验。投资人认为我们很落地。概括起来:我们整个团队给投资人的感觉,是既能仰望星空,又能脚踏实地。
创业邦:投资人认为你们能够脚踏实地的原因是什么?
应莺:我和史博是产业界出来的,有二十多年经验,想得比较清楚:第一是有所选择,只做自己擅长、且符合产业方向的事,而不是什么都碰;第二,怎么推进大客户、怎么把握生态位、怎么整合供应链、怎么推进产品节奏,这些在公司成立之前我们就提前想好了。
创业邦:是什么让你认定,创业这件事值得在去年下场做?
应莺:AI这波浪潮,一定会带来AI大基建、也就是数据中心的爆发。美国"七姐妹",还有国内头部的云厂商,每年在数据中心上投入上千亿甚至上万亿元。这是一个巨大的市场,而且利润非常高。数据中心里单个产品的毛利普遍超过50%。
创业邦:数据中心这么大,为何选了光互联这一块,而且是下一代?
应莺:这是一个大赛道的早期阶段。因为数据中心的卡点,已经不完全是算力,反而很多时候卡在互联上。而互联过去一直用铜,铜传输超过两米,信号完整性就会受影响;光不一样,传输再远损耗都很小。所以"光进铜退"是公认的方向。可插拔光模块是上一代,我们做的是密度更高、带宽更高、功耗更低,替代可插拔光模块的下一代光互联产品CPO(共封装光学)。
创业邦:这是一个宏观趋势,但有没有什么具体的信号,让你觉得现在必须干?
应莺:有两个。一个是海外英伟达这两年猛推CPO,这是一个明确的信号。另一个是基于我们自己对中国市场的判断:国内对光互联的需求,可能比海外还强。
创业邦:国内对光互联的需求,怎么会比海外还强?
应莺:有两股驱动力。第一股是技术短板反而逼出了需求。现在智算服务器主流的方案里,信号从GPU出来,要经过两颗很难的芯片:一颗是SerDes,负责把信号高速送出去,全球高端市场基本被博通垄断,海外能做到单通道400G,我们还在100、200G;另一颗是DSP,因为光模块离GPU有二三十厘米,信号在铜线上衰减得厉害,必须靠它补偿。这两颗芯片,恰恰都是国内的两大短板。
创业邦:那么你们研发的第一代光引擎是CPO,是否可以绕过这两大短板?
应莺:是的。CPO的妙处,就是把DSP这颗短板芯片从架构上绕过去。它把光引擎直接和GPU封装在一起,距离压到5毫米以内。距离一短,两件事同时发生:铜走线没了,信号不会衰减,DSP就不需要了;传输距离短了,对SerDes性能的要求也降下来,我们本来不够用的SerDes,在这个方案里反而够用了。这样一来,竞争焦点就从"谁的SerDes快、谁的DSP强",转移到了"谁能把光引擎做好"——一个全新的战场,大家起跑线更接近。所以对国内来说,CPO不只是技术选择,更是一次换道超车的机会。
创业邦:第二股呢?
应莺:第二股是超节点。我们的单卡算力比英伟达差很多。英伟达一个机柜就能做一个超节点,NVL72一个柜里放72个GPU;在国内,华为推出的超节点Matrix384,但384卡得十几个机柜,就必须上光互联,铜到不了。所以,无论是华为还是其他带头企业,都在超节点内部坚决上光互联。
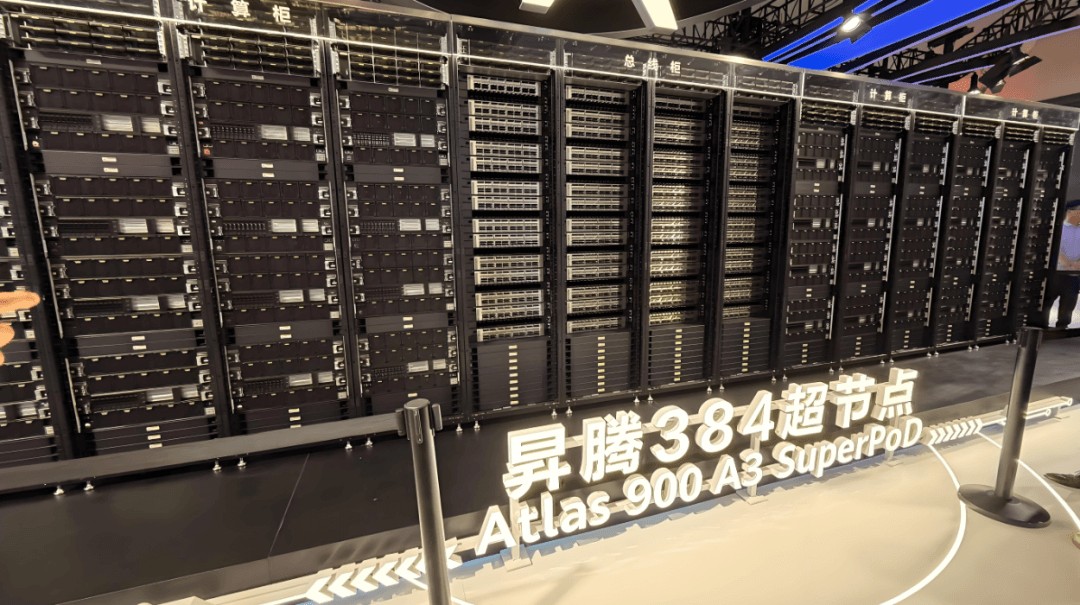
华为Matrix384超节点
创业邦:旭创、新易盛这些大厂,已经做了可插拔光模块,它们也在做下一代光互联光引擎CPO,为什么有机会给到创业公司?
应莺:这里有个很关键的点。旭创这一代,核心能力在整个光模块这个层面,但在底层器件层面,这些大厂并不占优势。它们早期很多供应链来自海外,是客户指定的——英伟达指定光芯片用谁的、DSP用谁的,它们就负责把这些精密组件以很高的质量集成到一起。
创业邦:那这种"大厂难转身"的背后,本质是什么?
应莺:传统光模块厂商擅长器件集成,但硅光PIC芯片自研、3D光电合封架构定义是新能力,存在转型挑战。我打个比方,新能源车都是创业公司做起来的,为什么宝马、丰田转得慢?因为从燃油车转电动车,是在革自己的命。
创业邦:你们判断国产超节点会比国外发展得更快么,依据是什么?
应莺:我们觉得国产超节点有可能比国外快,是有可能的。依据是几件事叠在一起:一个是SerDes和DSP的双重驱动,这个前面讲过;更重要的是,我们的GPU算力不够,只能去堆板卡数量。板卡一多,就形成了大规模的超节点,必须上光互联。所以国产超节点上CPO、上光互联的动力,反而更强。
创业邦:有意思的是,英伟达做超节点,好像是为了一个相反的原因?
应莺:对。英伟达是算力太强了,强到单颗GPU旁边的内存跟不上了,它做超节点是为了解决内存不够,做内存池化。我们正好反过来,是算力不够,堆板卡。所以两边超节点里看重的东西不一样。他们更看重内存扩展,我们更看重板卡数量,而板卡一多,互联的需求就上来了。铜互联的效果又不如光互联,所以国内对光互联的需求,可能比海外还多。
创业邦:这个"需求更多",多到什么程度?能落到一个判断上吗?
应莺:有时候在某些场景、某些模型下,算力只能发挥出30%,剩下70%是因为互联不够被浪费掉的。从这个角度看,互联的价值量其实非常大,在某些场景下,甚至可能超过GPU本身。
“连”和“交换”一起做是行业终局
创业邦:你们做的,到底是哪一个层面的光互联?
应莺:我们做的是超节点内部的光互联。这里要先讲清楚一个前提。超节点就是刚刚兴起的下一代场景:一个把大量计算芯片通过互联组成单一逻辑系统的形态。我们两条产品线,光引擎和OCS,都落在这个场景内部。不是数据中心顶层那种网络:把一台台已经建好的机器再通过交换机连起来的那种。
创业邦:不要把光引擎和OCS理解成两个独立的产品,为什么一定要一起做?
应莺:我先说清楚一点,这两样东西其实可以是独立的产品。现在很多创业公司,有的只做OIO(GPU侧CPO的下一代产品),有的只做OCS,都能成立。但如果把它们放在一起设计,它就更占优势。
光从这颗芯片传到那颗芯片(这里的芯片指超节点内部的GPU、NPU等计算芯片),损耗是沿途几段叠加的。只做一段,只能顾好自己那段;两段一起做,才能在中间统一调配,把损耗降到整条链路最低。
虽然光引擎和OCS的具体设计思路完全不同,但它们底层的器件结构、制造工艺平台、封装技术、部分设计IP是高度通用的。
创业邦:这个"两边一起设计"的协同,是不是也指向你们更远的终局?
应莺:对。我们对未来的设想是,超节点内的“全光互联”,中央机柜交换机采用OCS,GPU与GPU,GPU与存储,GPU与OCS之间,全部用OIO。我们对未来终局的一些方案里,比如我们用微环做OIO,再用微环做OCS,这是一整套技术方案,必须一起做,不可能拆开做。全光互联这件事,最核心的两个东西就是"连"和"交换"——连是光引擎的事,交换是OCS的事。“连”和“交换”,就是“全光互联”的全部。
创业邦:你们提"全光互联平台"这个概念,可以理解为一套"技术全家桶"——把光互联里要用到的核心部件,做成一个可以灵活组合的整体。客户可以分别要光引擎或OCS,也可以要整套超节点互联方案。最早的灵感从哪来?
应莺:来自海外一家叫Celestial AI的公司。它今年年初以55亿美元的对价被Marvell收购。它做的其实就是一个"全光互联平台"式的概念:手里有一系列的光互联技术,既做光引擎,也做OCS。Marvell愿意花这么大价钱买它,就是看中了这套东西。我们最初"全光互联平台"的想法,就是受它启发。
创业邦:那它的结局是被收购,你们的终局呢?
应莺:我们想做上市。
创业邦:光引擎会比光交换的商业化来得更早。既然商业化有先后,研发的精力分配,是怎么排的?
应莺:短期内真正能量产的产品,我们判断是GPU侧CPO的光引擎。OCS的大规模商业化还早,实话实说,甚至可能比CPO的下一代产品OIO还要晚。所以研发上我们也有侧重。光引擎占大头,OCS现在占我们大概三成的研发力量,是布局的心态。
创业邦:先聊光引擎这条线。你们的节奏,我理解是第一代先做一个能尽快落地的产品,2027年初送样3D光电合封CPO,远期再上更高密度的下一代OIO。那第一代为什么选MZ这条更成熟的路线,而不是很多人看好的微环?
应莺:我们的技术路线其实是有争议的。很多人觉得微环是未来的终极方向,会问"你们为什么还要走中间这一段MZ路线"。答案就是量产性。
这里先解释一句:MZ和微环,说的都是光引擎里负责把电信号"翻译"成光信号的那个核心器件。MZ是成熟的老路线,做得大,但稳、好量产;微环是新一代,体积小,功耗低,但难做——它对工艺的精度要求高到离谱,稍微差一点,光信号的波长就跑了。
所以我们的判断是:微环在两三年内很难做到大批量量产,但我们现在要做的,是一个两三年内就能量产的产品。这不是我们一家的判断,是整个产业界的考虑。
有意思的是,北美大厂早前一直在推微环方案,英伟达也是,但实际上英伟达现在也开始用MZ来做它下一代的CPO了。为什么退回来?还是量产性,理论上的"最优",在量产面前是要让位的。
但对于我们公司而言,光引擎产品线的第一代产品CPO,会采用MZ路线。之后,我们研发第二代产品OIO,会采用微环路线。

从光模块到CPO到OIO的技术演进示意
创业邦:外界有个说法,说你们如果做出来,会是国内第一家做出这种3D封装结构CPO光引擎、且是可量产方案的公司。这个"3D"的分量在哪?
应莺:先澄清一下,这个说法有前提——"如果做出来""希望成为",产品还没出来,我们不会把话说满。但方向是这个方向。我们将在2027年初向客户送样。
它的分量在于,在此之前主流的方案是2D或者2.5D,把光电从并排做到垂直堆叠,密度上去了、功耗下来了、散热也更好,是面向下一代的可迭代路径。这在国内还是空白。
我们希望它落地之后,能给国内超节点一个不依赖海外封闭体系的互连选项。国内超节点靠堆板卡数量,卡之间必须有互联,互联不够算力有六七成发挥不出来,在某些场景下互联的价值量甚至可能超过GPU本身。
创业邦:芯片和光引擎的配比,现在是怎样的?
应莺:现在一般至少是1:2或1:4的关系,一颗GPU配两个甚至四个光引擎。将来是不是往1:1走,不好说,因为算力在涨,光引擎的密度和带宽也在涨,要看谁涨得更快。我们判断光引擎这边可能还更容易一些,因为算力提升受制裁制约,光引擎的带宽提升反而空间更大。所以,未来比例可能趋向于1:1,即单个光引擎就能把单个芯片计算的数据进出全包了。
创业邦:再聊OCS这条线。你们选了硅光集中式大矩阵这条路线,国内创业公司里走这个方向的主要就是你们。为什么这么选,而不是做分布式,或者像其他家做MEMS?
应莺:先看数据中心的解决方案,不管国内国外,主流方案都是集中式大矩阵。分布式方案,其实没有什么太多应用案例。
创业邦:MEMS今天已经有需求了,你们选择了硅光?
应莺:对,现在做MEMS的OCS,今天就有需求。但这里要分清两个场景。MEMS是用在数据中心顶层的,它的插损比较低,但它做的是慢光交换,切换速度慢、成本又高,所以适合放在顶层去做全域调度。我们是做快光交换,它适合用在超节点内部。
创业邦:采用这一技术路线,最硬的技术挑战是什么?
应莺:最主要的问题是插损,就是光在里面每拐一次、每过一个节点,都会损耗一点。这是它天生的物理特性决定的。这个开关的工作原理,注定了光要穿过很多个节点才能完成一次交换,穿得越多,损耗越大,最后可能就弱到没法用了。这是这类技术最头疼的地方,很难根治。
只能想办法缓解:一是把结构调得更优;二是在开关单元上换新材料,让损耗小一点;三是像海外同行那样,在链路里加"补光"的放大器。具体我们用什么办法,是技术机密,不便透露,但这几条是研发界都在考虑的路。
创业邦:你们目前正研发32端口的OCS芯片,32端口这个规模,到什么难度了?
应莺:我们一颗32端口的芯片,上面有2000个开关单元。在物理层面把"严格无阻塞"做出来,已经很难了。这意思是,任何一条空闲的通道,随时都能连上,不用先把别的连接拆掉。但这只是第一步。真正难的还在后面:当十几二十条光路同时开着的时候,怎么让它们之间互相不干扰、不打结,这要靠算法去调度。所以芯片和控制系统、调度算法,都是我们自己做的。
创业邦:既然OCS落地比光引擎还晚,为什么现在就要做?
应莺:这是布局。硅光OCS这条路线全球都还在比较早期,没有成熟的大厂在做,全是创业公司,海外那几家也是高校院所出来的。我们现在就开始布局,先把位置占住。至少两年以后才会有一些小批量。
要做光互联时代的“博通”
创业邦:你们的竞争对手,前有中际旭创这样的大厂,后有不断冒出来的新创业公司,你们把自己放在哪个位置?
应莺:有人会拿我们跟中际旭创比,这个对标其实不太合适。长期来讲,我们对标的是博通这样的大厂——做互联领域的头部玩家。只是博通是电互联时代做交换、做互联,我们是做光交换时代,我们想做光交换时代的博通。
创业邦:你们跟一些创业公司都宣称支持开放生态。那么如何理解这种开放生态?
应莺:我们肯定是支持开放生态的。但坦白讲,生态不一定有大家想象的那么开放。我举个最简单的例子:光模块已经是接口最标准化、生态最开放的品类了,可实际上每家光模块厂都有自己的头部大客户。这个头部大客户就买某家公司的,不买别人家的。
创业邦:那你们的客户,具体是哪一类?华为这种全闭环的,是不是你们的目标客户?
应莺:华为偏向闭环,不是我们的客户。我们找的是开放生态的、想做超节点、但自己又不做光互联的GPU或者CSP自己的GPU厂商,这些才是我们的客户。有意思的是,谷歌反而可以是。大家说谷歌也是闭环,但它自己并不生产OCS,会开放一部分生态给外面。所以闭环和闭环也不一样。
创业邦:你们有光引擎和OCS,这两条产品线,具体怎么卖出去?
应莺:光引擎这条线,初期就是卖GPU侧的光引擎。客户把光引擎拿去,跟它自己的GPU合封成一个CPO。合封这个动作是客户做的,因为GPU在它手里。我们提供的是光引擎,一个指甲盖大小的东西,就能替代好几个可插拔光模块。但它是为客户定制的,不是通用件。
OCS这条线不一样。现在国内还没需求,只有谷歌、英伟达这些会开放送样的机会。我们的打法是,把芯片流片出来、把系统设计出来——芯片和控制系统、调度算法都是我们自己做的——然后找整机厂做成整机,先给北美客户送样,之后才有联合研发、做定制化的机会。
创业邦:那终局呢?
应莺:到终局,两个产品才会合成一整套解决方案——必须同时用我们的光引擎和OCS。但物理上不是一个盒子交给客户,而是我们把核心组件给服务器厂商,由它做成机柜。