用人话讲明白方差齐性检验
详细原理与Dabbit AI 工具实现
目录
1前言与算法简述
2方差齐性检验过程
3案例以及工具实现
1 前言与算法简述方差齐性检验常出现在t检验和方差分析的结果里,用来判断不同组总体的波动程度是否相同。这个说法有点抽象,拿买奶茶举个例子。
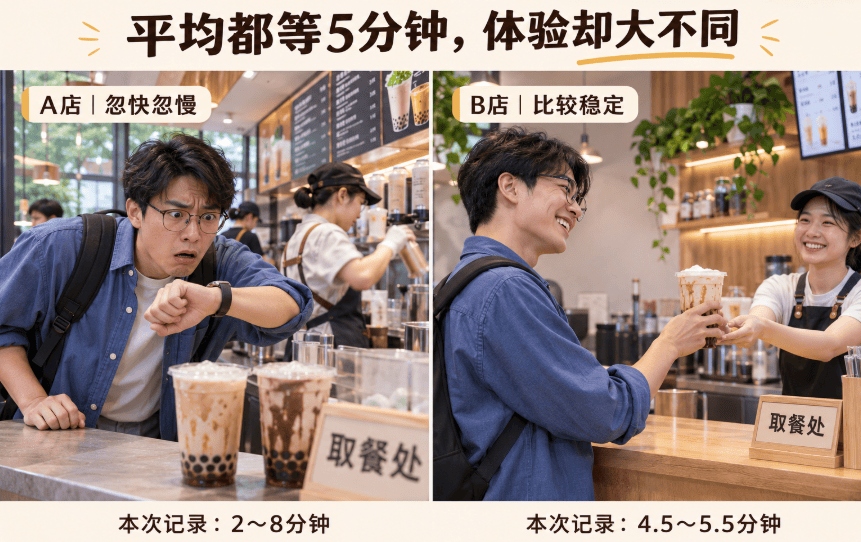 小赵午休只有半小时,公司楼下两家奶茶店都说“平均5分钟出杯”。他先去了A店,上次刚付完钱就拿到了,这次却等到手机都刷了两轮,奶茶还没封口。朋友去了B店,通常都是五分钟上下。
两家的平均速度差不多,等起来的体验却很不一样。对赶着回去打卡的小赵来说,能不能大致知道要等多久,也很重要。
这就引出了今天的问题,两家店出杯时间的波动程度,有没有差异?下面用每家15笔模拟订单,先把方差算明白,再用DabbitAI做一次方差齐性检验。
2 方差齐性检验过程本例按这条顺序分析。
按门店分组→ 查看均值和方差 →计算相对组中位数的绝对偏差→ 检验偏差大小的组间差异→ 结合p值与图形解释
2.1 均值接近为什么体验会差这么多
先拿一个更小的例子。A店三笔订单分别等了2、5、8分钟,B店分别等了4.8、5.0、5.2分钟。
两家平均都是5分钟,但A店可能让你惊喜,也可能让你着急。B店每次都在5分钟附近,时间比较容易预估。
要把这种“忽快忽慢”变成一个数,可以计算方差。先求每个数离均值多远,再把这些距离平方、相加,最后除以样本量减1。
样本方差s² = Σ(xᵢ− x̄)² ÷ (n − 1)
A店的方差= [(2−5)²+ (5−5)² + (8−5)²] ÷ 2 = 9
B店的方差= [(4.8−5)²+ (5−5)² + (5.2−5)²] ÷ 2 = 0.04
方差越大,表示样本相对自身均值越分散。对方差开平方,就得到标准差。这个小例子里,A店标准差为3分钟,B店为0.2分钟。
标准差的单位与原始数据相同,是分钟。方差的单位是分钟²,解释具体波动时,标准差通常更直观。
2.2 什么叫方差齐性
方差齐性指不同组总体的方差相等。手里只有每家15笔订单,样本方差几乎不可能刚好一样,因此需要检验,判断观察到的差别是否提供了反对总体等方差假设的证据。
本例的原假设H₀为两家店总体方差相等,备择假设H₁为两家店总体方差不相等。
提前设定显著性水平α= 0.05。如果p< 0.05,就拒绝原假设。如果p≥ 0.05,就没有足够证据拒绝总体等方差假设。
2.3 Levene检验怎样比较波动
本次采用以组中位数为中心的Levene检验,也叫Brown-Forsythe形式。它先把原始时间转换成距离,再比较这些距离的组均值。中位数中心版本通常更能适应偏态等情况。[1]
第一步,分别找到各组的中位数。
第二步,计算每笔订单与本组中位数相差多少,取绝对值。
zᵢⱼ= |xᵢⱼ − 本组中位数|
第三步,对这些绝对偏差做单因素方差分析。
回到刚才三笔订单的小例子,两店中位数都是5。A店变成[3,0,3],B店变成[0.2,0,0.2]。转换以后,很容易看出A店的订单通常离组中心更远。
实际30笔订单的两组中位数也都是5分钟。A店2.5分钟那笔,绝对偏差是2.5分钟。B店4.8分钟那笔,绝对偏差是0.2分钟。每笔都这样算,才进入后续检验。
2.4 检验统计量怎样得到
设一共有k组、N个观测值,每组绝对偏差的均值为z̄ᵢ,所有绝对偏差的均值为z̄。
组间平方和= Σ nᵢ(z̄ᵢ− z̄)²
组内平方和= ΣΣ(zᵢⱼ− z̄ᵢ)²
F= [组间平方和÷ (k−1)]÷ [组内平方和÷ (N−k)]
可以这样理解,分子衡量各组“平均偏离中心多少”的差别,分母衡量同一组里这些偏差本身有多大起伏。
本例A店的绝对偏差总和为23.5,平均为1.5667分钟。B店总和为3.0,平均为0.2000分钟。全部30笔的平均绝对偏差为0.8833分钟。
使用完整精度计算,组间平方和约14.0083,组内平方和约14.0813。
F≈ (14.0083 ÷ 1) ÷ (14.0813 ÷ 28) = 27.8544
这里两组、总样本量30,因此自由度分别为k−1= 1和N−k= 28。
注意,算法在这一步使用绝对偏差的组均值。输出表里的MAD是绝对偏差的中位数,两者需要区分。
2.5 p值怎样读
软件根据F统计量和自由度,得到p值约0.000013,即1.30× 10⁻⁵。它小于0.05,因此拒绝两店总体方差相等的原假设。[1]
这说明两家店的波动程度存在统计显著差异。哪家波动更大,还要结合标准差、方差和图形判断。
p值也不能告诉我们差异有多大,所以接下来同时看标准差比等描述指标。
3 案例以及工具实现3.1 案例介绍两家奶茶店谁更稳定
本次使用30笔教程模拟订单,每家店15笔。每行是一笔订单,“门店”为分组变量,“出杯时间(分钟)”为检验变量,“订单编号”仅用于标识。
上表为便于阅读并排展示,上传文件使用门店、订单编号、出杯时间三列。全部30条记录有效,无缺失或非数值时间。同一家店有几笔订单时间相同,订单编号不同,仍分别保留。
3.2 使用工具与案例操作
第一步,进入DabbitAI的SPSS工具箱,选择“方差齐性检验”,上传数据。
第二步,输入分析要求,说明门店用于分组、出杯时间用于检验,以中位数为中心的Levene检验作为主检验,显著性水平设为0.05,输出分组描述统计和箱线图,并叠加订单散点。
第三步,核对参数后开始分析。
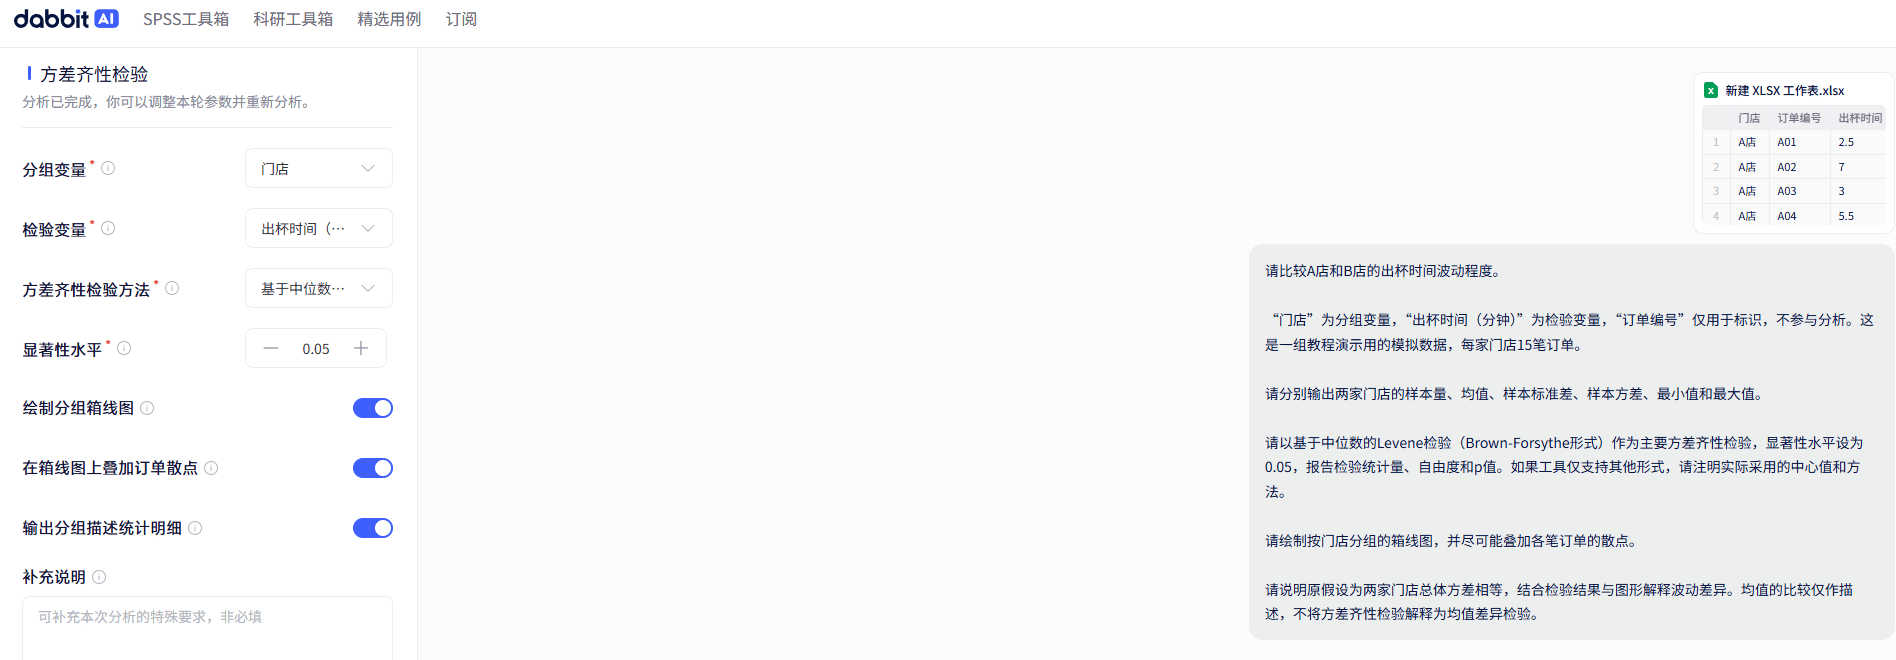
图1方差齐性检验参数配置
3.3 分析结果解读
输出结果1分组描述统计
时间、均值、标准差单位为分钟,方差单位为分钟²。

图2两店分组描述统计
两店平均时间只差0.1分钟,也就是6秒。单看平均数,小林可能觉得差不多。但A店最短2分钟、最长8分钟,跨度6分钟。B店在4.5~5.5分钟之间,跨度1分钟。
A店样本标准差约1.88分钟,B店约0.29分钟,前者约为后者的6.43倍。样本方差比则约41.33倍。两个倍数分别描述标准差与方差,引用时要分清。
两店中位数均为5分钟,MAD分别为1.5分钟和0.2分钟,从另一个尺度上也显示A店更分散。
输出结果2箱线图与订单散点

图3分组箱线图及波动指标对比
上方箱线图中,A店的箱体与须线更长,订单散点从2分钟铺到8分钟。B店的散点则围绕5分钟聚在一起,箱体明显更窄。
图里的红色虚线标记组均值。两条虚线位置很接近,但周围散点的分散程度差别很大,正好对应“平均都差不多,等起来却不一样”。
下方左图对比标准差,右图展示各订单相对组中位数的绝对偏差。A店有不少点离中心较远,B店大多贴近中心,与描述统计方向一致。
输出结果3方差齐性检验
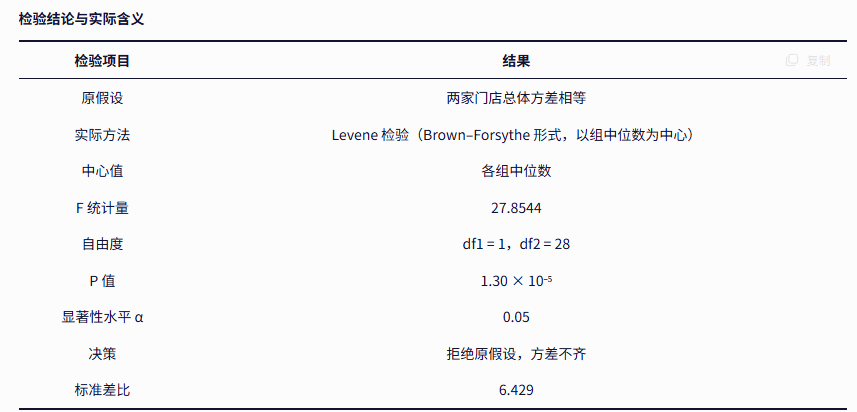
图4方差齐性检验结果
p值小于0.05,拒绝两店总体方差相等的原假设。结合样本标准差和箱线图,A店的出杯时间波动明显大于B店。
这里比较的是波动程度,两家店平均速度是否有差异,需要另外做均值比较。如果之后要比较两独立组均值,可结合研究设计考虑Welcht检验。
3.4 小结
可以把本次结果整理成下面这段话。
“对两家奶茶店各15笔模拟订单进行分析,以组中位数为中心的Levene检验结果为F(1,28)= 27.8544,p= 1.30 × 10⁻⁵。在α=0.05水平下拒绝总体等方差假设。A店样本标准差为1.8822分钟,B店为0.2928分钟,结合箱线图与订单散点,A店出杯时间的波动程度更大。”
回到午休买奶茶的场景,A店可能两分钟给你一个惊喜,也可能让你等到第八分钟。B店这批记录更集中,出杯时间更容易预估。
这些都是模拟数据下的演示结果。真实门店的差异原因还需要看饮品类型、订单杯数、排队和人员配置,单凭这次检验无法判断具体原因。
3.5 常见问题
方差不齐是不是说明A店更慢?
A店在本例的平均时间反而略短。方差不齐说明波动存在差异,不能据此判断平均速度。
p值大于0.05就能说方差完全一样吗?
应表述为没有足够证据拒绝等方差假设。每组样本较小时,检验发现差异的能力也可能有限。
方差齐性检验和正态性检验有什么区别?
正态性检验关注分布形状,方差齐性检验关注不同组总体的离散程度。两组即使都近似正态,也可以有不同的方差。
真实订单需要注意什么?
尽量使用可比的采样条件,并检查订单间的相关性。连续订单可能共享排队或设备状态,存在相关结构时,需要采用适合这种设计的方法。
方法参考[1]SciPy官方文档Levene检验https://docs.scipy.org/doc/scipy/reference/generated/scipy.stats.levene.html
案例结果与截图来自本次DabbitAI方差齐性检验导出文件。全部订单为教程模拟数据。软件原始图表的标题重叠处保留原样。